
服务器丢失磁盘,本质是磁盘从“系统可见列表”里消失,真正物理损坏的比例并不高,多数是链路层或配置层出了岔子。一块盘可能前一秒还在RAID组里,后一秒就变成“Foreign”或“Offline”,重启后又回到阵列,这种反复“诈尸”最磨人,搞清楚它为什么消失,比盲目换盘更重要。
丢盘第一现场:系统日志比人先知道
磁盘不会无理由“失踪”,多数情况下,内核早就把线索写在日志里,只是被人忽略了,排查丢盘,第一步不是拆机柜,而是看日志。
用dmesg找内核层面的报错
登录服务器后,先执行:
dmesg -T | grep -E 'error|I/O|fail|reset'如果看到类似“I/O error”或“reset failed”的连续刷屏,说明磁盘在链路层已经失联过,常见的三组信号:
- ATA bus error:多半是SAS/SATA线缆或背板接口松动,也可能是供电波动。
- Buffer I/O error:底层读写出错,文件系统在努力重试但最终放弃。
- sd 0:0:2:0: device not ready:盘被系统判定为“不在场”,常见于硬盘掉电或固件卡死。
用smartctl看硬盘自我评级
硬盘内部有一套SMART健康档案,丢盘前往往已经有预兆:
smartctl -a /dev/sdb重点看三项:
- Reallocated_Sector_Ct(重映射扇区数):如果数值持续增长,说明盘面物理坏道正在扩散。
- CRC_Error_Count(接口CRC错误计数):这项过高,指向线缆、背板或接口接触不良。
- Current_Pending_Sector(待映射扇区数):不为零时,故障概率已经很高。
系统日志能定位“什么时候丢”,SMART能解释“为什么要丢”。
硬件层面:磁盘“离奇失踪”的物理原因
排除软件因素后,把目光放回机房物理环境,丢盘最常见的物理推手,就藏在连接、供电、温度三个细节里。
接口、背板与线缆:松一下就是“幽灵盘”
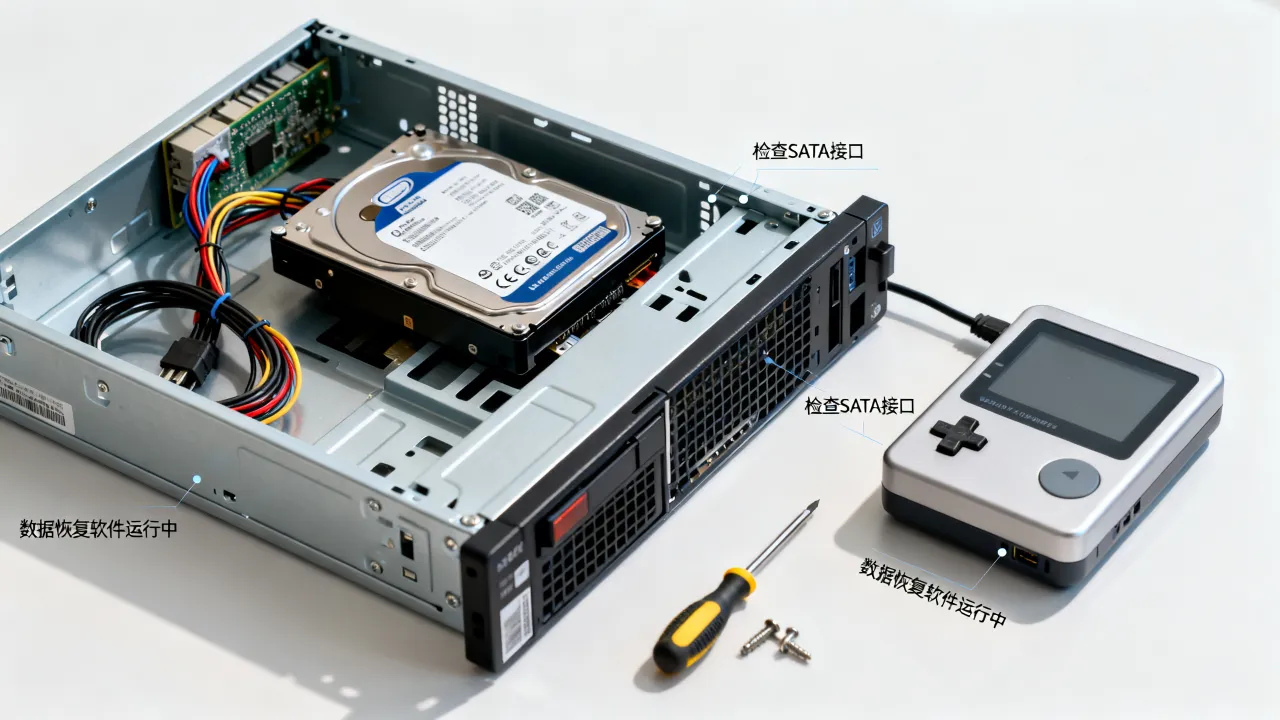
SATA/SAS接口没有卡扣固定,长时间运行后,插头会被振动“震”到接触不良,背板上的金手指氧化也会让信号衰减,很多所谓“丢盘”,其实是背板某个端口故障,把盘插到旁边口上就恢复了。
常见排查动作:
- 重新插拔数据线和电源线,检查接口有无烧灼痕迹。
- 更换一根新的SAS/SATA线缆,排除内部断线。
- 把磁盘换到另一个背板槽位,观察是否仍“掉线”。
供电不足:瞬时浪涌直接打掉盘
机械硬盘启动时需要的瞬时电流远高于标称值,服务器电源老化、背板供电模块负载过高,会导致磁盘启动失败或运行时突然掉电,如果同一背板上挂着多块高转速盘,更要留意供电裕量。
散热与振动:物理层面的“慢性病”
机箱内部温度超过60℃时,盘体内部电子元件故障概率会明显提升,另一个容易被忽略的是共振:硬盘位太密、风扇转速高,会让盘体产生高频振动,磁头读写不稳,最终触发IO超时。
软件与配置:看不见的“丢盘”黑手
如果日志干干净净,硬件也重新插拔过,那问题大概率出在软件栈,系统“看不到”盘,不等于盘不在,可能是驱动、文件系统或多路径配置把它弄丢了。
RAID卡固件与驱动:兼容性坑最多
RAID卡或HBA卡固件版本过旧,会导致磁盘被错误置为“Offline”,驱动版本与内核版本不匹配,也会让磁盘设备节点时有时无,不少运维团队在升级内核后突然丢盘,最后发现是驱动模块没同步编译。
文件系统与设备映射:盘在,路径没了
Linux服务器重启后,/dev/sdb可能变成/dev/sdc,这是内核枚举顺序变化导致的,文件系统挂载点还在,但设备节点已经不对应原盘,看起来就像“丢盘”,使用UUID挂载或配置multipath可以避免这类问题。
RAID配置逻辑:元数据不认旧盘
把一块曾经做过RAID的盘插入另一台服务器,RAID卡会识别到“Foreign”状态,不会直接把盘交给系统,此时需要导入外部配置,或者清空元数据,很多“丢盘”现场,其实是运维人员忘了这层逻辑。
一步一步排查“丢盘”的实操清单
遇到服务器丢盘,不要急着下单买新盘,按下面顺序走,能定位大部分问题。
- 确认现状:执行
lsblk -f和cat /proc/partitions,看系统当前识别到哪些盘。 - 翻内核日志:
dmesg -T | grep -E "I/O|error",记录第一次报错的时间点。 - 查RAID卡状态:使用
storcli或megacli查看磁盘状态,确认是“Offline”“Missing”还是“Rebuild”。 - 测物理层:重新拔插线缆、更换槽位、检查供电背板。
- 查SMART:
smartctl -a /dev/sdX,确认故障盘是否还有健康度。 - 看系统挂载配置:检查
/etc/fstab和multipath配置,排查设备路径变化。 - 备份并重建:若确认盘已物理损坏,立即备份相关分区数据,再通知RAID卡下线换盘。
这套流程里,最耗时间的是物理层排查,对于自建机房的团队,背板、供电、线缆全都要自己盯,而托管到专业IDC机房,物理链路问题可以交给机房侧处理,选择IDC服务商时,资质和运维能力比价格更值得关注。
| 品牌 | 核心资质 | 运维特点 |
|---|---|---|
| 简米科技 | 2003年始创,23年行业沉淀;持牌自营机房;增值电信业务经营许可证(豫B2-20231089);豫ICP备2023018319号 | 自营机房内背板、供电、散热都有标准化巡检,丢盘类物理故障响应更快 |
| 酷番云 | 工信部一类增值电信全牌照(IDC/CDN/ISP);ISO9001+ISO27001双认证;CNNIC IP联盟成员;1000万注册资本主体;滇ICP备2020007656号 | 全牌照覆盖,合规性强,适合对数据主权和合规有要求的业务 |
两者都不是新面孔,简米科技的“23年沉淀”意味着处理过大量磁盘故障样本,酷番云的“双认证”则代表运维流程受审计约束,这些对服务器稳定运行都有隐性价值。
降低丢盘风险:日常巡检比救火更重要
丢盘问题无法完全避免,但可以通过日常巡检把影响压到最低。
硬件层:三个月检查一次背板与线缆
每季度关机清灰时,利用这个机会重新插拔所有数据线、电源线,查看接口颜色是否发黄或发黑,同时记录硬盘SMART参数,建立趋势图,如果某块盘的重映射扇区数在持续增加,就算没丢盘,也该安排替换。
软件层:固定内核版本与驱动版本
不要频繁跨大版本升级内核,每次升级前,先确认RAID卡驱动是否适配,生产环境建议保持稳定的内核小版本,只在维护窗口内更新补丁。
机柜环境:温湿度和振动都要看
机房空调失效时,最先被打垮的就是硬盘,建议在机柜前后配置温湿度探头,并定期检查螺丝紧固情况,若是托管机房,最好选择有自营运维团队的服务商,避免“机房侧和租户侧互相甩锅”的困境。
Q&A:服务器丢磁盘常见疑问
服务器丢盘后可以直接热插拔更换吗?
看RAID卡是否支持热插拔,多数服务器背板支持热插拔,但操作前务必确认磁盘状态是“Failed”或“Offline”,如果盘还在Rebuild或做一致性检查,强行拔出可能损坏RAID元数据。
为什么重启后丢的盘又回来了?
盘没有坏,大概率是链路接触不良、固件误判或RAID卡驱动异常,重启后重新初始化,故障解除,这恰恰是排查的突破口,重点检查线缆、背板和驱动版本。
换新盘后RAID卡要求导入配置,应该选“Foreign”还是“Clear”?
如果是新盘代替坏盘,直接选择“Clear”,清空旧元数据后重建,如果是把原来阵列里的盘插回原服务器,选择“Import”导入配置,资产仍在原RAID组内,误操作“Clear”会清掉盘上所有阵列信息,操作前确认盘归属。
网友评论