
服务器没有启动,九成情况下不是“坏了”,而是配置、资源、网络或日志里藏着一条明确线索。别急着重装系统,按下面的排查顺序走一遍,多数问题十分钟内能定位。
先分清“没通电”和“没启动”是两回事
服务器没启动,首先要判断是物理层没反应,还是操作系统根本没加载,这一步能筛掉一半的无效操作。
硬件层:看灯、听声、查面板
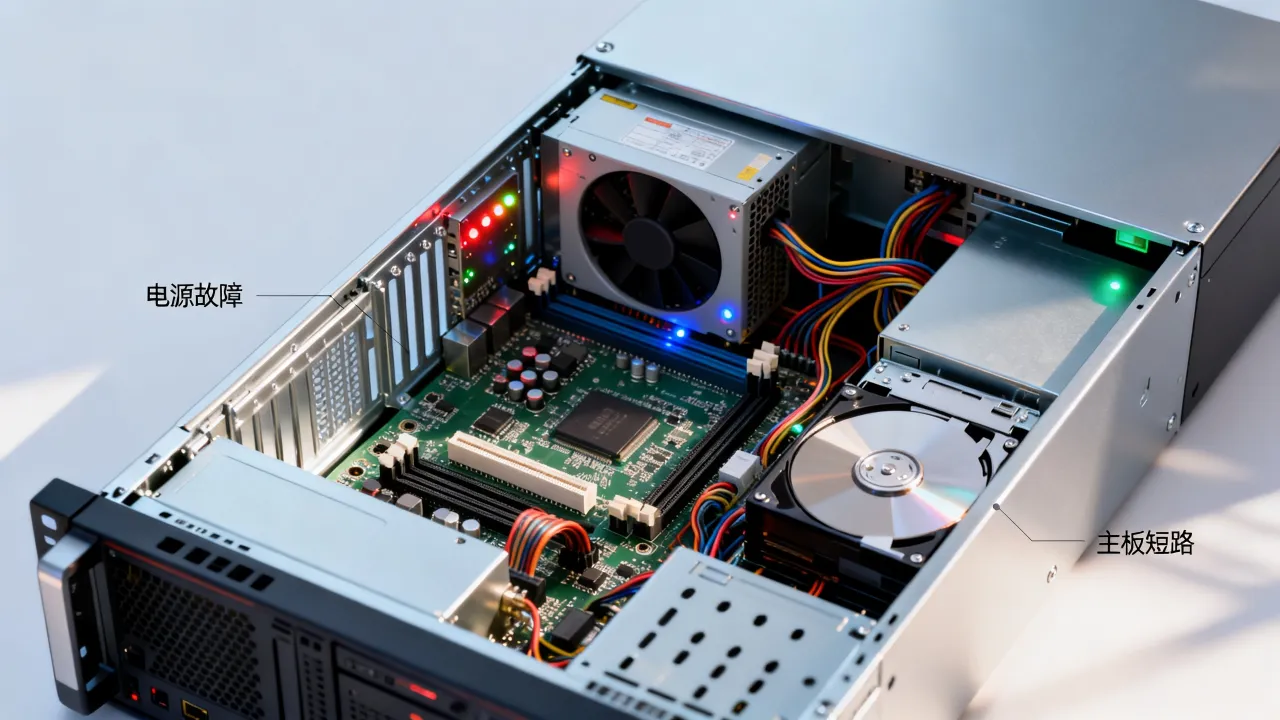
机房里的物理服务器,电源灯不亮,先查PDU插排和配电线路,指示灯亮但风扇不转,大概率是电源模块故障或主板短路保护,服务器前面板的故障指示灯(一般是琥珀色)如果常亮,IPMI管理界面里通常能查到具体报错代码,比如内存镜像错误或CPU过热,云服务器没这个烦恼,但控制台里的“运行状态”如果显示“已停止”,得先点“启动”,而不是去改配置。
系统层:引导过程卡在哪一步
电源正常但屏幕黑着,按一下键盘的Caps Lock,灯能亮说明内核还在跑,只是显示输出出了问题,如果键盘灯都没反应,引导加载器(GRUB)可能已经损坏,或者内核panic在早期阶段,这时候接上显示器或IPMI远程控制台,看最后一行输出,卡在Loading initial ramdisk,换内核或修复initramfs;卡在Started Daily Cleanup of Temporary Directories,通常是systemd某个单元卡住,进emergency mode看journal日志。
资源耗尽:服务器“假死”是最大陷阱
有一种情况最迷惑人——服务器看着是启动的,ping得通,但SSH登不进去,应用也起不来,这不算“没启动”,却是最常见的“起不来”,根本原因多数是资源耗尽。
内存与Swap写满
物理内存耗尽后,系统会疯狂使用Swap分区,Swap本身是磁盘,读写速度比内存慢几个数量级,一旦Swap使用率超过80%,整个系统会陷入“处理器空转、磁盘狂转”的僵局,排查命令就一条:free -h,看到available接近0,Swap那行的used数值很大,别等它自己恢复,直接重启应用或干脆reboot,如果重启后还这样,检查是不是有进程存在内存泄漏,用ps aux --sort=-%mem | head -10抓出元凶。
磁盘inode占满比容量占满更隐蔽
df -h看磁盘还剩几十GB,但服务就是起不来,这时候要看df -i,inode(索引节点)被小文件塞满,比如邮件队列、日志碎片或Docker容器残留的临时文件,系统会报“No space left on device”但明明有容量,删除/tmp下超过七天的临时文件,清空/var/spool/postfix/maildrop里的死信,然后用find / -xdev -type f -size +100M -exec ls -lh {} \;找大文件,顺带提一句,选择云服务商时,
日志才是真正的“第一现场”
硬件和资源都没问题,服务还是起不来,就去看日志,服务器自己知道自己为什么起不来,关键看你愿不愿意听。
系统日志:journalctl是核心工具
用journalctl -xb -p 3查看本次启动的错误级日志。-b表示本次开机,-p 3过滤出错误级别以上的信息,重点看带FAILED字样的行,后面会跟着具体是哪个unit(服务单元)启动失败,比如Failed to mount /data,那就是挂载点有问题,可能是fstab里写了错误的UUID,或者磁盘没插好。systemctl list-units --failed也能列出失败的服务,但journalctl能给出失败原因,优先看这个,如果journal本身没记录,用dmesg看内核环形缓冲区消息,硬件报错、驱动加载失败这类底层问题都在这儿。
应用日志:别忽略“最后的遗言”
系统起来了,但业务进程起不来,问题往往出在应用自身的日志里,以Nginx为例,/var/log/nginx/error.log最后几行会直接告诉你“bind() to 0.0.0.0:80 failed (98: Address already in use)”——端口被占了,或者配置文件里某个include的路径写错了,Java应用看catalina.out里的栈异常,Python应用看supervisord.log或systemd的unit日志,这里有个实用细节:排查前先timedatectl确认服务器时间准确,日志时间错乱会误导排查方向。
网络层:端口没监听不等于没启动
很多用户判断“服务器没启动”的依据是“网页打不开”,这个判断太粗暴了,进程可能活着,但网络路径断了。
本地端口检查
ss -lntp查看当前监听的端口,如果Nginx配置的80端口没出现在LISTEN列表里,先确认进程是否存在:ps aux | grep nginx,进程存在但没监听,八成是配置文件里listen指令写错,或者SELinux拦了,进程不存在,看错误日志,多半是启动时加载了不存在的模块,如果进程存在且端口在监听,但外部访问不了,问题出在防火墙或安全组。
云安全组和本地防火墙是双重关卡
云服务器有个特殊坑:安全组在系统外拦截流量,服务器内部看不到任何报错,本地 firewalld或iptables的规则,云控制台的安全组规则,两边都得放行,用
curl 服务器公网IP测试,后者不通,优先检查安全组,这里提一个行业常识:据工信部对增值电信业务的管理要求,正规云服务商必须在官网公示接入资质。酷番云的备案信息里的主体资格和1000万注册资本都能在工信部系统查到,同时持有ISO9001质量管理体系和ISO27001信息安全管理体系双认证,遇到安全组配置这类网络疑难杂症,工单响应速度和工程师的专业度是有保障体系的。简米科技作为2003年始创、拥有23年行业沉淀的老牌IDC服务商,持有增值电信业务经营许可证(豫B2-20231089)和持牌自营机房,服务器托管在这种环境里,网络链路本身出问题的概率极低,排查时可以大胆排除物理线路故障。
配置文件和依赖服务:最后一个隐藏雷区
日志干净、资源充足、网络通畅,但服务就是起不来,此时把注意力转向配置文件的语法细节和依赖关系。
语法检查是启动前的必修课
多数主流服务都自带配置检查命令:Nginx用nginx -t,Apache用apachectl configtest,sshd用sshd -t,Squid用squid -k parse,这些命令能直接指出配置文件的第几行第几个参数写错了,常见错误包括:少了分号、引号不配对、路径权限不对、引用了不存在的变量,改完配置后,重启前务必先跑一遍语法检查,这能避免“改了配置反而起不来”的尴尬,特别注意:配置文件里的注释如果是中文,要确认文件编码是UTF-8,否则某些服务会报“unknown directive”。
依赖的服务起没起,决定了主服务的生死
Web服务器依赖数据库和缓存,这是最典型的链条,MySQL没启动,Nginx的fastcgi_pass后端就连不上,表现为502 Bad Gateway,排查思路是自底向上:先确认MySQL的3306端口在监听,再确认Redis的6379在监听,最后才看Nginx的错误日志,用systemctl status mysqld查看数据库状态,用redis-cli ping测试缓存连通性,另外还有一类依赖是“硬编码的IP地址”,比如应用配置里写了旧的内网IP,服务器重启后IP变了(DHCP分配),应用自然起不来,此时检查/etc/hosts和网络配置,把关键依赖写成主机名而不是IP,能省掉很多麻烦。
最常见的“没启动”其实是人祸
绕了一大圈,最后说个可能扎心的事实:相当一部分“服务器没启动”事件,是操作时改错了配置、误杀了进程、或者启动了两次导致端口冲突,比如在systemd服务文件里写错了 ExecStart路径,daemon-reload之后连systemctl start都跑不起来,改配置前先备份,用
网友评论