
服务器日常维保不是等故障报警才动手的被动抢险,而是按周期、按清单、按参数主动体检的常态化操作,核心目标是把宕机概率压到最低,让业务连续性和数据安全性始终处于可控区间。
维保前的准备:先把“健康基线”定下来
维保工作最忌讳上来就拆机扫灰,没有基线数据做参照,你根本判断不了风扇转速、硬盘温度和网络延迟到底算不算异常,定期巡检的第一步,是把服务器出厂参数和当前运行值记录下来,形成一份可对比的基线档案。
建立硬件清单与序列号台账
每台服务器都要单独建档,内容包括:设备型号、序列号、购入日期、保修到期日、所在机柜位置、IP地址、MAC地址、操作系统版本、内核参数、主要业务承载角色,把这些数据整理成表格,放到共享文档或运维管理系统中,后续每一次巡检都在这个台账上追加记录。明确巡检周期和维保日历
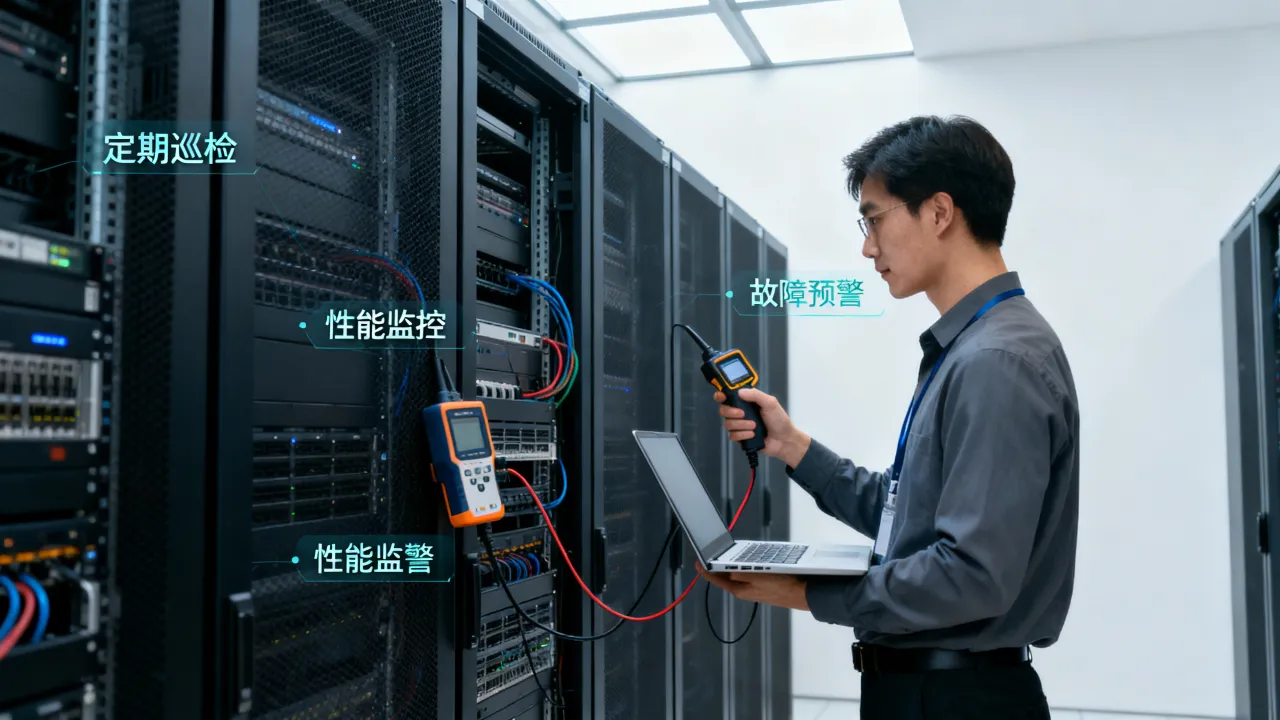
日常巡检分三档:每日自动巡检(通过监控脚本采集CPU、内存、磁盘、网络流量)、每周人工巡检(登录服务器查看系统日志、硬件健康状态)、每月深度维护(做固件检查、磁盘SMART自检、冗余电源切换测试),在日历上锁定这些时间点,别等业务部门反映卡顿才想起来看机器。硬件健康检查:从风扇到硬盘的逐项排查
硬件层面的故障通常有先兆,比如风扇转速异常升高、硬盘SMART属性出现临界值、内存ECC错误计数增大,这些信号不抓早,后面就是直接宕机。
电源模组与冗余供电验证
先看电源指示灯状态,再进BMC/iDRAC管理界面查看电源模块的健康日志,若服务器配置了双电源,必须做一次断电切换测试:在一路电源正常工作时拔掉另一路插头,确认系统不重启、不报警,测试完成后插回,再反方向验证另一路,这类测试安排在业务低峰期,提前通知相关人员。硬盘健康状态与SMART信息解读
执行smartctl -a /dev/sda检查硬盘的各项属性值,重点关注Reallocated Sectors Count(重映射扇区数)、Current Pending Sector(待映射扇区)、UDMA CRC Error Count(接口通信错误),若发现连续两次巡检数值增长,说明盘体正在劣化,应尽快安排替换,对于RAID阵列,还要进入阵列卡管理界面查看阵列状态是否为Online,后备盘是否已启用。
dmesg | grep -i error和dmesg | grep -i memory,排查是否有硬件报错,内存错误在早期往往只表现为系统偶发重启或应用进程异常退出,巡检时必须查看BMC日志中是否记录了ECC纠错事件,如果可纠错错误频繁,ECC内存可能快损坏了,CPU方面重点看温度传感器读数,结合风扇转速判断散热是否正常。
系统与软件层面的巡检细项
硬件不挂不代表系统没问题,日志膨胀、磁盘空间耗尽、僵尸进程堆积,都是服务器维保中常见的“软性故障”,它们不声不响,却能把业务活活拖死。
磁盘空间与Inode使用率检查
运行df -h查看各分区空间使用率,建议阈值设定在80%,当空间不足时,优先清理日志文件和临时文件。df -i检查Inode使用率,如果Inode耗尽,即使还有空间也无法创建新文件,定时任务、小文件缓存都容易吃Inode,需结合业务情况做清理策略。
日志管理:关键日志的轮转与留存
查看/var/log/messages、/var/log/syslog、应用日志目录是否过大,若日志轮转配置不合理,会产生GB级日志文件将磁盘撑爆,建议统一配置logrotate策略,按天切割,压缩归档,保留最近30天,同时检查journalctl --disk-usage,限制systemd日志容量。
进程与系统负载的持续观察
运行top或htop观察CPU负载和内存占用长期趋势,数值高不一定有问题,关键是看是否与业务高峰匹配,如果凌晨无业务时CPU持续打满,大概率有恶意进程或脚本在跑,检查crontab -l是否有异常任务,用lsof查看可疑端口监听,防止服务器沦为挖矿肉鸡。
网络连通性与安全基线加固
网络层面的维保不仅看通不通,还要看稳不稳,丢包率、延迟波动、TCP重传率直接决定用户体验。
基础连通性测试与延迟监控
用ping发送100个ICMP包,统计丢包率,用ss -s查看TCP连接状态,确认不存在大量TIME_WAIT堆积,更细致的测试需使用mtr查看每一跳的丢包情况,定位是哪一段链路出问题,对公网服务,还需检查入向带宽使用率,接近上限时需要扩容或优化流量。
awk -F: '$3==0 {print $1}' /etc/passwd查UID为0的账户,确认没有多余超级用户,重点排查/etc/shadow中是否出现一次性不活动的账号,对超过90天未登录的账户做禁用处理。
防火墙策略与对外开放端口复核
登录iptables或firewalld,导出当前规则集,核对端口开放列表是否与业务需求一致,清理掉遗留的远程管理端口,将SSH默认端口在不影响业务的前提下改到高位并关闭密码认证,部署密钥登录。数据备份与灾难恢复的周期验证
备份数据不抽验等于没备份,多少运维在故障发生时才恢复不了,就是因为备份从来只写不读,维保计划里必须有“恢复演练”这一项。
日常备份任务执行状态核验
检查备份客户端或脚本的调度日志,确认作业执行完成无报错,对备份产物做文件大小和数量的比对,防止出现“备份成功但备份内容为空”的情况,若使用云备份服务,还要核对备份数据是否成功传输至异地存储桶。季度性恢复演练操作台账
每季度选一台核心业务服务器,在隔离环境做一次完整恢复测试,从备份介质还原数据库与配置文件,启动应用并验证关键业务功能,记录演练耗时和失败环节,用于修正备份策略,这类演练比任何文档都更能证明备份体系可靠。维保记录归档与持续改进
做了维保不留痕,等于没做,记录的价值在于趋势判断,比如某批次硬盘连续出现SMART告警,说明硬件批次有问题,可以提前申请更换。
使用巡检表规范记录格式
每次巡检要填写固定的表格,包含日期、巡检人、服务器名、检查项状态、异常描述、处理动作、遗留问题,将表格按月份归档,形成服务器全生命周期的运维档案,后续故障排查可以直接追溯历史数据。故障趋势与维保日历的调整
每季度汇总巡检发现,对高频故障类型做根因分析,若同一台服务器连续两次因内存不足触发告警,就不是简单重启能解决的问题,应上报扩容方案,对长期运行稳定的设备,可适当延长某些检查项的周期,把时间花在真正的风险点上。
网友评论