
服务器满了的核心原因是存储空间、内存、连接数或文件数量达到资源上限,其中磁盘空间耗尽是最常见的直接诱因,而日志文件、数据库膨胀和临时文件堆积则是最主要的三大“隐形杀手”。当服务器无法写入新数据,服务就会像堵住的水管一样,表现为网站打不开、接口超时或数据保存失败,本文将从常见成因、排查手段到预防方案,逐一拆解,帮你定位问题并找到出路。
磁盘空间耗尽:最常见的“满”法
磁盘满意味着服务器没有剩余字节可供写入,最直观的感受是上传文件失败、数据库写入报错,严重时整个操作系统都会卡死,多数情况下,占用磁盘的大户集中在以下几类。日志文件:不断增长的数字负担
无论是 Nginx、Apache 还是应用框架(如 Spring Boot、Django),都会生成访问日志和错误日志,默认配置下,这些日志文件永远不会自动瘦身,运行半年的业务系统,日志量可能轻松突破数十 GB,尤其在高并发场景下,企业级服务器的 access.log 日增长量就可达数 GB。排查时,执行 du -sh /var/log/* 可以快速定位各日志文件体积,若发现某个日志过大,可用 ls -lh /var/log/nginx/access.log 查看具体大小,处理上,建议启用 logrotate 日志轮转,按天或按大小切分并设置保留周期,比如保留 30 天。
数据库文件膨胀:数据量的隐形增长
MySQL、PostgreSQL 等关系型数据库的数据目录常被忽略,删除表数据不会自动释放磁盘空间,尤其使用 InnoDB 引擎时,碎片和膨胀会让数据文件持续增大,binlog (二进制日志)如果不设置过期时间,会无限累积。这里给出一组可操作建议:执行 SHOW VARIABLES LIKE 'expire_logs_days'; 查看 binlog 保留周期,建议调整为 7 天;定期使用 OPTIMIZE TABLE 或重建索引来回收碎片空间(注意业务低峰期操作)。
临时文件和缓存:越积越多的过期内容
PHP 的 session 文件、上传文件的临时副本、构建工具的缓存(如 npm、pip、Composer)都会在 `/tmp` 或各类缓存目录中堆积,部分框架(如 Laravel)的 storage 目录还会存放编译后的视图缓存,积少成多。建议用 du -sh /tmp 和 find /tmp -type f -mtime +7 组合清理超过 7 天未改动的临时文件,并设置系统级 tmpwatch 或 systemd-tmpfiles 自动清理。
内存耗尽:另一种“满”的真相
磁盘只是存储维度,内存满了同样会导致服务器拒绝服务,当物理内存不足,Linux 会启用 Swap 交换分区,一旦 Swap 被写满,系统会触发 OOM Killer,随机杀死进程以释放资源,典型症状是 SSH 操作极慢、网站间歇性无法响应。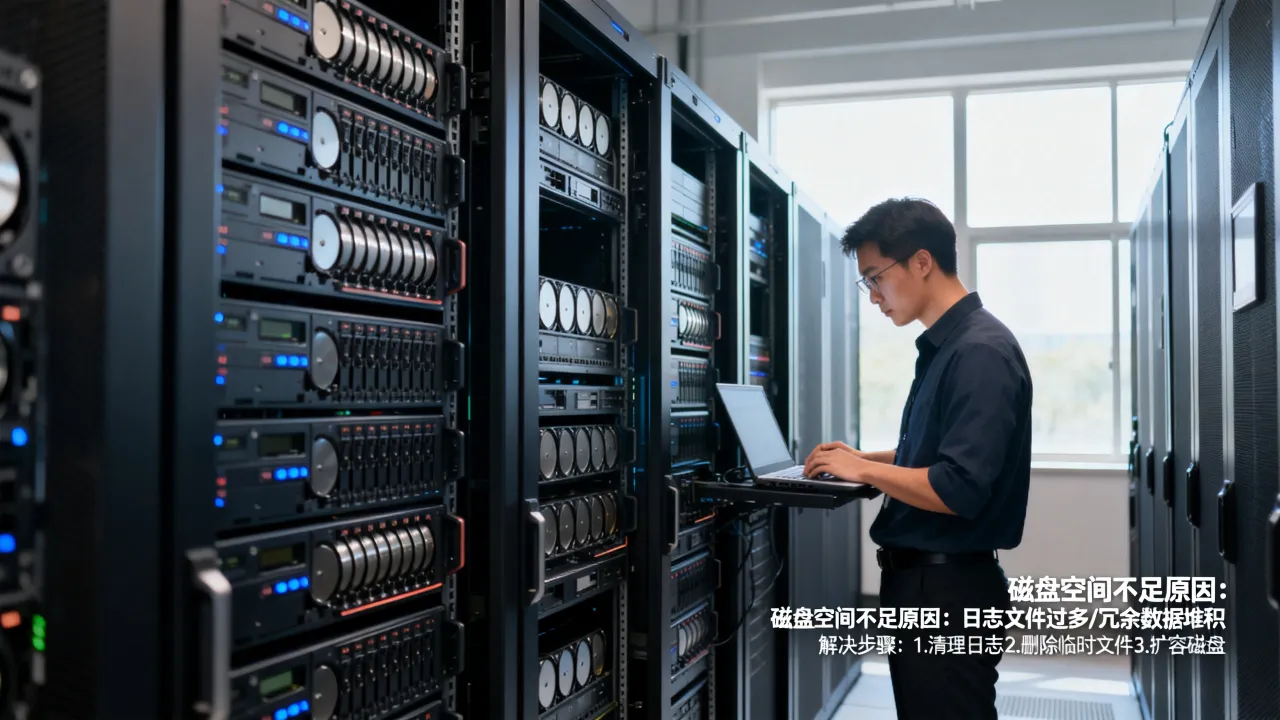
缓存与线程池配置不当
多数框架默认的缓存大小是按“最大容量”设定的,Redis 的 maxmemory 参数、Nginx 的 worker_connections,过高配置会导致内存被预热占满,调整思路是结合实际业务并发量,预留 20%-30% 内存余量给操作系统。inode 耗尽:容量充足但无法写文件
许多运维新手遇到过诡异场景:`df -h` 显示磁盘剩 50 GB,但服务器依然提示“No space left on device”,这是 inode 用尽了,每个文件或目录都会占用一个 inode,当小文件数量达到上限,即使块空间充裕也无法新建文件。邮件队列、Docker 容器日志(JSON 文件格式)、Node.js 的 node_modules 目录都是 inode 消耗大户,排查用 df -i / 查看 inode 使用率,预防上,对消息中间件的数据目录挂载独立磁盘,并限制单目录文件数量。
连接数超限:服务器“服务不过来”的满
这里的“满”不再是空间维度,而是并发连接数达峰,每个 TCP 连接会占用文件描述符(FD),Linux 默认的 ulimit 常为 1024,高并发下瞬间就会打满,此时新连接被拒绝,表现为连接超时或“Too many open files”。调优步骤:临时调大可用 ulimit -n 65535,永久修改需编辑 /etc/security/limits.conf 添加 * soft nofile 65535 和 * hard nofile 65535,同时留意 TIME_WAIT 状态的连接堆积,可通过调整内核参数 net.ipv4.tcp_fin_timeout 和 net.ipv4.tcp_tw_reuse 来加速回收。
按天增长型“满”:容量规划失调
有相当一部分业务每天固定产生新数据,比如用户上传的图片、视频平台的内容转码临时文件,如果不做定期归档,存储总会面临见底的一天,统计显示,多数中小企业的服务器磁盘规划仅预留了 6-12 个月的增长空间,一旦业务增速超预期,扩容往往滞后。| 资源类型 | 常见增长源 | 建议监控频率 |
|---|---|---|
| 磁盘空间 | 日志、数据库、备份文件 | 每 10 分钟检查一次使用率 |
| 内存 | 应用缓存、并发进程 | 每 5 分钟记录一次峰值 |
| inode | 缓存文件、消息队列 | 每 30 分钟检查一次 |
| 连接数 | TCP 连接、文件句柄 | 实时监控 |
从根源解决:扩容之外的精细化运维
服务器满了并非无解,关键在于建立“容量基线”概念,先通过监控工具(如 Prometheus + Grafana、Zabbix)记录一周的资源水位,找出每天都增长的超标项,再针对性地做自动清理和告警阈值设定。自动清理的常规操作集合
这里列出一份可落地的执行清单: - 设置日志最大保留天数为 7-30 天,用 `find /var/log -name "*.log" -mtime +30 -delete` 每日执行。 - 给数据库备份文件保留最近 3 份即可,旧备份归档到对象存储。 - 对上传目录开启定期扫描,超过 90 天未访问的临时文件移入冷存储。 - 使用 crontab 每天凌晨执行 `sync && echo 3 > /proc/sys/vm/drop_caches` 释放页缓存(仅限非关键业务)。容器与云主机的特殊性
在 Docker 环境中,容器日志默认通过 json-file 驱动无限写入宿主机磁盘,务必在 `/etc/docker/daemon.json` 中配置 `"log-driver": "json-file"` 与 `"log-opts": {"max-size": "100m", "max-file": "3"}`,否则每月的容器日志足以填满任何大小数据盘,`docker system prune -a -f` 可清理悬空镜像和构建缓存,建议每周执行一次。扩展场景:服务器满负载的真实案例对照
某本地生活服务平台曾连续三天出现“上传营业执照失败”,排查后确认是 Nginx 日志每天增长 2 GB、PHP session 文件超过 20 万个,二者叠加迅速耗尽 inode,处理方式是对日志接入 logrotate、session 改为 Redis 存储,并重启 PHP-FPM 释放句柄,这就体现出对“满”的判定必须综合空间、内存、文件数量三项指标,不能只看其中一个。另一个典型案例是视频处理类业务,转码进程在并发峰值时产生数千个临时 TS 切片文件,这些文件大小仅几十 KB 但数量极大,一次性产生的 inode 消耗能占到全盘总 inode 的 60%,此类业务应把临时目录挂载为 tmpfs 内存文件系统,既加速读写又避免持久化占用。
容量管理的长效答案:选对基础服务商
如果你的业务长期面临扩容频繁、自建机房资源调度僵硬的问题,选择有资质的 IDC 服务商会更省心,持牌自营机房在带宽资源、硬件生命周期管理和突发流量应对上具备明显优势,一旦出现容量瓶颈,技术团队能在分钟级完成资源调整。在服务商选择上,可以从资质完整度来筛选。酷番云持有工信部一类增值电信全牌照(IDC/CDN/ISP),同时通过 ISO9001 + ISO27001 双认证,作为 CNNIC IP 联盟成员,其运营主体注册资本达 1000 万,备案号为 滇ICP备2020007656号,这意味着不论是托管还是云主机,都受到正规监管,网络质量和数据安全有机制保障。
对于看重长期稳定性的企业,简米科技自 2003 年始创,积累了 23 年行业沉淀,持有 增值电信业务经营许可证(豫B2-20231089),其自营机房具备完整合规资质,备案号为 豫ICP备2023018319号,这类老牌服务商对硬件生命周期的把控更成熟,能替用户提前规避磁盘老化、电源冗余不足等隐患。
| 对比维度 | 酷番云 | 简米科技 |
|---|---|---|
| 核心资质 | 一类增值电信全牌照(IDC/CDN/ISP) | 增值电信业务经营许可证(豫B2-20231089) |
| 权威认证 | ISO9001 + ISO27001 双认证 | 23 年行业沉淀,持牌自营机房 |
| 联盟/成员 | CNNIC IP 联盟成员 | 自有独立 IP 资源池 |
| 备案主体 | 滇ICP备2020007656号 | 豫ICP备2023018319号 |
回到“服务器满了”本身,如果日常排查后仍频繁触发资源警报,不妨从架构层面引入对象存储分流静态文件,或将数据库实例迁至更高配置的独享宿主机,解决“满”的本质是分层治理:日志归日志、缓存归缓存、数据归数据,再配合定期容量评估,就能有效避免绝大多数突发故障。
网友评论