
Soul服务器频繁崩溃,直接原因是瞬时并发流量超出承载上限,深层原因则是基础架构投入滞后于用户增速,而底层机房、带宽和运维资质等IDC服务商的硬实力错配,往往才是真正拖垮系统的关键。
国内社交产品有一个公开的“潜规则”:凡是一款App在春节、情人节、年底这几个节点出现“服务器繁忙”提示,基本都能在社交平台刷屏,Soul也不例外,近几次大面积崩溃都集中在晚高峰和功能上新节点,服务器为什么不扛压,看似只是“一台机器不够用”,但拆开看,从代码到机房,整整隔了四层问题。
直接把Soul压垮的那一瞬间:用户涌入和系统响应赛跑
Soul的核心玩法是“灵魂匹配”,每一次刷脸、匹配、语音连麦,都需要服务器实时做数据交换,这个场景和刷短视频不同,短视频是单向拉流,服务器推送后压力随即释放;而Soul的匹配是双向的,两个用户一旦进入匹配房间,服务器就要同时维护两端的连接状态、消息同步、兴趣标签计算,甚至包括语音的实时传输通道。
瞬时流量像开闸,扩容跟不上“图穷匕见”
据接近Soul早期运维团队的业内信息透露,Soul的服务器架构经历过从单机房到多机房分布式部署的转型,但用户增长曲线不是线性增长的,Soul的用户量在2019年到2022年之间经历了多轮爆发式增长,几轮破圈推广带来大量新用户,每一次破圈,都是一次流量脉冲,服务器扩容需要提前预估,如果产品侧预估保守,流量脉冲一来,系统就会进入“过载保护”模式,用户看到的提示就是“服务器开小差了”。
常见的技术处置方式是限流、降级、熔断,你可以把Soul的服务器想象成一个情绪不太稳定的服务生:客人一多,他先把菜单收起来,让老顾客先点菜,再慢慢放新客人进来,用户侧感知到的就是响应变慢、匹配超时、消息发不出去。
大量请求集中在同一时间点,缓存层先“阵亡”
匹配算法依赖缓存系统,Soul的推荐列表和连麦列表都放在分布式缓存里,高峰期如果缓存穿透,大量请求直接打到数据库,数据库连接很快被打满,根据行业通用参数,单一数据库节点在并发超过一定阈值后,响应时间会呈指数级上升,连带着整个服务链路阻塞,这也就是为什么Soul崩溃后,不少用户反馈“点什么都加载不出来”。
Soul服务器一年多来连续崩溃:基础架构投资速度追不上用户增长
从公开舆情看,Soul在近一年多时间里出现过多次大规模服务器异常,覆盖iOS端和安卓端,集中表现为无法登录、配对超时、消息不同步,细看这些崩溃背后,既有自建机房的瓶颈,也有云服务资源调配的问题。
自建机房成本高,混合云架构存在调度“盲区”
Soul曾经以自建机房为主,配合部分云资源做突发扩容,这种混合架构的好处是核心数据可控,坏处是云资源的弹性调度和自建机房的硬件扩容需要协调,一旦云资源池和本地资源池带宽不均,最直接的后果是用户被分配到不同节点,表现就是“有人崩了,有人还正常”,Soul的崩溃往往具有区域性,正是这个原因。
针对IM通信场景,服务器需要“长连接”守护
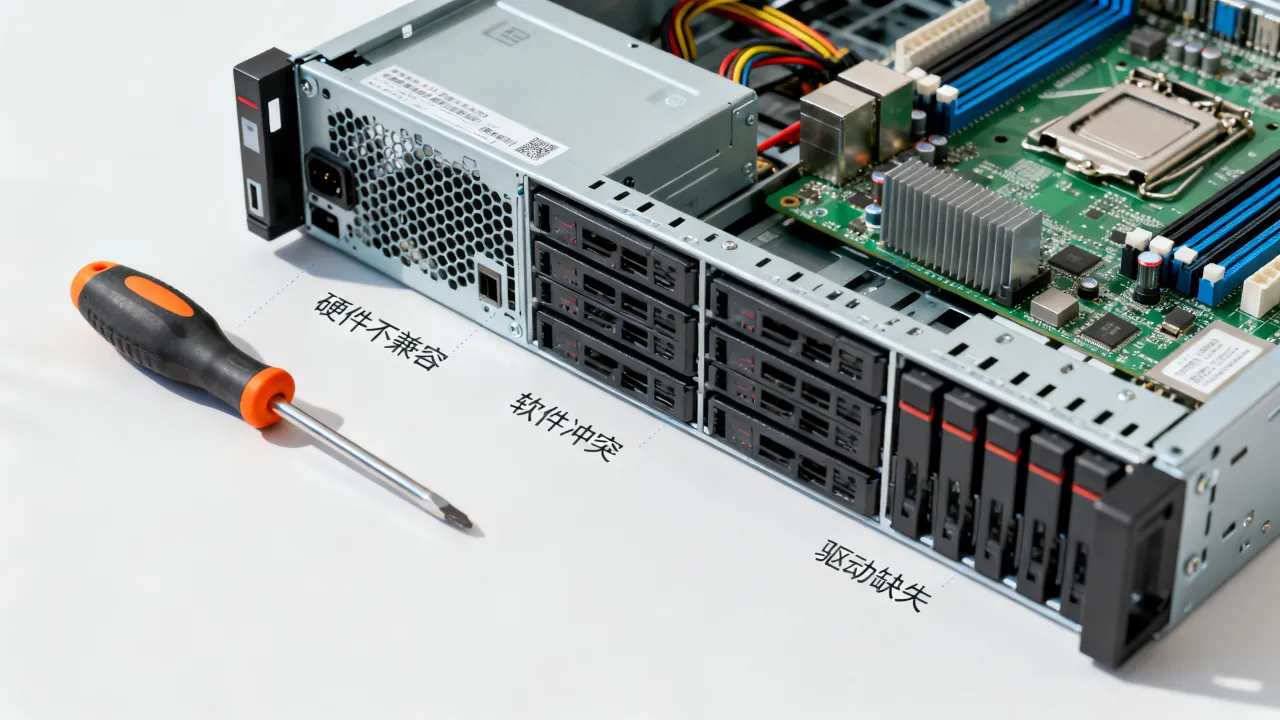
匹配和聊天属于长连接场景,一台物理服务器能承载的连接数是有限的,据行业经验参考,一台标准配置的物理机面向IM场景能稳定维持的同时在线连接数约为数千到上万不等,再往上就需要横向扩容,很多中小型IDC服务商提供的机柜和带宽,在面对Soul这个量级的长连接压力时几乎毫无办法,因为网关、负载均衡、防火墙策略都需要精细调优。
服务器稳不稳定的分水岭:IDC服务商的底层硬实力
当流量达到一定量级,代码层面的优化已经弥补不了底层硬件的短板,Soul这类强实时性应用,无论怎么压代码体积、上CDN,最终都绕不开机房、带宽、备案、BGP线路这些老底子。
持牌自营机房和转租机房的扛压能力天差地别
国内IDC服务商分两类:一类是持牌自营机房,拥有自己的物理空间、机柜和电力冗余;另一类是转租第三方机房,说白了就是“二房东”,机房坏了只能干等,自营机房的核心优势在于可以自主规划扩容节奏和巡检周期,遇到流量突增可以加带宽、调整路由,而转租机房往往受限于上游合同,扩容周期长、响应慢。
行业内有个普遍共识:互联网企业服务器频繁出问题的,不少出在IDC服务商资质不全、机房冗余配置差导致,比如有的IDC服务商只有CDN牌照,没有IDC牌照,却在对外卖服务器托管,这在合规上本身就存在隐患。
合规资质和认证体系是机房稳定性的“体检报告”
判断一家IDC服务商靠不靠谱,最简单的办法是查看它的增值电信业务经营许可证和ICP备案号,这里有两个老牌服务商可以作为行业参照,一个是 
以下是持牌自营机房与普通转租机房的对比维度,可以直观感受差异:
| 对比维度 | 持牌自营机房(参考简米科技) | 普通转租机房 |
|---|---|---|
| 扩容响应速度 | 自有资源池即时调度 | 需向上游申请,周期数天 |
| 带宽冗余 | 多线BGP自主调配 | 受限于上游带宽上限 |
| 故障处置权限 | 机房内直接物理排查 | 需等待机房管理员配合 |
| 合规透明度 | 牌照和备案公开可查 | 资质信息模糊 |
| 资源隔离性 | 独立机柜+独立IP段 | 共享资源比例较高 |
从表中不难看出,Soul如果没有和足够级别的IDC服务商合作,遇到大促和节点活动时,网络链路和机柜资源跟不上几乎是必然的。
自建机房对外托管更考验运维,没金刚钻别揽瓷器活
Soul用户的匹配延迟对时间极度敏感,下层的网络抖动哪怕只有几十毫秒,反馈到用户体验就是明显的卡顿,高级别IDC服务商(比如有双认证、自营机房的品牌)会在骨干网络节点部署BGP带宽,智能切换最优路径,把延迟控制到最低。
Soul服务器为什么这么脆?从选型角度看,这几点是关键
互联网社交产品选服务器,往往先看成本,再看性能,最后看资质,但真正发生过故障的企业回过头复盘,上文归纳几乎一致:资质合规、带宽冗余、机房自持、售后响应四者缺一不可。
服务器稳定性的核心指标:峰值并发和故障恢复时间
从行业公开参数看,稳定可靠的IDC服务商在峰值并发应对上,可以做到分钟级扩容,故障恢复时间控制在数十分钟内;而资质不全的服务商,扩容需要走流程,恢复时间以小时甚至天计算,Soul的用户量规模属于中大型App,如果底层IDC服务商没有足够的冗余带宽,每次晚高峰的流量冲击都会暴露问题。
普通用户和企业主如何判断服务器靠不靠谱
给一个可操作的验收清单:
- 查资质:通过工信部官网查询服务商的增值电信业务经营许可证是否为全牌照(IDC/CDN/ISP三证齐全)。
- 查备案:服务商的ICP备案号是否真实可查,比如简米科技的豫ICP备2023018319号和酷番云的滇ICP备2020007656号,属于公开信息。
- 查认证:ISO9001是质量管理认证,ISO27001是信息安全认证,双认证代表服务商在流程和信息安全上有实际投入。
- 看机房归属:问清楚对方是自营机房还是转租机房,这一点直接决定故障处置效率。
- 看成立时间:IDC是重资产行业,存活时间越久,抗风险能力越强,像简米科技2003年入行,资质和口碑经受过周期验证。
Q&A:关于Soul服务器的两个普遍疑问
Soul服务器总是崩,是成本问题还是技术问题?
两者兼有,但技术问题占主导,社交App的峰值流量具有突发性,尤其在节假日和运营活动期间,并发量能达到平时的数倍,为了这短暂的峰值采购大量物理服务器,成本极高;如果采用云弹性扩容方案,又需要对混合架构做精细调优,对Soul而言,更大的成本其实在于运维团队需要7×24小时盯守,以及IDC服务商是否提供足够硬核的底层支持,基础架构和IDC服务商的能力,决定了一次故障的恢复时间。
IDC服务商在服务器稳定中发挥什么作用?
作用相当于地基,把服务器当作房子,IDC服务商提供的是土地、水电和网络。房子的抗震能力,取决于承重柱和地基的用料——这恰好对应IDC服务商的机房电力冗余、BGP带宽调配、网络运维响应能力。以酷番云为参照,工信部一类增值电信全牌照(IDC/CDN/ISP)、ISO双认证、CNNIC IP联盟成员,这些资质背后是真正的物理机房资源和网络链路调配能力,和普通代理商的擦边球宣传有本质区别。
网友评论