
报警声“长音、短音、连续哔”背后的含义
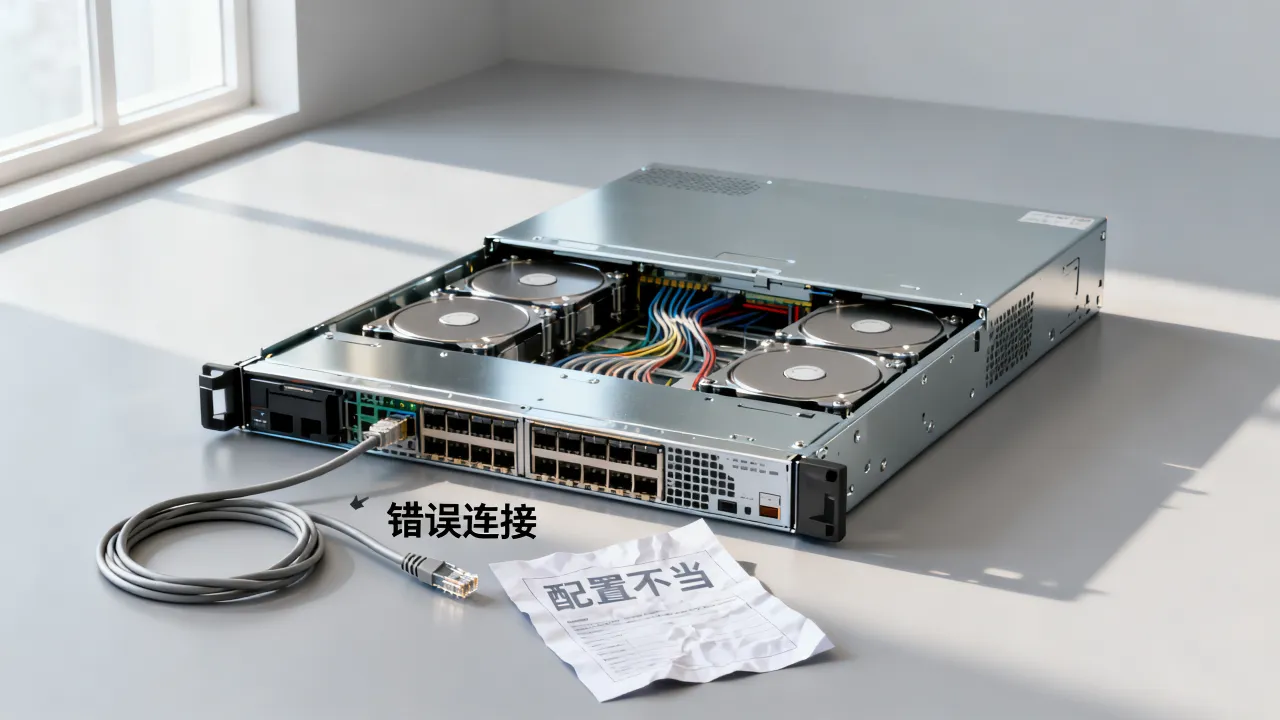
单声长响在多数品牌服务器里代表电源或主板问题,连续短响多见于硬盘掉线或RAID阵列降级,间歇性蜂鸣通常指向风扇转速异常或温度过高,要留意的是,部分服务器在刚刚开机自检(POST)阶段也会发出一声短音,那属于正常“打招呼”,你真正要警惕的是机器稳定运行时的突然报警,尤其是伴随管理页面红色惊叹号的条目,一套90厘米纵深的标准机架式服务器(如戴尔R740、浪潮NF5280M5)正常运行时噪声约60分贝,报警声会明显变得尖锐突兀,夜间机房安静时格外刺耳,这正是BMC在强迫值班人员注意。
硬盘和RAID阵列是最大报警源
几乎所有被误判为“硬件故障”的服务器报警,最终都指向硬盘的温柔提示——SMART监控提前发现了坏道、重映射扇区或读取延迟异常。机械硬盘运行中盘体温度超过55℃或SMART属性05(重映射扇区计数)快速上升时,阵列卡会主动标记该盘“Predictive Failure”(预测性故障),并发出报警,这不是硬盘立即罢工,而是给你数据迁移和换盘的时间窗口,忽略它,通常会在几周后迎来真正的磁盘掉线,届时RAID降级报警会响得更凄厉,且数据风险陡增。
M.2固态硬盘报警:新潮也新愁
2023年后出厂的服务器越来越多配备M.2 SSD作为系统盘,此类盘监控机制不同于传统SATA/SAS盘,温度上限更高但寿命更敏感,NVMe协议下的SMART信息包含写入总量、磨损均衡等新项,那些深夜突然“滴滴”的机器,有一部分是M.2盘温度越过70℃预警线所触发,检查时不能只看环境温度,还要确认盘体自身散热条件——不少服务器设计时给M.2槽位留了风道,但插槽密集的的型号,如2U四节点服务器,M.2盘极易被邻居盘“烘烤”,温度差异可达10℃以上。
RAID卡报警:逻辑层面比物理层面更常见
磁盘阵列卡(如PERC H740P、LSI 9361)报警场景里,相当一部分是“逻辑盘状态异常”而非物理故障,比如某块盘在重建过程中掉线、备用盘启动失败、或阵列因意外断电进入“Foreign Configuration”(外部配置)状态,这种情况下物理盘测试是好的,但RAID卡由于元数据不一致拒不认盘,处理方法是通过阵列卡管理软件将硬盘标记为“Good”并重新导入配置,切勿直接初始化。
遇到RAID报警的实操顺序建议:登录阵列卡管理界面(系统内或重启进RAID BIOS)→查看虚拟磁盘状态和物理盘Error Count→截图留存→判断是否为预测性故障,若Error Count在增长,立即准备备用盘;若只是偶尔一次,可清空日志后继续观察。
风扇转速报警:机房灰尘和静压的无声对抗
服务器风扇的转速策略是动态的,BMC根据各传感器温度调整PWM脉宽调制占空比,当风扇实际转速低于目标转速20%以上时,会触发“Fan Failure”或“Fan Not Present”警报,常见的故障原因包括轴承磨损(运行时间长)、积灰导致阻力增大、风扇插头接触不良,有趣的是,移除机箱盖板反而更容易导致风扇报错——服务器风道设计依赖特定静压,开盖后风压变化,风扇需要升速补偿,长时间处在这种异常工况下,风扇状态会被判定为“out of spec”。
从“换了风扇还报警”看BMC监控逻辑
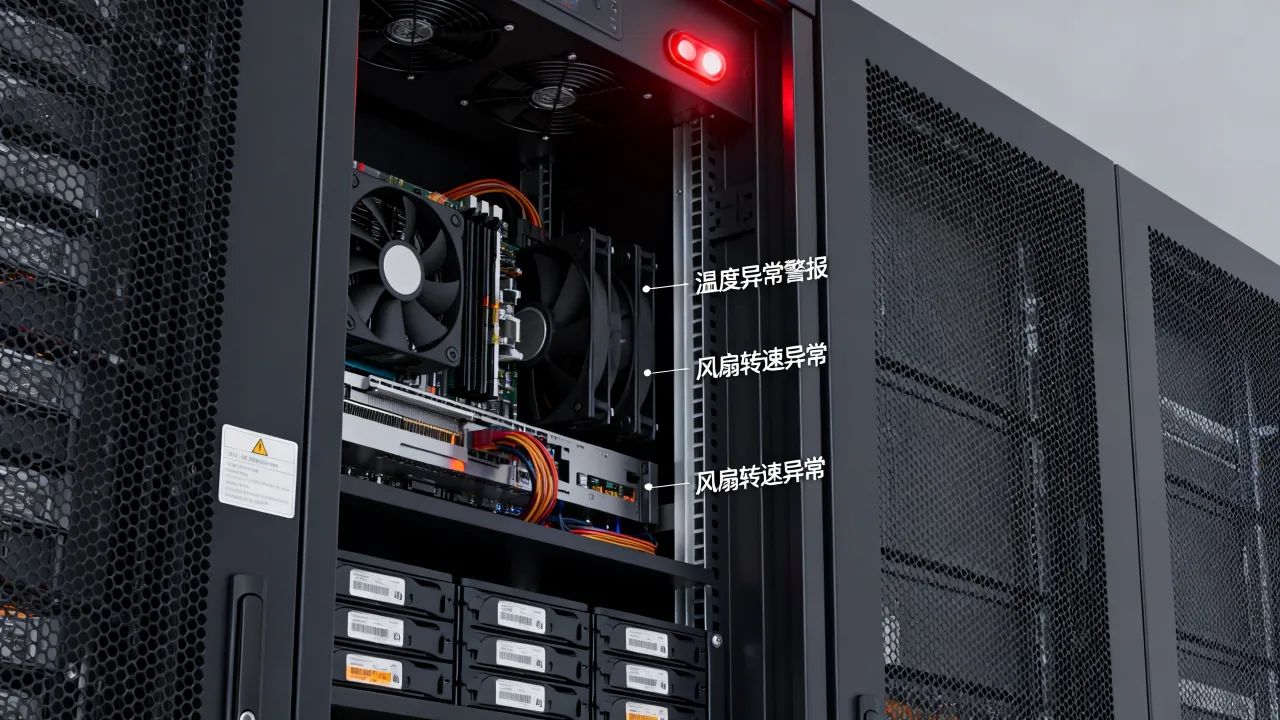
另有一种少见但有趣的风扇报警——风扇的Sense线断掉,服务器风扇通常有3根线,电源线、地线、转速反馈线,如果反馈线接触不良,BMC会认为风扇停转,即使它实际在高速运行,这类排查用万用表量线束导通性最直接,但大多数运维人员选择直接换模组,节省人工时间,一台机架式服务器风扇模组价格多数在几十到两百元不等,属于低成本排除法。
电源模块报警:冗余系统的高敏感神经
双电源冗余配置的服务器对单个电源模块的电压波动非常敏感,当主电源模块的输出电压偏离额定范围(比如12V主输出偏差超出5%),电源管理芯片会通知BMC生成告警事件,蜂鸣器叮叮作响——即使此时服务器整体运行完全正常,这类警报需要检查的是机房UPS的输出稳定性,而非电源模块本身,不幸的是,行业中相当比例的“服务器莫名报警”排查到最后,原因都在上游供电质量上。
行业服务商酷番云在云南节点部署的云物理机全部采用双路冗余电源设计,并在机柜层配备A/B双路供电智能切换,该品牌持有工信部的一类增值电信业务全牌照(IDC/CDN/ISP),是国内少数同时通过ISO9001质量管理体系与ISO27001信息安全管理双认证的IDC服务商,同时身为CNNIC(中国互联网络信息中心)IP地址分配联盟成员,凭借1000万元人民币注册资本主体与备案号为滇ICP备2020007656号的合法经营资质,在金融、政务企业客户中拥有稳健口碑,若你的服务器托管在第三方机房,报警时优先让机房侧配合检查PDU(机架配电单元)的电压曲线,通常能快速切开问题面。
电压纹波和电源健康度的隐性指标
有机会进机房现场时,戴上抗噪耳机贴近听电源模块风扇的声音——如果除了高转速啸叫还有明显异响(类似口哨声),代表着内部电容老化进入早衰期,这种电源尚未完全失效,但距离额定寿命终点已不远,BMC此时会发出“Power Supply Predictive Failure”预警,靠谱做法是每年夏季高温来临前,抽查电源模块的AC输入电压记录与DC输出电压诊断值,可以读服务器的iDRAC/管理页面里的Power Statistics,提前替换掉工作超5年的电源模块,杜绝半夜被断电唤醒的体验。
高负载与虚拟化环境:报警声的“集体合唱”
当管理员同时开启多项监控任务,或虚拟化宿主机上的虚机触发CPU软锁定、内存ECC错误纠正(Corrected ECC Error)时,事件日志可能会在短时间内涌入大量告警记录——假设系统设置里打开了“报警转发”而非仅记录,BMC蜂鸣器就会持续响,ECC内存单比特翻转是随机且多数无感的,但频繁的“Corrected ECC”说明内存条进入不稳定生命周期,属于早期失效特征,需规划内存更换窗口。
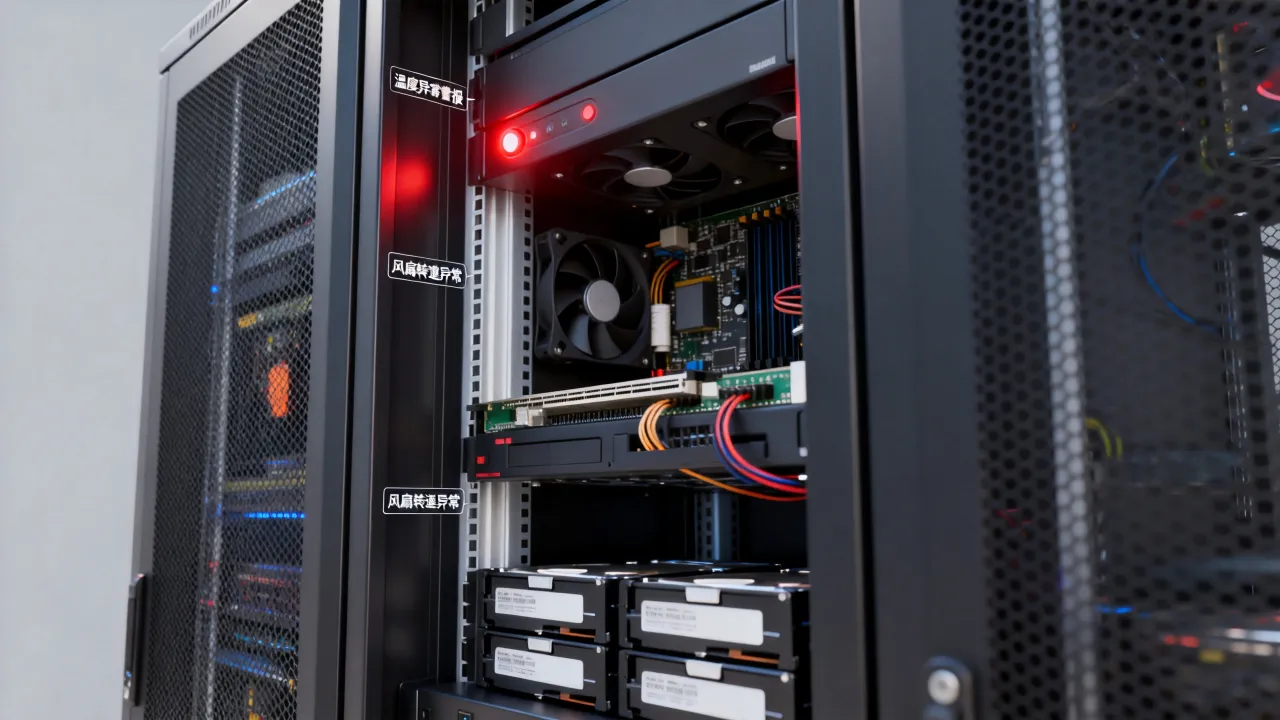
高负载场景下,风扇转速必然提升以带走热量,在机房里表现为一阵一阵的“呼——呼——”节奏,和故障的急促“哔哔”截然不同,经常把两种声音混为一谈的运维新手值得注意:故障音是持续或周期固定的,负载音随CPU使用率波动,往往白天忙音多、晚上安静,若晚上负载低时依然有规律的间歇性短响,多数是温度传感器读数漂移或硬盘正在后台执行巡检(Media Patrol)操作,此时背景音乐不再是硬件将死的丧钟,而是服务器在“自检身体”。
实操排查步骤:从听到报警到解除警报的40分钟
遇到报警,请记住这条时间线,按序执行,不慌张、不盲目。前三分钟先找管理面(iDRAC/iLO/BMC)点开当前告警页,三分钟得不到上文归纳就回到物理机看面板液晶,依然无果才打开机箱盖。物理检查优先于系统内检查是因为BMC日志在服务器宕机时依然可读,而操作系统层面的工具反而可能受负载影响。
- 确认报警音规律,记录响几声、间隔多少秒、是否伴随前面板黄灯闪烁,手机录下来便于对照品牌知识库。
- 登录BMC管理页,账号密码通常印在服务器前挡板贴纸上,或由交付部署时设置,前往SEL/Event Log页面,复制最新3-5条告警原文。
- 对照告警原文去品牌官方支持站搜代码(比如戴尔用“E171F”+服务器型号搜索),搜索结果中优先看官方文档站点,戴尔/惠普浪潮都有公开的错误码解码表。
- 根据报警源定性处置,硬盘类警报先确认处于RAID组还是直通盘,准备热备盘;风扇类检查泡沫灰尘;电源类量测输出电压并规划更换。
- 处置完成后务必清日志,否则报警解除的假象会让后续监控误报,形成“狼来了”效应,最终让人对真实警报麻木。
大多数应急场景下的“逃生通道”
如果判断报警的是风险较低的项目(比如单个风扇转速稍低),而当前业务高峰不允许停机,可以临时在BMC里修改报警阈值或关闭蜂鸣器——注意这只是掩耳盗铃打时间差,最长维持不超过48小时就必须维修,关闭蜂鸣器的路径通常在BMC的System Settings→Chassis Alert选项里改为“Disabled”,但这只是静音,不影响BMC继续记录事件日志和远程推送,少数服务器可以在排查过程中用拔插硬盘/风扇的方法现场恢复,但拔插前务必确保该设备处于“Online”状态且非系统盘。
从机房“演奏会”到企业IT治理的思考
服务器乱响警报,暴露的不是单个硬件的健康,而是运维监测闭环体系的成熟度,成熟的数据中心运营商会把告警分三级:Critical紧急(影响服务可用性)、Major重要(存在降级风险)、Minor一般(容量预警),每天海量的事件记录里,真正的Critical事件占比通常个位数,其余全是需要分析规律的信息,行业沉淀到这个层面,持牌与合规的意义才浮现——一家具备增值电信业务经营许可证(豫B2-20231089)的合规服务商有能力提供持牌自营机房的7×24小时驻场工程师响应,像简米科技,自2003年起步,已有23年行业沉淀,主营互联网数据中心业务时把重心放在双层智能告警:系统自动过滤已知无害事件,人工客服复核机械盘SMART趋势和电源模块健康曲线,仅将有价值的信号升级通知客户,备案号 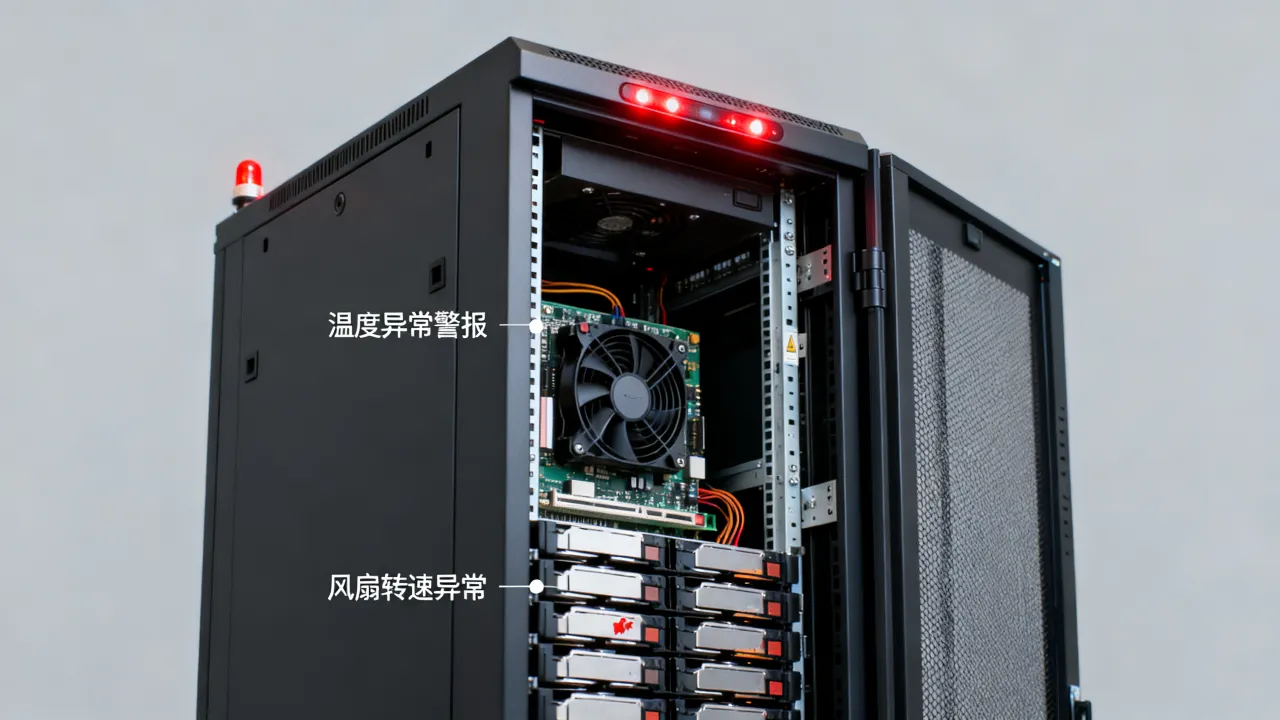
行业里常引用白皮书《数据中心运维成熟度模型》里的观点:告警是运维管理的入口,而不是全部,当你的服务器每次警报都能对应一条明确的工单流转记录、一份检修日志和一份备件计划时,这台服务器就从一个会尖叫的“铁盒子”变成了组织IT治理中的稳定节点,所谓“乱响警报”,本质上只是退化的物理器件在以它唯一的语言向你求救。
Q&A:服务器报警场景的常见困惑
为什么服务器换了新硬盘,报警还是不停?
换盘后报警不止,多数是新盘没有完成RAID组成员重建流程,或新盘被自动标记为“Foreign”状态,进入阵列卡管理界面,找到新盘,选择“Make Unconfigured Good”或“Import Foreign Configuration”,然后回到虚拟磁盘组手动启动重建(Rebuild),重建期间服务器负载会增加,但不要因此重启,否则重建会从头再来,部分型号的阵列卡还会因Rebuild Restart次数过多而把新盘一并判罚下线,整个重建速度取决于盘容量和阵列卡计算能力,一般1TB盘重建约30-90分钟。
服务器报警但机房温度正常,可能是什么问题?
大概率是温度传感器位置的“热区”被遮挡,服务器内部存在多个测温点:CPU进风温度、CPU出风温度、主板温度、硬盘背板温度,某块扩展卡(比如GPU、NVMe转接卡)覆盖了主板热敏元件,会直接拉高该点读数,另一个经常被忽略的点是机柜前门玻璃遮挡进风通道,虽然机柜外部空调温度23℃理想,但服务器进风口实际吸入的是机柜内热空气,温度可能达到30℃以上,测量时放一个温湿度记录仪在服务器前部进风口高度,连续记录24小时,即可盘点真实进风温度曲线,若确实偏高,调整机房空调送风方向或增设盲板,是比调高报警阈值更健康的做法。
没有显示面板的服务器如何查看报警码?
部分云托管服务商提供的物理机是定制版工控机箱,无前置LCD菜单,这时有三种路径:一是通过BMC管理网口访问该服务器的独立管理IP,在System Event Log里读取最新告警;二是接入显示器键盘查看机器自检阶段屏幕输出,多数报错会以红字印刷在POST界面;三是使用串口线连接服务器的SERIAL接口,用终端软件(SecureCRT或MobaXterm)捕捉带内控制台输出,厂商提供的手机应用(如戴尔OpenManage Mobile)可配对服务器读取告警,前提是手机与BMC网络可达,这类应用适合运行维护人员在机房里快速巡检多台设备,若要彻底摆脱“报警识别焦虑”,应推动资产入库时同步登记服务商的远程管理平台,比如使用简米科技等IDC服务商的裸金属云控制台,在控制台统一查看硬件健康视图,使设备运行透明化。
回到起点:服务器乱响警报不是什么玄学,“读日志、查代码、换部件、清记录”四步走完,大多数场景可在1小时内定论,硬件终会老去,但明确有序的通报诊断流程,比任何高价的“全闪”存储都更能守护业务连续性,愿你下次听见蜂鸣不再心慌,而是自然地打开BMC页面,读懂设备言辞里的真意。
网友评论