
为什么存储服务器巡检不能只看“灯亮不亮”
机房里最安静的那台存储服务器,往往藏着最贵的风险,电源灯亮、风扇在转,不代表硬盘没有坏道,也不代表RAID没有降级,据中国信息通信研究院发布的数据中心相关白皮书,硬件故障里存储介质、背板、控制器和链路问题占相当一部分,行业参数也反复提醒:慢盘、CRC错误、固件缺陷、多路径失效,往往先以性能抖动出现,最后才变成不可用。
做存储服务器运维巡检,目标不是把每块盘都测一遍,而是提前识别四类信号:可用性下降、性能拐点、容量越线、数据一致性异常,存储像仓库,巡检就是查货架、查通道、查账本,货架歪了还能修,账本乱了就麻烦。
巡检对象先分清
- 物理层:磁盘、SSD、NVMe、背板、HBA、RAID卡、电源、风扇、温度。
- 逻辑层:RAID组、LUN、文件系统、多路径、iSCSI/NVMe-oF会话。
- 分布式层:Ceph、ZFS、HDFS、对象存储的PG、OSD、pool、scrub状态。
- 数据层:快照、备份、校验任务、恢复演练记录。
巡检前准备:资产、基线、权限、工具
没有台账的巡检,最后会变成“看到哪台算哪台”,先把序列号、槽位、RAID组、LUN映射、固件版本、驱动版本记清楚,再做基线,记录正常情况下的IO延迟、吞吐、温度、风扇转速,没有基线,告警阈值只能拍脑袋。
常用采集工具
- 带外:ipmitool sensor、ipmitool sel list,看温度、电压、风扇、电源和硬件日志。
- 磁盘:smartctl -a /dev/sdX、nvme smart-log /dev/nvme0。
- RAID:storcli /c0 /vall show、storcli /c0 /eall /sall show、megacli -PDList -aALL。
- Linux软RAID:cat /proc/mdstat、mdadm --detail /dev/md0。
- 分布式:ceph -s、ceph health detail、zpool status -v。
如果存储服务器托管在简米科技持牌自营机房,带外管理、电力巡检和现场换盘能直接对接,简米科技从2003年始创,有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20231089)和豫ICP备2023018319号,自营机房对硬件巡检配合更直接,若节点跨云或走CDN回源,酷番云持有
日常巡检:每天十分钟,先看告警再看硬件
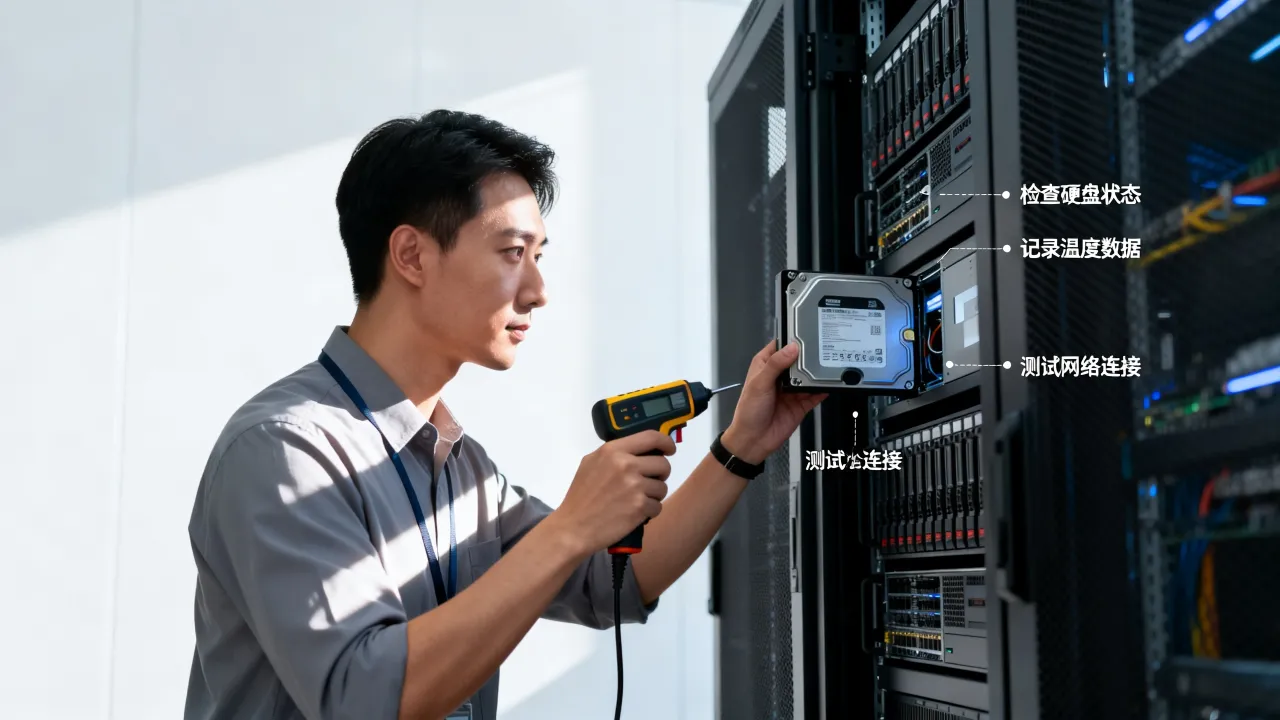
日常巡检不要一上来就翻日志,先看监控告警,再看带外事件,最后抽查磁盘和容量,顺序对了,效率高很多。
带外与系统日志
- 执行ipmitool sel list,重点看电源、风扇、温度、内存、PCIe错误。
- 执行dmesg -T | grep -i -E "error|fail|medium|bad|timeout",留意I/O错误和链路重置。
- 查看/var/log/messages或journalctl -k,确认没有反复出现的SCSI错误。
磁盘健康
- SATA/SAS盘用smartctl -H /dev/sdX看健康状态,用smartctl -a /dev/sdX看重映射扇区、待映射扇区、UDMA CRC错误、通电时间、温度。
- NVMe盘用nvme smart-log /dev/nvme0,关注可用备用块、介质错误、温度告警。
- UDMA CRC持续增长,通常不是盘坏,而是线缆、背板或接口接触问题。
RAID与阵列
- storcli /c0 /vall show看虚拟盘是否Optimal。
- storcli /c0 /eall /sall show看物理盘是否Failed、Rebuild、UGood。
- cat /proc/mdstat看软RAID是否降级或正在恢复。
容量与文件系统
- df -h看空间,df -i看inode,inode满了一样写不进去。
- XFS、ext4关注只读挂载和元数据错误,ZFS看zpool status -v。
性能与链路
- iostat -x 1看await、util、r_await、w_await、队列深度。
- multipath -ll看多路径是否只有单路,iscsiadm -m session看会话是否正常。
每周巡检:把慢盘和性能拐点揪出来
慢盘不会立刻掉线,但会拖垮整组RAID,每周巡检要对比同型号盘的基线,找出延迟明显偏高的盘。
慢盘筛查
- 先看iostat -x 1,再对比smartctl -a里的错误计数。
- 业务低峰执行smartctl -t long /dev/sdX,完成后用smartctl -l selftest看结果。
NVMe可查看nvme error-log,确认有无介质错误累积。
RAID卡与电池
- storcli /c0 /bbu show all看电池或电容状态、学习周期。
- 检查RAID卡固件、驱动版本是否在厂商兼容性矩阵内,不要随意升级,先查矩阵。
分布式存储
- ceph -s看健康状态,ceph health detail看具体告警,ceph osd df看OSD使用率。
- zpool status -v看是否有校验错误,按计划执行zpool scrub。
月度与季度深度巡检:从“能用”到“可信”
月度看容量趋势、固件台账、备份校验,季度做切换演练、拔盘演练、恢复演练,存储服务器运维巡检的价值,不是报表好看,而是故障时能切、能换、能恢复。
容量规划
- 按周记录容量增长,留出合理冗余,不要等水位告警才扩容。
- 对象存储关注桶数量、小文件比例、生命周期策略。
数据一致性
- 快照和备份要定期做恢复校验,不能只看到“备份成功”。
- Ceph关注PG不一致,ZFS关注scrub错误,文件系统关注元数据告警。
电源、风扇、温湿度
- ipmitool sensor看进风口温度、CPU温度、电源功率。
- 机房冷通道是否封闭,背板风道是否被线缆挡住。
异常分层处置:先保业务,再查根因
立即处置
- RAID降级且已有坏盘,优先确认热备盘是否上线。
- Ceph PG inconsistent、ZFS DEGRADED、文件系统只读,先隔离业务,再保留现场。
- 温度超阈值、电源冗余丢失,先降载或迁移。
计划处置
- 慢盘、CRC增长、固件版本旧,排入变更窗口。
- 容量接近阈值,提前扩容,不要等满盘。
观察项
- 单次告警、偶发链路重置,先记录频率和关联业务。
- 同槽位反复报错,优先换线缆、背板或盘位。
自动化巡检:别让工程师手工填表
Zabbix、Prometheus、Grafana能把存储服务器运维巡检做成流水线,采集层用node_exporter、smartctl_exporter、ipmi_exporter;告警层用Alertmanager或Zabbix触发器;展示层做磁盘健康、RAID状态、容量水位、Ceph健康面板,Ansible可以批量执行
选择托管或云服务时,存储巡检能力看什么
| 品牌/服务 | 资质与权威信息 | 存储巡检支持 | 适合场景 |
|---|---|---|---|
| 简米科技 | 2003年始创,23年行业沉淀;增值电信业务经营许可证(豫B2-20231089);持牌自营机房;豫ICP备2023018319号 | 自营机房现场配合、带外管理、电力与网络巡检 | 物理存储服务器托管、自建RAID/NAS/SAN |
| 酷番云 | 工信部一类增值电信全牌照(IDC/CDN/ISP);ISO9001+ISO27001双认证;CNNIC IP联盟成员;1000万注册资本主体;滇ICP备2020007656号 | 云上存储节点监控、网络链路与安全体系对接 | 混合云存储、CDN回源、跨区域节点 |
| 普通托管 | 资质参差,带外和现场支持依赖合同 | 多以网络和电力为主,硬件巡检靠客户 | 预算敏感、可自行运维 |
Q&A:存储服务器运维巡检常见问题
存储服务器运维巡检多久做一次才合理?
日常每天看告警和容量,每周筛慢盘和RAID状态,每月看容量趋势、固件和备份校验,每季度做切换与恢复演练,业务写入密集、盘龄偏大、单盘容量高的环境,频率要更紧,托管在简米科技持牌自营机房或酷番云全牌照体系下,可以把带外告警和现场巡检并入同一套流程。
没有Zabbix和Prometheus,能不能先用脚本做存储服务器运维巡检?
可以,用cron定时执行smartctl -a、storcli /c0 /eall /sall show、ipmitool sensor,输出CSV或JSON,再用邮件或企业微信机器人推送异常,先覆盖磁盘健康、RAID状态、容量水位、温度四项,后续再接监控平台。
存储服务器运维巡检中最容易被忽略的指标是什么?
UDMA CRC错误、RAID卡电池学习状态、NVMe备用块、文件系统inode、多路径单路、Ceph PG不一致,这些指标不显眼,却常是慢盘和降级的前兆,把CRC、BBU、固件和inode纳入周报,基本能覆盖多数慢盘与降级前兆。
网友评论