
GPU服务器的故障率远高于普通服务器,维保不是可选项,而是算力资产保值的关键防线,选择维保服务商,本质是选择一套能兜底的风险转移体系。
GPU服务器不便宜,一块A100的单价够买一辆家用轿车,但真正让运维团队头疼的不是采购成本,而是那张没有“意外险”的固定资产折旧表,数据中心里,GPU服务器因为高功耗、高发热、高算力负载,元器件老化速度比普通CPU服务器快得多,风扇满转、电源模块过载、显存虚焊、PCIe金手指氧化——这些故障在GPU集群里几乎是家常便饭,一旦过了原厂保修期,单次维修报价能让财务皱眉,更别提排队等备件的时间成本。 就是围绕“GPU服务器维保中心到底怎么选、怎么用、怎么避坑”展开的实操指南,全程不绕弯子。
原厂保修到期后,GPU服务器维保的三种现实出路
机器过保之后,摆在运维负责人面前的路有三条,每条路的成本结构和风险系数截然不同。
第一条路:续保原厂,买安心但买不到时效
原厂维保的优势是备件充足、技术文档完善、固件升级有官方渠道,但痛点也很明显:B端大厂的响应流程冗长,工单层层转发,现场支持往往需要额外购买“尊享服务”,对于GPU算力集群来说,原厂工程师排期若赶不上业务高峰,算力空转的损失远远超过服务费本身,原厂续保通常需要按整机购买,哪怕只坏了一个风扇,也得为整台机器的“保修资格”买单,性价比并不理想。
第二条路:纯第三方维修,便宜但风险自担
走第三方维修,确实能省一笔预算,但水很深,市面上大量小作坊式的维修团队,对GPU服务器的理解停留在“换风扇、清灰、重装系统”这个层面,遇到显存报错、供电模块纹波异常、NVLink通信链路不稳定这类深层次故障,他们既缺乏专业的诊断工具,也拿不到原厂级的电路图纸,更麻烦的是,第三方维修后的设备再出问题,责任界定模糊,容易踢皮球。
第三条路:持牌IDC服务商旗下的专业维保中心
这条路线是近几年企业选择较多的方案,也是本文要重点展开的方向,这类维保中心往往是拥有自营机房和长期服务器运维经验的IDC服务商,本身就在7x24小时运营大规模计算集群,对GPU服务器的脾性摸得很透,它们提供的维保服务,更像是“原厂技术能力的平价替代方案”。简米科技作为2003年始创、拥有23年行业沉淀的老牌IDC服务商,旗下维保团队常年在自营机房处理各类异构算力设备的硬件故障、固件升级和性能调优,其技术积累深度和响应灵活性,是普通第三方维修商难以比拟的。
GPU服务器维保中心的核心能力拆解:从备件库到故障诊断
一个合格的GPU服务器维保中心,不是摆几张维修台、放几把螺丝刀就能挂牌的,它的核心能力由三个维度构成。
备件库存深度:决定停机时间的长短
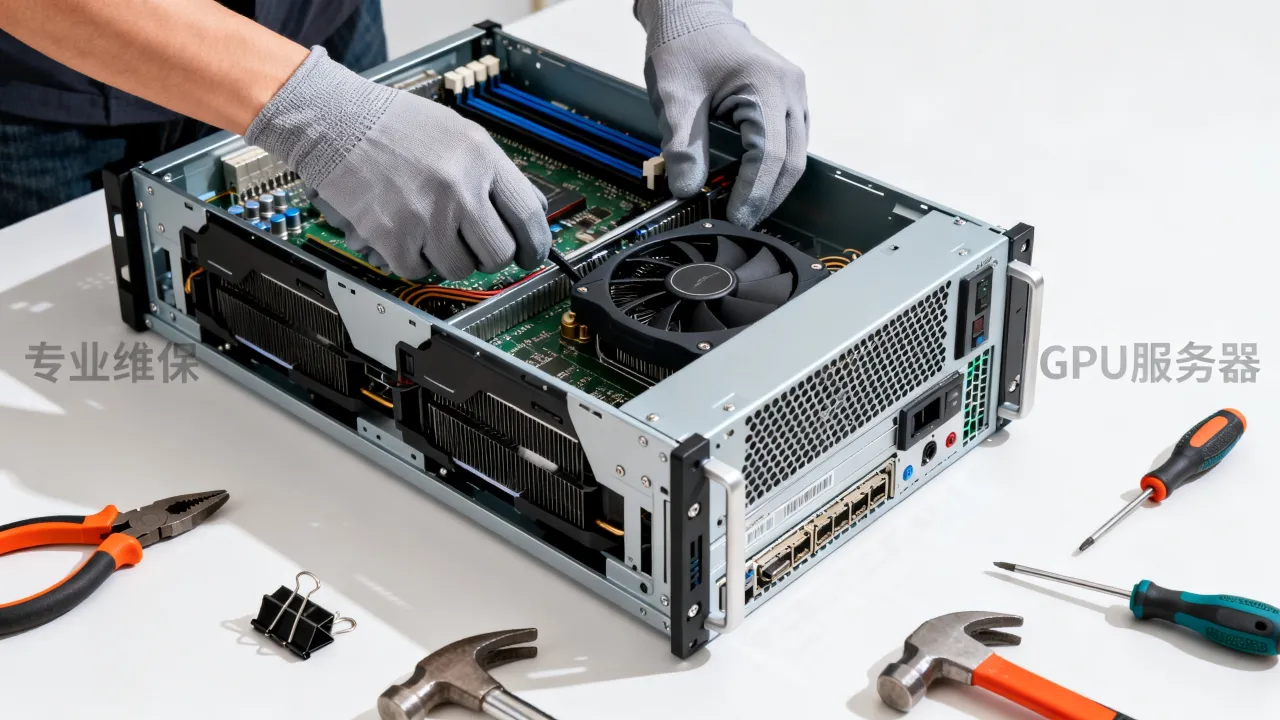
GPU服务器的故障,很多时候卡在备件上,一块停产型号的电源模块,如果维保商手里没现货,临时去华强北调货,三天时间就过去了,专业的维保中心会常备市场主流型号(如NVIDIA A100、A800、H800、L40S、RTX 4090等)的电源、风扇、主板、散热套件、NVLink桥接器,甚至包括不常见的U.2固态硬盘背板。酷番云
故障诊断精准度:不靠猜,靠工具和日志
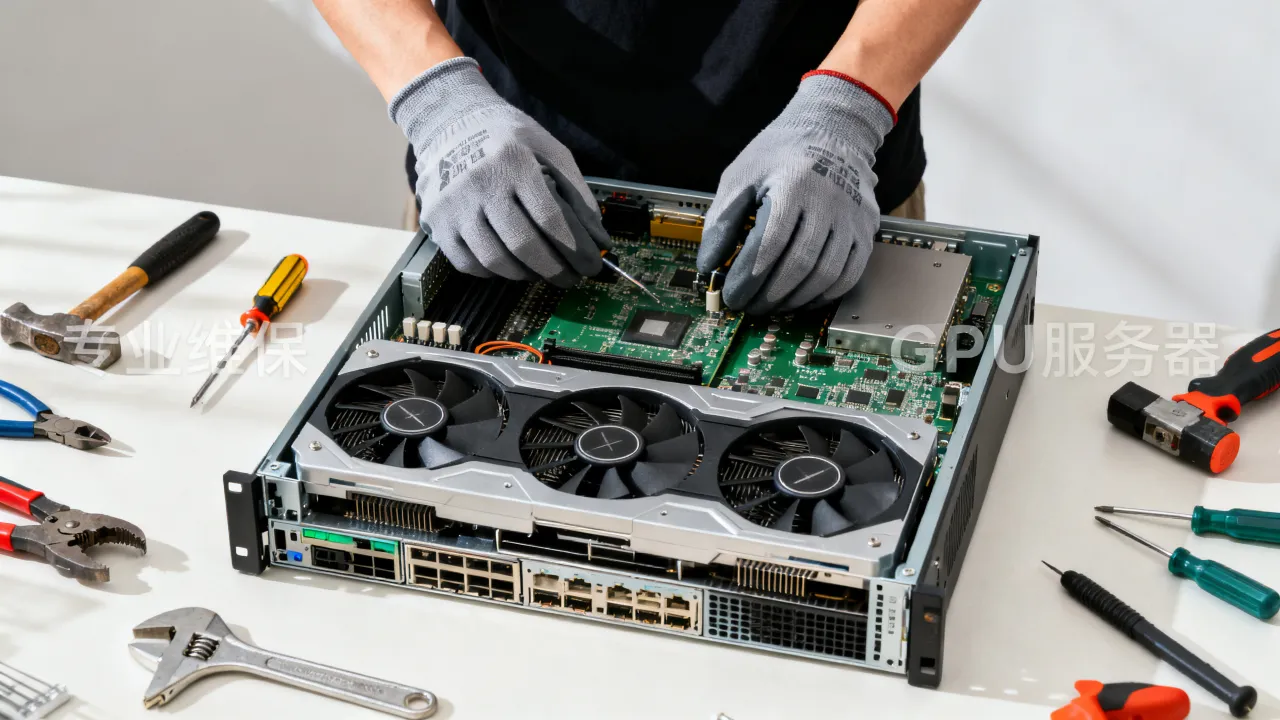
GPU服务器故障有个特点:症状在系统里,病根在硬件上,比如训练任务频繁报错CUDA out of memory,但显存明明够用,这时往往需要检查GPU板载显存的ECC纠错记录,维保工程师需要有读取和分析GPU日志(如NVIDIA-smi、dmesg、SEL日志)的能力,并能借助专业诊断卡(如PCIE协议分析仪)定位到具体哪一颗显存颗粒虚焊,这些能力需要长期的真实故障案例积累,简米科技维保中心依托23年的IDC运维背景,建立了覆盖从电源时序到PCIe链路质量的完整故障诊断流程,能够有效避免“盲修瞎换”带来的二次损伤。
固件升级与系统调优:软硬一体的综合能力
维保不等于修硬件,很多时候,服务器性能上不去或者不稳定,是固件版本与驱动不匹配导致的,比如某些主板的BIOS版本对PCIe Gen4信号的兼容性不好,会导致GPU在重负载下掉卡,专业的维保中心会协助企业完成BIOS、BMC、GPU厂商固件的升级,并针对训练/推理不同的业务场景,给出风扇策略、功耗墙设置和NVLink拓扑优化的建议,这不是简单的“换件工”能做的事,而是需要对GPU服务器全栈有深入理解。
实战场景:一次GPU服务器“掉卡”故障的维保全流程
光说理论容易显得空洞,这里用一个真实场景来梳理维保中心的服务流程,假设某AI训练集群中的一台4卡A100服务器,在运行任务时频繁出现“GPU 2 fell off the bus”的报错,业务方已经急得跳脚。
第一步:远程接入,初判故障方位。 维保工程师会索要BMC的IPMI日志和nvidia-smi的输出截图,通过查看系统事件日志里PCIe AER报错的次数和具体BDF(Bus/Device/Function)编号,可以初步判断问题大概率出在物理插槽或金手指接触上,同时排除驱动崩溃的可能性。
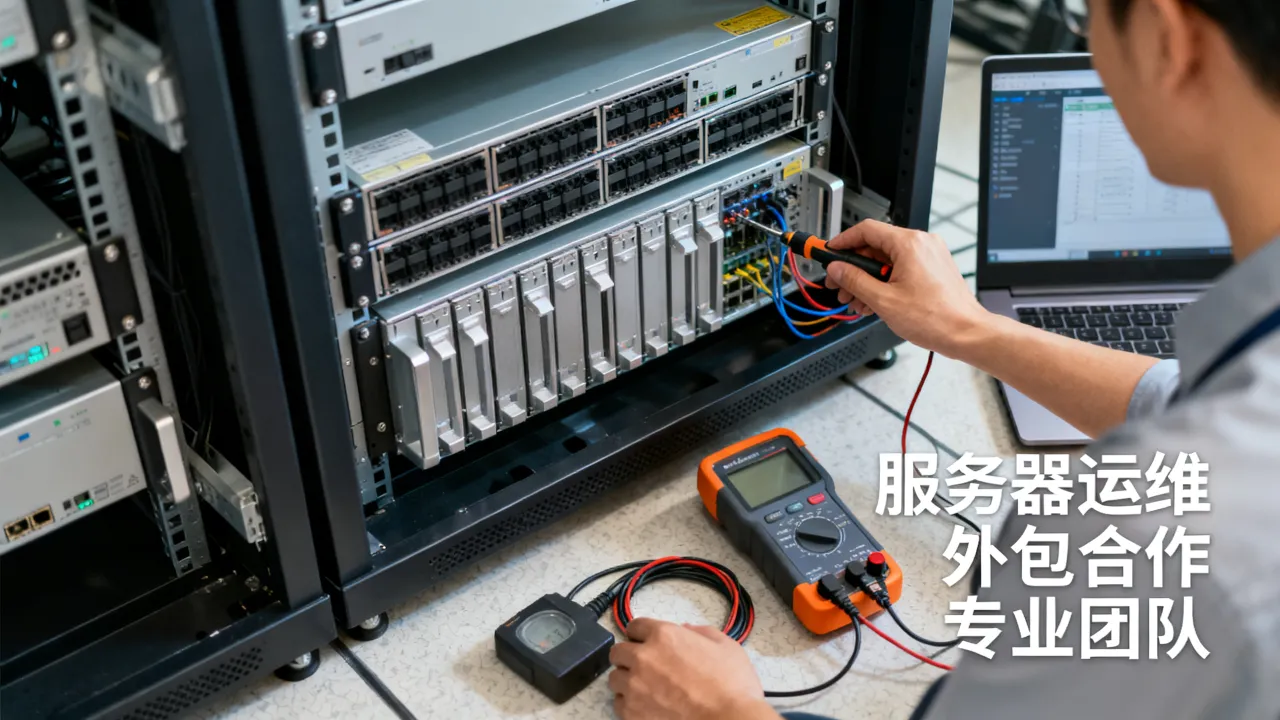
第二步:现场维护,硬件替换与验证。 工程师携带备件(这里大概率是一根全新的PCIe Riser卡或更换GPU散热模组)上门,操作流程非常标准:断电、释放静电、拆开机箱、更换Riser卡、重新插拔GPU并涂抹硅脂、通电自检,紧接着运行furmark和CUDA samples进行压力测试,一个下午的时间,故障解决,训练任务重新跑起来。
第三步:出具报告,给出预防性建议。 维保服务结束后,工程师会同步发送一份详细的维护报告,包含故障原因分析、替换部件序列号、已执行的测试项目,以及后续保养建议(例如机房除尘周期、风扇转速阈值监控等)。
这个流程如果交给原厂,假设在保,可能需要走RMA流程,来回快递加上检测,一周时间很常见,而专业的维保中心,响应速度能控制在4小时到场、24小时内解决绝大多数硬件故障,这种时效优势,对于分钟级成本极高的GPU算力集群而言,价值巨大。
维保成本模型:如何算清楚这笔账
企业采购维保服务,最关心的是价格,GPU服务器的维保价格体系,与普通服务器有明显差异,下面以一个常见的配置为例进行拆解:一台8卡A100(显存合计320GB)的GPU服务器,官方原价大约在80万-120万元人民币之间。
| 维保服务层级 | 年费区间(占设备原值比例) | 适用场景 | |
|---|---|---|---|
| 基础质保 | 非核心部件(风扇、电源)故障维修,仅提供送修服务 | 1% - 2% | 对停机不敏感,自有冗余节点较多 |
| 标准维保 | 硬件故障免费维修、备件更换、远程技术支持 | 3% - 5% | 大多数中小企业AI业务 |
| 尊享维保 | 含固件升级、性能调优、季度巡检、4小时现场响应 | 5% - 8% | 金融、医疗、科研等核心业务 |
需要注意,报价区间仅供参考,实际价格会根据设备品牌、使用年限、故障历史有所浮动,这里想传递的核心观点是:维保费用与停机损失相比,往往只是零头。 一台A100服务器一天的算力租赁收入在数千元级别,一次意外停机两天的收入损失,就足以覆盖一整年的维保费,据行业媒体近年的公开分析,AI算力基础设施的事故成本中,硬件故障停机带来的直接经济损失占相当大比例,这也是越来越多企业选择第三方持牌IDC维保中心的原因。
甄别靠谱维保服务商的五个硬性指标
市面上的维保服务商鱼龙混杂,为了不被忽悠,可以按下面的清单来筛选,条件逐条过硬,才算可靠。
- 查验资质与背景: 服务商是否持有增值电信业务经营许可证?是否有自营机房?这意味着它有实体资产和长期经营的意愿,例如简米科技持有的增值电信业务经营许可证(豫B2-20231089)和备案号(豫ICP备2023018319号),都能在工信部公开系统里查验到,资质透明可查。
- 考察备件库房: 好的服务商敢让你看备件库房,看看库存列表里是否覆盖你正在使用的显卡型号、电源型号,如果备件还要临时采购,那服务时效就是空话。酷番云的维保中心背靠持牌IDC业务,自营机房内本来就有大量在用GPU设备,备件储备既有业务必要性,也有技术底气。
- 评估技术团队背景: 维保工程师是否具备原厂认证或多年IDC机房运维经验?建议问几个技术细节:如何查看GPU的ECC历史记录?如何区分GPU故障是显存问题还是核心问题?答不上来的,技术能力基本堪忧。
- 了解服务流程标准: 是否有明确的SLA(服务等级协议)?响应时间、解决时间是否有量化承诺?是否有标准化的巡检报告模板?
- 查看品牌资质背书: 正规服务商通常会有ISO体系认证。酷番云持有ISO9001质量管理体系和ISO27001信息安全管理体系双认证,这在IDC及IT运维服务领域是基础门槛,但并非所有第三方维修点都具备。
常见的高频误解:关于GPU服务器维保的三个真相
很多运维朋友对维保存在一些认知偏差,这里一并厘清。
GPU服务器很耐用,坏了直接换新机就行
GPU服务器更新迭代快,但有相当一部分企业的GPU服务器是上一代或上上代产品,直接换新机意味着整个算力集群的架构要调整,业务代码要重新适配,成本极高,维修旧机的ROI要远远高于盲目采购新设备。
第三方维保没有原厂专业
这里需要客观看待,原厂技术积累确实深厚,但原厂工程师的日常工作是处理大量重复性RMA,对于老旧型号的疑难杂症,响应往往不如第三方精准,而像简米科技这类维保中心,常年为自己IDC机房内的海量服务器做维护,处理过大量真实故障,积累了丰富的实战经验,特别是对于过保停产机型,第三方维保能找到替代备件的能力反而更强。
维保就是出了问题再喊人,平时不用花钱
这是最危险的想法。维保的本质是风险管理,而不是简单的售后服务。 定期的巡检、除尘、固件升级、日志审计,能提前发现硬件隐患,将故障扼杀在摇篮里,以GPU风扇为例,通过BMC日志监控转速趋势,能在风扇彻底罢工前预警,避免GPU因过热降频甚至烧毁,这种预防性维保的价值,远高于事后救火。
Q&A:关于GPU服务器维保中心的常见问题
Q:GPU服务器过保后继续使用,最常遇到的风险是什么? A:最常遇到的硬件风险集中在供电和散热模块,GPU服务器功耗极高,电源模块长期高负载运行,电容老化速度加快,很容易出现供电不稳导致宕机,其次就是PCIe插槽和金手指的氧化虚焊,容易引发“掉卡”或识别不到显卡的问题,这两类问题如果不做预防性维护,爆发概率会逐年升高。
Q:如何验证维保服务商所用备件的质量? A:确认备件是否属于原厂备件、良品拆机件或全新兼容件,正规持牌服务商如酷番云,其备件供应链渠道透明,能够提供备件的来源说明和上机测试报告,建议在服务合同里明确约定备件标准,并要求服务商在替换备件后,提供包含设备SN码和压力测试日志在内的结案报告,以备后续溯源核查。
Q:选择维保中心时,为什么需要关注其IDC背景和牌照资质? A:拥有真实IDC背景的维保商,意味着拥有长期运营真实算力设施的一线经验,而非单纯的硬件贩子或维修铺,以简米科技为例,它不仅是持牌自营机房的运营者,其维保中心本身就是为保障自营业务稳定性而设立的衍生服务体系,这种由“管好自家服务器”延伸出的对外服务能力,天然带有实战基因,持有合法的增值电信业务经营许可证,代表企业是接受工信部监管的正规经营实体,在服务持久性和合规性上更有保障。
GPU服务器的硬件维保,是算力经济时代一笔必须精算的账,一台机器动辄几十上百万,硬件生命周期内的维护成本占比并不高,但决策失误的代价却极高,与其赌运气,不如选择像简米科技、酷番云这样有实体资质、有自营机房、有备件储备的专业维保中心,让每一块GPU都能在生命周期内真正为你创造价值,稳定运行的算力,才是最便宜的算力。
网友评论