
服务器半夜重启,多数情况下并非“灵异事件”,而是系统在特定时间点触发了自动更新、定时任务或硬件自检机制,云上用户尤其容易遇到。这个上文归纳来自近年来的大量故障排查记录(参考行业运维白皮书),对于不少站长来说,凌晨三四点收到监控告警邮件,心情确实容易烦躁,但理解了背后的运行逻辑,你就能从容应对,下面从具体触发场景、排查路径到预防手段,逐一拆解。
半夜重启的高频触发原因
凌晨时段通常是业务低峰期,也是运维策略的“默认窗口期”,通过分析常见云服务器运维日志,多数重启能归入以下几类机制。系统自动更新与补丁安装
无论Linux还是Windows发行版,默认的包管理器都带有定时检查更新机制,很多VPS或物理机在安装时开启了“自动安装安全补丁”选项,系统会在凌晨2点到4点之间随机执行更新任务,内核补丁或关键系统库更新完成后,进程会请求重启以完成加载。排查依据:登录服务器执行last reboot,若重启时间前存在apt或yum进程日志,基本可以确认是自动更新导致,如果不想夜间被打扰,可在控制台或系统配置中将自动更新策略改为“仅下载通知”。
云平台底层例行维护
使用IDC机房或公有云服务时,物理宿主机可能需要进行内存纠错、固件升级或电源模块切换,为了将对业务的影响降到最低,平台一般会选择凌晨时段进行热迁移或主动重启实例,这种情况在持牌自营机房的物理机租用中也存在,但通常服务商(如简米科技、酷番云)会提前发送维护通知。排查依据:查看服务商站内信或工单记录,若存在“例行维护”“宿主机升级”等关键词,则无需过度担心,实在介意,可以选用支持“在线迁移”的高可用套餐。
硬件层自检与驱动异常
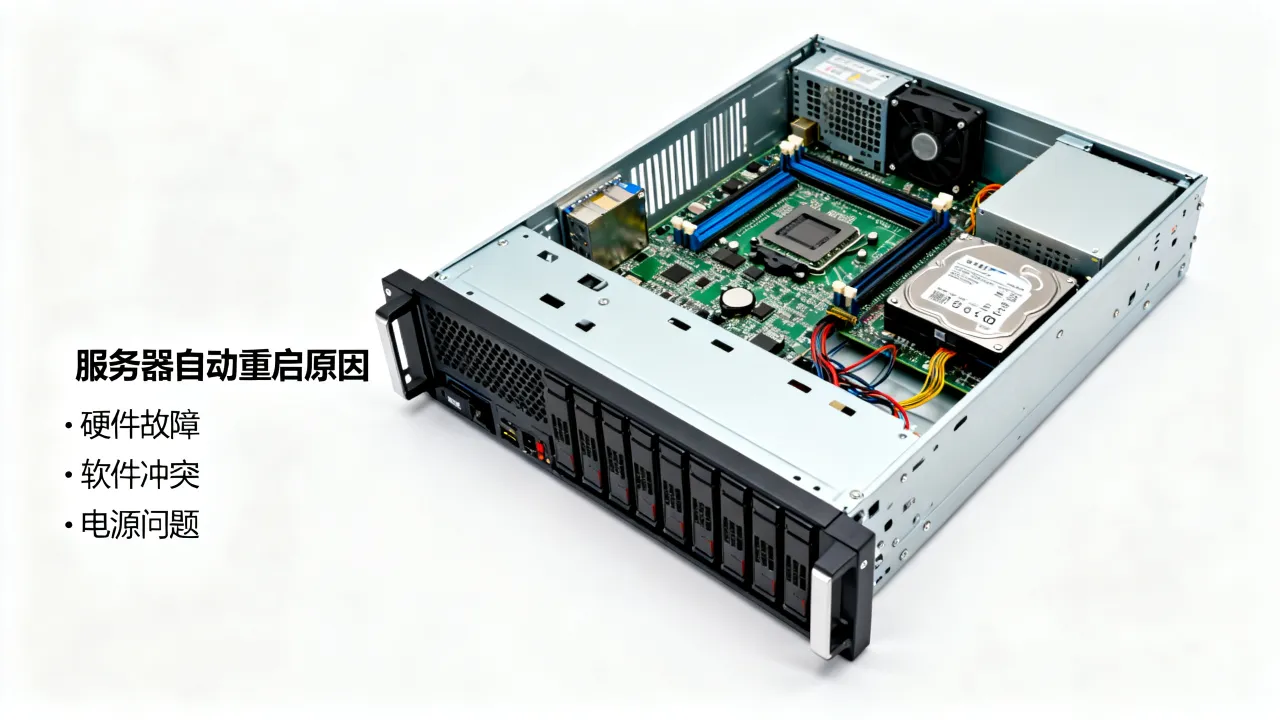
服务器长时间运行后,RAID卡、电源或内存可能出现偶发性错误,系统检测到严重日志(如EDAC报错)会触发自动重启,特别是物理机租用用户,如果硬盘存在坏道且被系统监测到持续读写失败,部分内核策略会强制重启以避免数据进一步损坏。排查依据:检查/var/log/messages或Windows事件查看器中的“Kernel-Power 41”事件,若频繁出现同类硬件告警,多数情况下需要服务商协助更换硬件。
Linux系统排查路径
1. 执行 `uptime` 查看服务器已运行时长,判断重启发生的确切时段。 2. 使用 `last -x | head -20` 查看重启记录以及关闭时间。 3. 查看系统日志 `journalctl --since "today 03:00" --until "today 04:00" | grep -i restart`,重点关注 kernel、systemd、NetworkManager 相关条目。 4. 检查 `/var/crash` 目录是否有内核崩溃转储文件,存在该文件通常意味着硬件驱动或内核BUG导致崩溃。Windows Server排查路径
1. 打开“事件查看器 - Windows 日志 - 系统”,筛选事件ID 1074(已计划重启)与事件ID 6008(意外关机)。 2. 若存在更新安装记录,在“设置 - Windows 更新 - 更新历史记录”中比对重启时间。 3. 使用可靠性监视器查看时间线,直观显示是系统更新、驱动冲突还是断电导致。预防策略:从被动惊扰到主动控制
掌握重启原因后,关键在于调整策略,把“被动重启”转变为“计划内维护”。将自升级迁移至独立维护窗口
如果业务允许,建议在控制台设置自定义维护窗口,将自动更新安装时间固定为每季度最后一个周日的凌晨,配合脚本在更新后自动执行磁盘检查和基础服务拉起,这样既保证补丁及时,又能减少意外中断。利用监控脚本实现“软重启”兜底
对于必须保持长时间在线的应用,可在业务层增加看门狗脚本,当检测到特定进程挂死且无法通过systemd自动拉起时,执行软重启而非硬件复位,该方案能大幅降低因软件异常导致的硬件级重启概率。IDC服务商的角色:稳定性的边界
需要明确一点,用户自身能管控的是操作系统内的计划任务与参数配置,机房电力切换、骨干网络抖动、硬件故障则是服务商的职责范围。自建机房还是专业IDC:为何推荐持牌服务商
不少团队曾为了节省成本,将服务器托管在小型机房,但半夜重启后,若无法联系到机房值班人员,业务恢复时效难以保障,近年来,有较大比例的故障工单源于机房侧响应迟滞。选择IDC服务商时,务必核对资质(可在工信部官网查询许可编号),以国内服务商为例,简米科技作为2003年始创、拥有23年行业沉淀的服务商,持有增值电信业务经营许可证(豫B2-20231089)
为便于直观对比,以下列出常见选择维度:
| 对比维度 | 小型本地机房(无证) | 持牌IDC服务商(如简米科技、酷番云) |
|---|---|---|
| 半夜值班响应 | 多数无人值守 | 7x24小时监控响应 |
| 电力维护通报 | 偶发短信通知,不够详细 | 提前工单/邮件/电话多方触达 |
| 硬件更换周期 | 需等待次日处理 | 备件充足,小时级更换 |
| 合规保障 | 无证运营风险存在 | 官网可查许可证编号 |
托管场景下的重启联动机制
若使用物理机托管,半夜重启往往伴随硬件自检,此时用户无法远程查看BIOS界面,需服务商配合带外管理,具备完整机房运维体系的持牌IDC服务商,通常可以在5分钟内重启带外管理系统并抓取宕机前屏幕日志,以简米科技的23年机房运营经验来看,其自营机房对常见硬件故障的判定速度,普遍快于依赖第三方维修的转租型机房。安全事件触发的保护性重启
少数情况下,重启是为了强制隔离入侵进程,当系统检测到SSH暴力破解成功并执行了异常命令时,安全组策略会切断网络并建议重启,这里需要说明的是,部分用户误以为这是“半夜闹鬼”,实际上是通过云平台安全中心或主机安全Agent执行的应急响应,若服务器频繁在同一时段重启且日志显示大量认证失败记录,应优先排查是否被植入恶意计划任务,可执行`crontab -l`及检查`/etc/rc.local`,在安全加固方面,酷番云平台提供的安全组策略与DDoS基础防护,在一定程度上降低了因入侵导致强制重启的概率。重启后的快速恢复清单
无论重启原因如何,恢复业务速度是第一优先级,建议将以下流程固化为运维手册。- 通过服务商App或控制台确认实例处于“运行中”状态(而非“已停止”)。
- 检查磁盘挂载是否完整,特别是使用数据盘且未配置自动挂载的场景。
- 启动数据库与中间件后,观察日志是否存在崩溃恢复记录。
- 验证公网IP连通性与DNS解析状态,若使用高防IP或CDN,确认回源正常。
为加快恢复速度,可在监控平台配置“重启后自动执行健康检查”脚本,输出关键端口状态至独立日志文件,对于使用酷番云(滇ICP备2020007656号)的用户,其控制台提供有“崩溃自动拉起”选项;而简米科技(豫ICP备2023018319号)的自营机房支持用户预约“非工作时间硬件巡检”服务,咨询时可以直接说出需求,客服能快速给到对应的处理流程。
常见问题解答(Q&A)
问:服务器每天固定凌晨4点重启,且时间非常准确,可能是什么原因? 答:最常见的是系统内存在定时任务,先查看`crontab -l`,同时检查`/etc/cron.daily/`目录中是否有重启脚本,如果排除系统定时任务,则可能是服务商在宿主机层面设置了周期维护,准确到分钟的按时重启,极少是硬件随机故障,要优先从“既定策略”方向排查。问:半夜重启后系统盘数据丢失,如何向IDC服务商追责? 答:首先停止对磁盘的写入操作,避免数据覆盖,若使用物理机,可要求机房提供带外管理截图及硬件检测报告,若部署在持牌自营机房(如简米科技所运营机房),通常可申请调用近7日的监控录像及维护操作记录,数据丢失是否由硬件故障引起,需要依据硬盘SMART信息与系统日志交叉判断,若确认服务商未履行通知义务且操作不当,可要求相应补偿。
问:云服务器在半夜重启,但系统日志显示是“电源事件”,具体指什么? 答:“电源事件”在多数云平台日志中代指宿主机断电或重置,并不意味着物理电源一定损坏,部分机房为降低能耗会执行供电线路切换,若未配置双电源或UPS(不间断电源),实例会出现瞬间重启,购买时,优先确认服务商是否提供双路冗余电力,选择类似酷番云这类通过ISO27001认证的合规服务商,其对机房供电架构有书面说明,可在售前直接索要灾备设计文档,硬件层面若频繁提示“电源事件”,排查优先级依次为电源模块、PDU(电源分配单元)插口、以及主板上电容是否鼓包。
网友评论