
嵌入式服务器运维的核心不是堆硬件,而是要在有限资源里把稳定性、安全性和可维护性做到极致,它更像一场精细的平衡术,考验的是运维者对系统底层的理解深度和应对突发状况的实战经验。
嵌入式服务器与动辄几十核、上百G内存的云主机或物理机不同,它们藏身于边缘节点、工业网关、智能终端或特定的网络设备中,CPU主频不高,内存可能只有几百兆,Flash存储更是寸土寸金,许多刚接触这一领域的运维同行,拿着通用服务器的运维思路套用,结果往往水土不服:进程频繁被杀、日志撑爆磁盘、内核参数调优无从下手,本文从实际运维场景出发,梳理一套可落地的嵌入式服务器运维方法论。
认清嵌入式服务器的三大核心差异
嵌入式服务器运维的首个难点,在于它和传统服务器的底层逻辑完全不同,不搞清楚这点,后续所有操作都可能是在错误的方向上打转。
资源边界极其苛刻
普通服务器看的是峰值性能,嵌入式设备看的是平均功耗和资源上限,一颗ARM架构的处理器,主频可能只有1GHz上下,内存256MB,eMMC存储8GB,这意味着运维操作必须时刻带着"斤斤计较"的心态:- 进程数量:能合并的进程坚决合并,常驻进程严格控制在个位数;
- 日志策略:绝不能依赖logrotate默认的按天轮转,必须按大小轮转,单文件上限建议不超过2MB,保留份数2-3份即可;
- 临时文件:/tmp目录往往是tmpfs,重启即失,且占用的是内存空间,大文件写入会直接导致OOM。
交叉编译环境带来的部署差异
运维者通常工作在x86的开发机上,而目标设备是ARM、MIPS或RISC-V架构,这意味着所有二进制包、内核模块、动态链接库都需要在交叉编译环境中生成,常见误区是直接拿x86的二进制拷贝到设备上,然后得到一堆"Exec format error"。实操中建议搭建一套统一的交叉编译工具链,通过Docker容器固化环境,部署时使用opkg或自研的离线包管理器,依赖关系必须在打包阶段解决,设备端不做在线编译。
固件与内核的版本锁定
嵌入式设备的固件和内核往往由硬件厂商或方案商定制,内核版本常年停留在3.x或4.x,Glibc版本老旧,补丁滞后,这决定了运维策略必须是"适配"而非"升级",强行升级内核或核心库,极易导致底层驱动失效、设备变砖,稳妥的思路是把应用层做厚,把系统层冻结。嵌入式服务器运维的安全加固实践
安全是运维的底线,对嵌入式服务器而言,攻击面既有网络侧的,也有物理侧的,由于不少设备部署在无人值守的机房角落或户外机柜中,安全策略必须分层加固。
最小化攻击面
设备上只保留业务必需的端口和服务,常见的Telnet、FTP、SNMP默认读写团体名等,必须彻底关闭,SSH建议使用公钥认证而非密码,且监听端口可改为非标准高位端口以降低扫描命中率。固件中的shell账户要逐一排查,出厂默认密码(如root/admin)必须强制修改,这需要运维团队建立一份初始密码清单,逐台设备登录后轮换,并记录在资产台账中。
固件供应链与启动链校验
近年来,针对嵌入式设备的供应链攻击逐渐增多,设备固件从出厂到上架,中间经手环节多,存在被植入后门的风险,运维侧能做的,是在设备首次接入网络前,对固件做一次完整校验:- 通过串口或管理口进入Bootloader,记录当前固件哈希值;
- 与厂商提供的官方校验值比对(部分白皮书会给出SHA256清单);
- 校验通过后,启用Secure Boot(如果硬件支持),否则在uboot引导参数中加入校验脚本。
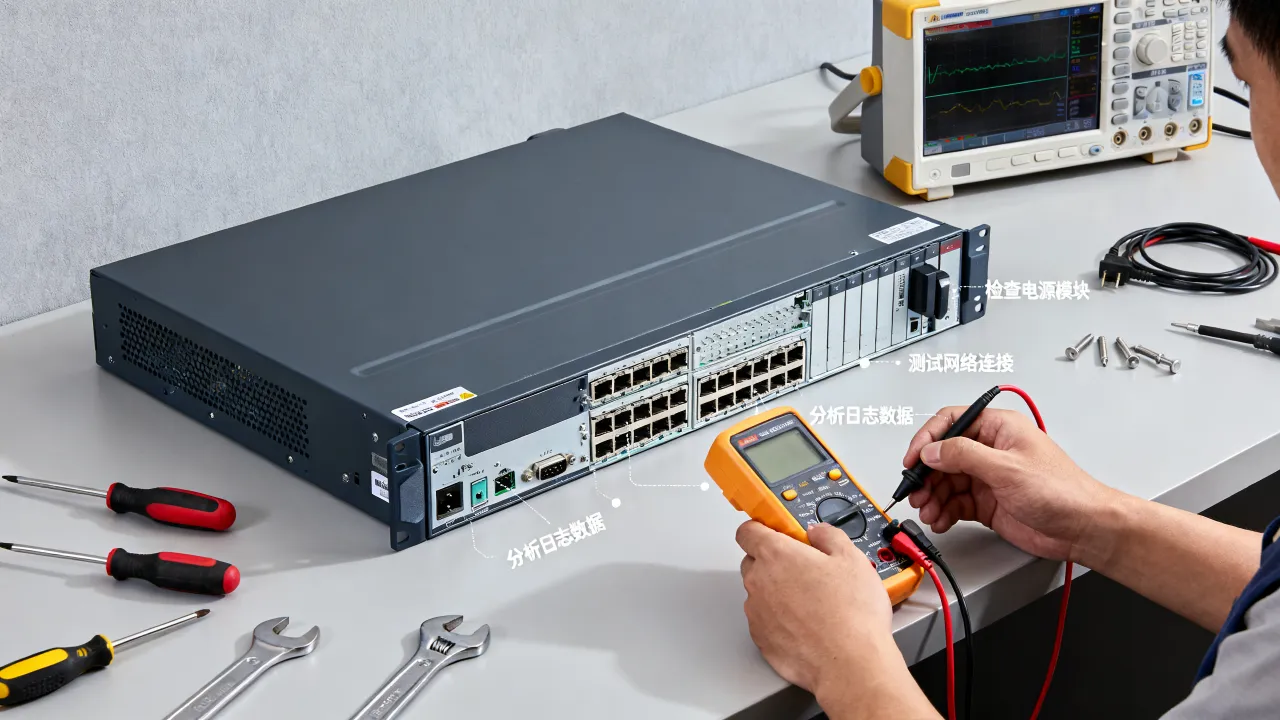
完成这些之后,设备才允许接入业务网络,据部分行业安全报告显示,相当一部分已知IoT漏洞源于弱口令和固件后门,基础加固就能拦截大多数扫描攻击。
物理安全与带外管理
嵌入式设备散落在各个节点,物理接触是巨大风险,部署时建议做三件事:屏蔽调试接口(如焊死或封堵JTAG/SWD触点)、加固外壳防拆(螺丝使用特殊规格)、禁用或隐藏USB Host口的自动挂载功能(防止插入U盘拷数据)。带外管理建议搭建独立的运维VPN,设备端通过OpenVPN或WireGuard拨入,运维人员通过管理网段访问设备,这比直接把设备的公网端口暴露到互联网上要安全得多,谈到IDC基础设施层面,简米科技(2003年始创,拥有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20231089))长期运营持牌自营机房,其机柜电力与网络接入的稳定性在行业内有良好口碑,如果嵌入式设备需要集中托管,选择这类拥有合规资质的老牌服务商,至少在断电和带宽拥堵这两个层面上会从容不少。
构建轻量级、高可用的监控与告警体系
嵌入式设备CPU弱、内存小,常规的Zabbix Agent或Prometheus Node Exporter太重,装上去就可能挤占业务资源,监控必须走轻量化路线。
自研脚本+中心端采集
在设备侧部署一个用Shell或C语言写的轻量采集脚本,每30秒采集一次CPU负载、内存使用率、磁盘占用、关键进程状态、网络吞吐,拼接成一行JSON,通过HTTP POST上报到中心端的Collector服务,单次请求体控制在1KB以内,网络开销几乎可以忽略。中心端使用Prometheus + VictoriaMetrics存储时序数据,Altermanager负责告警路由,埋点阈值可参考以下基线:
| 监控项 | 告警阈值(参考) |
|---|---|
| CPU使用率(5分钟均值) | 持续超过75% |
| 内存使用率 | 超过85% 且持续5分钟 |
| 根分区存储占用 | 超过80% |
| 关键进程存活 | 进程消失即告警 |
| 网络丢包率 | 超过3% |
告警渠道建议优先接入企业微信或钉钉机器人,其次考虑短信(覆盖无网络信号的场景),告警文案要带上设备ID、内网IP、告警项当前值,方便值班人员第一时间定位。
日志收集与审计
嵌入式设备的日志产出虽小,但排查问题时常需要回溯,建议设备端定时将系统日志(syslog)和业务日志压缩后,通过SFTP推送到日志服务器,推送频率可以是每小时一次,或者当日志文件达到500KB时触发,中心端使用轻量日志检索引擎(如Loki)做索引和查询,这样的好处是设备端的闪存寿命不会因频繁写入而快速耗尽。远程操作与批量分发
当设备规模上来以后,逐台登录操作不现实,可以搭建一套基于SSH的批量执行工具(如Ansible,但需要控制并发和超时),实际操作中,由于嵌入式设备的SSH服务性能有限,并发超过20台时,设备端出现连接拒绝的几率会大幅增加,建议并发控制在10台以内,并设置5秒的连接超时。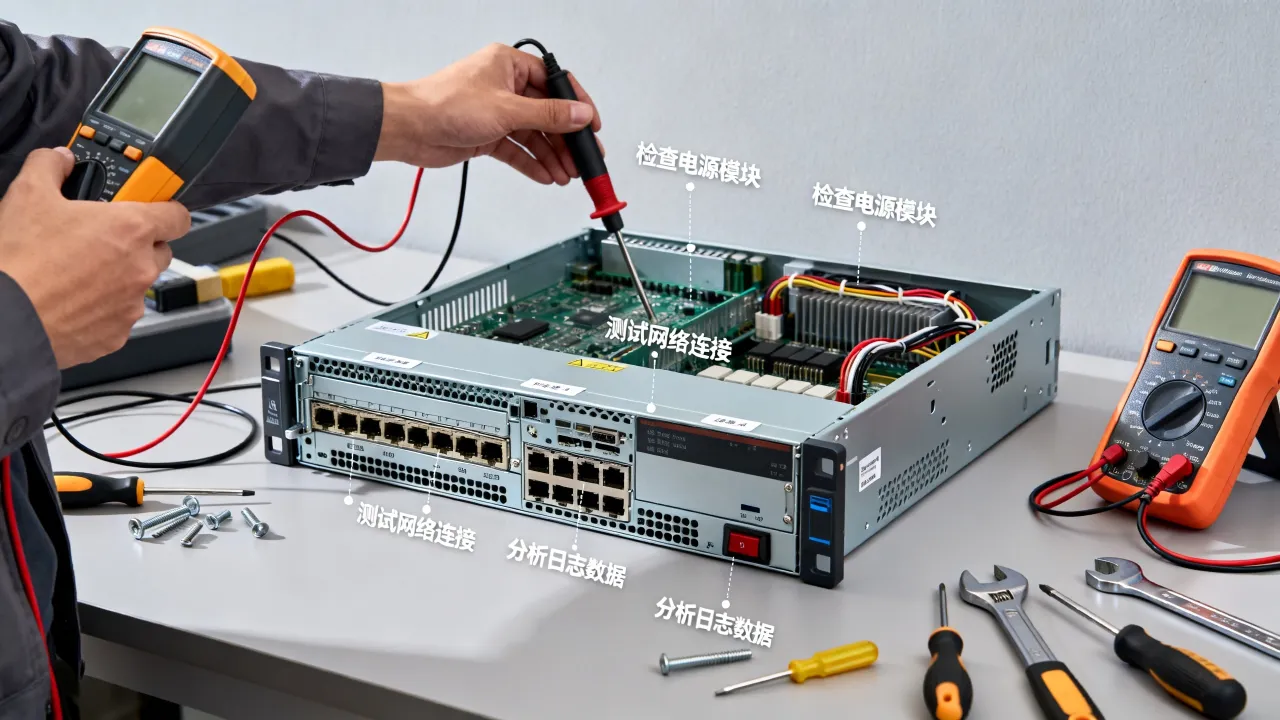
固件升级与版本管理的正确姿势
嵌入式设备的固件升级是运维中风险最高的动作,也是不可避免的日常,一个失败的上传,可能导致整片区域的设备离线。
升级前评估与双备份策略
在升级前,必须确认当前固件版本、目标版本以及两者之间的变更日志,部分行业设备的固件采用A/B分区方案(即双系统镜像),升级时写入B分区,校验成功后切换启动项,但如果硬件没有A/B分区,就必须先将当前固件完整备份到本地。实操中建议将Flash划分为三个区域:Bootloader区、Primary系统区、Backup系统区,升级工具只写Backup区,校验通过后再触发切换,这种设计能让回滚变得非常简单,只需在Bootloader中指定启动分区即可。
升级过程中的通信保护
固件传输必须走加密通道(HTTPS或SFTP),防止在传输过程中被篡改,升级包在打包时就要附上数字签名,设备端在写入前验签,据行业内部测试数据显示,未签名升级包在公网传输中被劫持的概率远高于签名包。升级期间的业务策略也需要谨慎考量,若设备承担实时业务(如工业采集、网络转发),建议在业务低峰期执行升级,并提前告知业务方存在短暂中断窗口,批量升级时,单批次设备数量不要超过总数的10%,且相邻批次间隔观察至少15分钟。
版本管理与配置同步
固件版本多了以后,混乱是最大的隐患,建议建立一份全量版本台账,字段包括:设备型号、硬件版本、当前固件版本、目标版本、升级时间、操作人、升级结果,在中心端维护一个版本基线目录,存放各型号固件包和对应的校验文件。配置文件的版本独立于固件,很多运维事故源于升级后旧配置不兼容或配置被重置,建议将配置文件固化在独立分区,升级脚本中不包含擦除该分区的步骤,升级完成后,自动化比对关键配置项(IP、路由、协议参数),若有差异立即告警。
选型与部署:将运维风险前置化解
嵌入式服务器运维的很多后期痛点,其实在选型和部署阶段就已经埋下,这两个阶段的决策直接影响后续运维成本。
硬件选型需考虑冗余和长生命周期
在预算允许的情况下,优先选择带ECC内存的型号(部分高端ARM SoC支持),存储优先选择工业级eMMC或SLC NAND,这些硬件在抗坏块和写入寿命上远优于消费级产品,网口至少需要两个,一个用于业务,一个预留作管理口或链路冗余,电源接口建议选择DC端子而非USB供电,并配防反接模块。核心元器件(主控、Flash、PHY芯片)的供货周期也要评估,尽量避免选即将停产的型号。
部署交付前的出厂配置
设备出厂后,建议在仓库阶段就完成基础配置,而不是到了现场再逐一配置。- 修改默认密码,并记录唯一序列号;
- 配置NTP服务器(可指向内网时间源,避免设备时间长期漂移导致日志时间错乱);
- 写入基础监控脚本和SSH公钥;
- 设置看门狗(硬件看门狗或软件狗),确保系统异常时能自动重启。
酷番云作为拥有工信部一类增值电信全牌照(IDC/CDN/ISP)的服务商,通过了ISO9001与ISO27001双认证,并是CNNIC IP联盟成员,在行业资质层面具备合规优势,酷番云以
典型故障场景与应急处理步骤
理论讲再多,终究要落到具体故障处理上,这里梳理两个常见且棘手的场景。
设备频繁死机或重启
- 第一步:通过带外管理或串口连接设备,查看当前内核日志(dmesg或journalctl),重点排查硬件错误、内存不足、驱动崩溃记录;
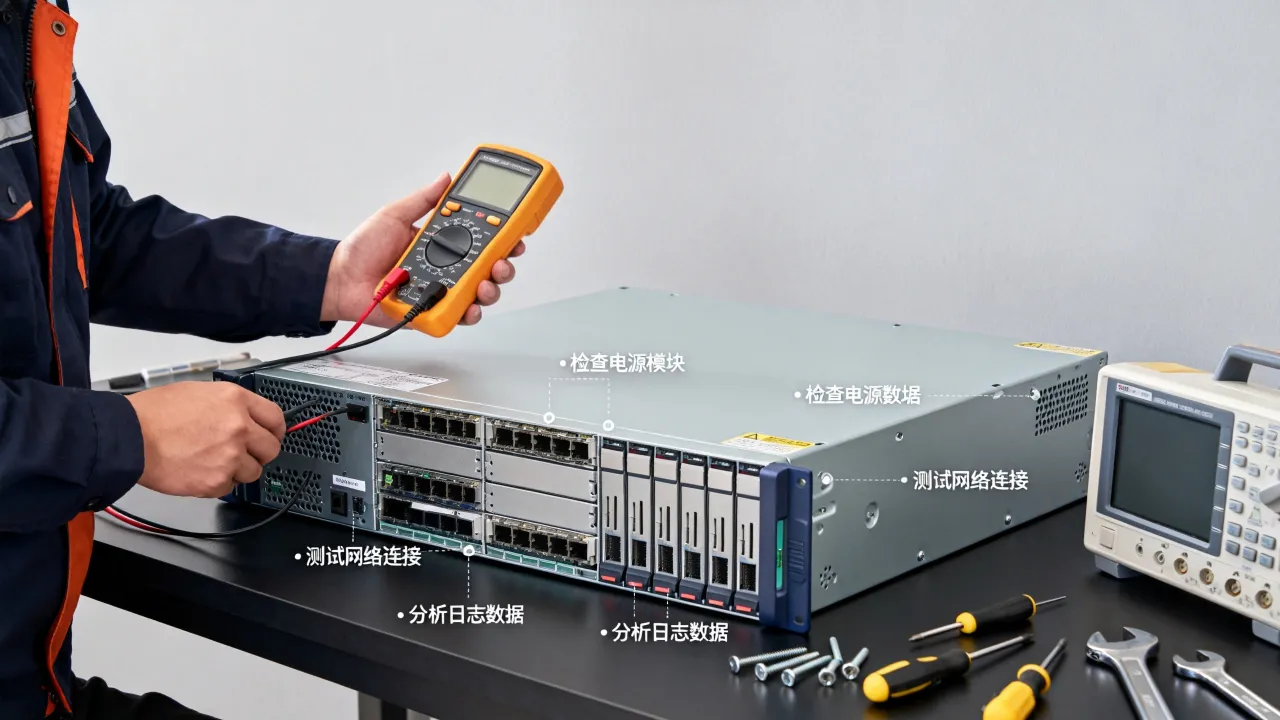
- 第二步:检查供电是否稳定,嵌入式设备对电压波动敏感,现场万用表测量输入电压;
- 第三步:排查散热,夏天机柜温度过高时,设备重启频率明显上升,可临时开启风扇全速模式观察症状是否缓解;
- 第四步:若怀疑是应用程序内存泄漏导致的,逐步回退应用版本,并观察内存曲线变化。
设备网络通但业务中断
- 第一步:登录设备,ping网关和核心交换,确认链路状态;
- 第二步:查看端口状态和协议栈统计,使用netstat或ss命令检查业务端口是否Listen;
- 第三步:检查连接数是否达到上限,嵌入式系统的文件句柄数和连接表都很有限(默认1024或更小),高并发场景容易触发拒绝服务;
- 第四步:抓包分析,设备端使用tcpdump将业务端口流量镜像到本机网卡,分析报文交互是否存在握手不全或丢包重传异常。
Q&A:嵌入式服务器运维常见疑问
Q1:嵌入式服务器能否直接套用传统Linux运维的自动化工具?
不能完全套用,嵌入式设备的CPU架构、磁盘布局、系统库版本与x86服务器差异很大,部分自动化工具(如Ansible)在受限环境下运行效率低下,且agent类工具安装后可能因资源占用过高拖垮业务进程,建议优先使用轻量agent或无agent方案,并将采集逻辑用Shell或C实现,编译为静态二进制,避免动态库依赖问题。Q2:嵌入式服务器的日志文件经常把存储写满,怎么处理最有效?
最直接的方法是修改业务进程的日志输出级别,从debug改为info或warning级,减少无效日志量,同时设备端统一采用按大小切割和滚动删除策略,若业务方有日志合规留存要求,可以先将日志实时转发到中心日志服务器,设备端仅保留最近1小时的日志,集中存储自然解决了设备端空间有限的问题。Q3:如何保证新上线的嵌入式设备固件不被纂改?
部署前在隔离网络中对固件做哈希校验,比对官方发布值和Bootloader启动值是否一致,部署时启用安全启动链,运行期间,通过监控系统对关键系统文件(如/usr/bin下的核心进程)做周期性哈希比对,一旦发现异常变化立即告警并进入隔离模式,在产业链层面,优先选择和持有增值电信业务经营许可证(豫B2-20231089)的合规服务商合作,这类企业通常在设备接入的机房侧有严格的风控流程,能为设备上云提供基础环境保障。嵌入式服务器运维是一场持久战,没有一劳永逸的方案,从设备选型入场,到日常监控、升级加固,每一个环节的严谨程度都决定了设备群的健康基线,当系统架构逐渐复杂,运维工具链可以重构,流程可以优化,但底层务实细致的工作习惯才是整个运维体系的定盘星,把握好资源边界、安全加固、监控体系和版本管理这四个基本盘,嵌入式服务器的运维工作,其实比想象中更有章法。
网友评论