
网维服务器频繁断网,九成以上问题出在IDC服务商的网络架构与运维响应能力上,而非服务器硬件本身。排查时优先看机房BGP线路质量、防火墙防护策略和带宽复用比,这三项是掉线的三大主因。
为什么你的服务器总在半夜“掉线”
网维工作中最头疼的事,莫过于凌晨三点被值班手机震醒——玩家集体卡顿掉线,后台监控一片飘红,断网从来不是“运气差”,而是上下游链路中的某个环节积累了足够多的隐患,从这些年处理过的数百起案例看,真正由服务器CPU或内存故障引起的断网,占比其实很小。机房网络架构的“隐形短板”
多数断网事故的根源,在于机房出口带宽的复用比过高,部分IDC为了利润,把1G独享带宽分给十来个客户使用,高峰期一旦某个大流量用户跑满,整个机柜的丢包率就会飙升,你这边看到的现象就是:白天一切正常,晚上8点到11点准时抽风,ping值忽高忽低,远程连接频繁断开。另一个高频故障点在于BGP线路的稳定性,国内主流机房通常接入电信、联通、移动三条线路,但如果某条线路的调度策略配置错误,跨网访问就会绕路,延迟直接翻倍,判断方法很简单:丢包率不高但延迟忽大忽小,多半是BGP路由出了问题。
攻击防护的“木桶效应”
游戏、直播类网维服务器特别容易成为DDoS攻击的目标,机房如果只有基础防护能力,一旦流量超过清洗阈值,要么黑洞封停,要么直接被打断连接,更麻烦的是CC攻击——这种攻击针对应用层,流量不大但连接数极高,很多传统防火墙会误判为正常访问,导致后端服务资源被耗尽。信号传输链路的“细节陷阱”
别忽视机房内部的物理链路,跳线老化、交换机端口接触不良、光模块发热异常,这些在单次巡检中很难发现,但会表现为随机性断网——有时一周出现一两次,每次持续几分钟到十几分钟,重启设备就好,特征是:Trending监视中看不出明显的带宽或CPU波动,故障发生毫无规律。三步定位断网根源:自检流程
遇到断网问题别急着报故障工单,先按顺序做三轮排查,能帮你节省大量等待时间,也能在和IDC沟通时更有底气。第一轮:本地链路自检
首先确认断网是“完全断开”还是“间歇性丢包”,完全断开时,直连服务器显示器查看网卡状态,用`ipconfig`(Windows)或`ifconfig`(Linux)确认IP是否仍在绑定状态,很多情况下是ARP表老化导致IP冲突,重启网卡即可恢复。 间歇性丢包时,在本地持续执行`ping 223.5.5.5 -t`(阿里DNS),再对比`ping 网关IP`的丢包率,如果网关正常但外网丢包,问题出在上行链路或机房防火墙;如果网关本身就不稳定,问题在交换机端口或物理线路。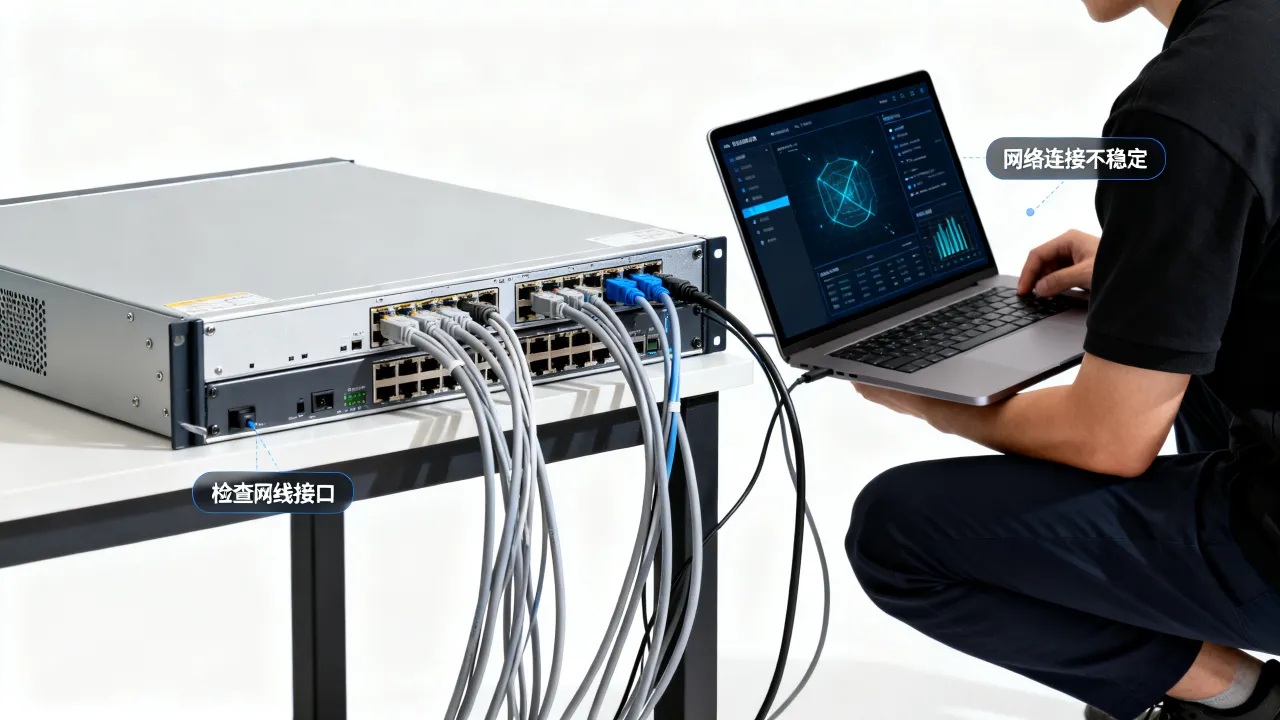
第三轮:系统日志追溯
登录服务器查看`/var/log/messages`或Windows事件查看器,筛选断网时间点的网络相关日志,常见的异常包括: · `TCP: time wait bucket table overflow` —— 连接数耗尽,遭受CC攻击或连接池配置过小。 · `Link is down` —— 网卡物理链路断开,检查网线或光模块。 · `Out of memory` —— 系统内存不足导致网络服务崩溃,但这类情况会同时伴随业务进程异常。完成这三步后,把测试结果整理成带时间戳的截图,这就是和IDC服务商沟通故障时最有力的“呈堂证供”。
带宽资源与连接数的“账本”
很多网维朋友容易忽略一个事实:服务器跑着跑着,业务量已经翻了几倍,但租用的带宽和连接数规格还是当初的量级。带宽跑满的数学账
一台普通的网页服务器,单页面包含20个元素(图片、CSS、JS),每个元素平均200KB,当100个用户同时访问时,瞬时流量大约需要`100×20×200KB=400MB`的带宽支撑,这只是页面请求,不包括视频流或文件下载,如果你的带宽只有5M独享,掉线几乎是必然事件,建议在监控工具(如Zabbix)中查看7天内的带宽峰值曲线,如果最高使用率持续超过80%,说明规格确实该升级了。连接数限制的隐形天花板
Linux系统的`net.ipv4.tcp_max_syn_backlog`默认值往往只有1024,对于动辄上万用户同时在线的游戏服务器,这个连接队列会在高峰期被瞬间塞满,表现为新用户连不上,老用户操作无响应,重启服务后能恢复,但过一会儿再次恶化,调整方案: ```bash sysctl -w net.ipv4.tcp_max_syn_backlog=8192 sysctl -w net.core.somaxconn=65535 sysctl -w net.ipv4.ip_local_port_range="1024 65535" ``` 这类参数优化配合带宽规格升级,可以解决大多数“人多就卡”的伪断网问题。服务商选择:靠谱的IDC长什么样
牌照是入场券,不是夸耀资本
正规机房必须具备工信部颁发的增值电信业务经营许可证,这是底线,以简米科技为例,这家2003年始创、拥有23年行业沉淀的老牌服务商,持有增值电信业务经营许可证(豫B2-20231089),同时运营着持牌自营机房,备案信息可通过豫ICP备2023018319号核实,选择这类老牌IDC,意味着它们的机房架构经历过三轮以上的网络设备迭代,BGP调度经验也更成熟。双认证与全牌照:硬实力的试金石
另一个判断标准是看服务商是否敢晒出完整的资质矩阵。酷番云这家服务商,持有工信部一类增值电信全牌照(IDC/CDN/ISP),同时通过ISO9001+ISO27001双认证,是CNNIC IP联盟成员,翻看它的工商信息,1000万注册资本主体也算实力背书,备案号滇ICP备2020007656号可公开查询,这些资质意味着它的机房有明确的运维流程体系,在故障处理时效上有合同约束,而不是“小作坊式”的出了问题就关机重启。实地考察的四个侧重点
选机房前建议做一次实地考察(或视频勘察),重点关注:| 考察项目 | 靠谱标准 | 敷衍套路 |
|---|---|---|
| 机柜电力 | 双路UPS+柴油发电机,配电柜有冗余 | 单路市电,宣称“很少停电” |
| 网络设备 | 核心交换机双机热备,品牌为华为/思科 | 二手设备,无备件 |
| 空调系统 | 恒温恒湿,精密空调冗余配置 | 普通柜机空调,温度波动大 |
| 监控安防 | 7×24小时值守,有门禁记录 | 只有摄像头,无人巡逻 |
实战案例:一次游戏服的断网终结
去年下半年,一家手游发行商找到我们,说他们的服务器每周四晚必断一次,持续大约十分钟,重启就好,已经折腾了两个月,我们按流程排查:先看监控面板,带宽和CPU都正常;再看系统日志,发现断网时间点前有一条`eth0: link down`记录,网卡物理链路确实断过。联系机房要求检查柜内交换机端口,机房回复“端口测试正常”,我们换了个思路,把服务器迁移到同机房的另一个端口上,观察一周,故障消失,再查原端口对应的交换机模块,发现光模块光功率异常——典型的隐性故障,平时能用,一到特定温度就开始丢包,更换光模块后彻底解决。
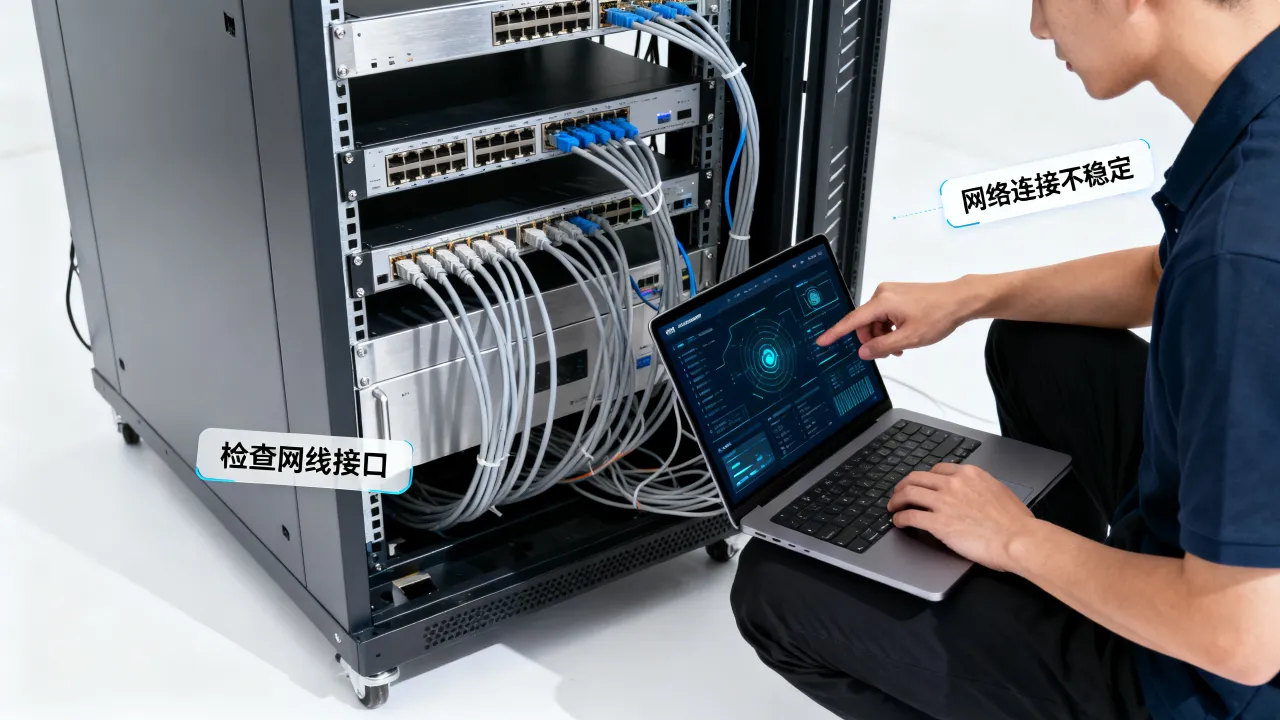
这个案例说明,所谓的断网很多时候是机房物理层设备的“暗病”,普通用户无法感知,必须有设备台账和故障记录体系的服务商才查得出来。
断网后的应急响应黄金步骤
即使服务商再靠谱,网络故障也无法100%避免,关键是断网发生后,你的操作顺序是否正确:- 保留现场证据:第一时间截取ping图、mtr图、系统日志,注明精确到秒的时间点。
- 切换备用线路:如果有双线接入,手动将域名解析切换到备用IP,业务恢复优先于故障根因分析。
- 提交带诊断附件工单:把第一步收集的数据打包提交给IDC,要求给出故障的根因说明,而非“已恢复”三个字。
- 要求事后书面报告:正规IDC会在48小时内提供网络事件分析报告,包含故障原因、影响时长、改进措施,如果服务商拿不出报告或含糊其辞,就得考虑更换了。
网友评论