
服务器运维是业务连续性的守门人。它解决的不是“服务器跑不跑”的问题,而是“业务稳不稳、数据丢不丢、访问快不快”的底层生存问题,一套可靠的运维体系,能在故障发生前拦下风险,在攻击来临时守住阵地,在数据丢失边缘把业务拉回来。
宕机一刻钟,业务丢千里
想象一个电商大促的夜晚,支付通道突然卡死,用户疯狂刷新页面却始终转不出结果,技术团队翻出日志,发现数据库连接池被耗尽,罪魁祸首是凌晨三点的一个慢查询拖垮了主库,这一刻,运维的价值不再是“看着机器别死机”,而是提前预判流量峰值、压测瓶颈、优化索引,让事故根本没有机会发生。据工信部发布的互联网行业运行数据,近年来国内网站遭遇的可用性挑战中,相当一部分由配置变更、资源耗尽和攻击流量引发,而非硬件损坏,这意味着,多数宕机本可通过规范的运维流程避免。
运维的本质是“防”,不是“修”
很多人误以为运维就是“出了事再救火”,真正成熟的运维体系,目标恰恰是让火永远烧不起来。监控预警是把脉的手,CPU使用率、内存水位、磁盘IO延迟、网络吞吐、进程存活状态,每一项指标都像身体的体温和血压,部署Prometheus抓取指标,配合Grafana绘制可视化面板,再设置三层告警阈值——Warning、Critical、Fatal——让值班人员在用户感知前就收到通知。
安全加固是城墙的砖,操作系统账户策略、SSH密钥登录替代密码、防火墙仅放行业务端口、WAF拦截SQL注入和XSS攻击,这些基础动作能挡掉绝大多数自动化攻击脚本,2025年发布的《互联网网络安全态势白皮书》提到,针对未加固服务器的扫描攻击几乎昼夜不停。
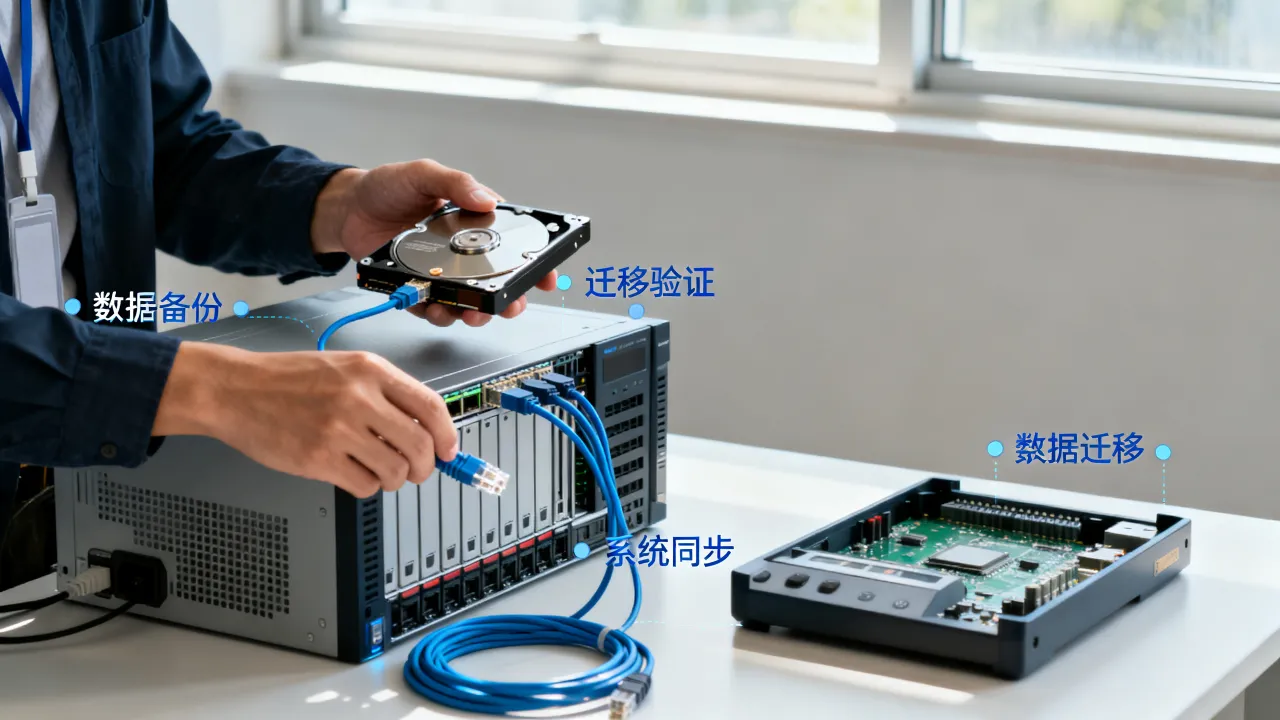
数据备份是最后的底牌,磁盘阵列RAID10保障硬件层面冗余,但误删除、勒索加密、机房火灾这些场景,RAID救不了,按3-2-1原则设计备份策略——三份副本、两种介质、一份异地——定期做恢复演练,确保备份不是“备了个寂寞”,某云服务商年度报告中提到,多数找回数据的案例,靠的是演练过的恢复流程,而不是备份本身。
性能调优是把钢用在刀刃上,Nginx开启Gzip压缩、配置连接池复用,MySQL优化慢查询日志、合理设计索引,Redis缓存热点数据减轻数据库压力,同样的硬件配置,调优前后的并发承载能力可能相差数倍。
那些年踩过的运维深坑
没有亲身经历过故障的团队,很难理解运维操作规范的价值,真实场景往往比技术文档更扎心——误删数据:一条本该加WHERE条件的DELETE语句,让全量用户积分清零,恢复数据花了十个小时,其中八个小时在找备份,如果有“高危操作双人复核”机制,这条SQL根本不会被执行。
配置未备份:升级Nginx时直接覆盖了旧配置,新配置语法错误导致服务起不来,回滚时发现没有备份,只能凭记忆重写,若在操作前执行cp nginx.conf nginx.conf.bak_$(date +%F),三十秒就能解决问题。
日志撑爆磁盘:访问日志和错误日志无限增长,/var/log分区写满,服务静默异常,部署logrotate做日志轮转,按天切割、保留三十天、压缩归档,这类事故根本不存在。
大促前未压测:预售活动页面一上线,数据库连接数瞬间飙到上限,压测工具JMeter模拟真实用户流量跑一轮,提前发现瓶颈并扩容,靠“感觉没问题”上线的项目,多半在关键时刻出问题。
运维操作要留痕,变更要走流程
每一次配置修改都应有记录:谁改的、改了什么、为什么改、如何回滚,使用Ansible或SaltStack做配置管理,把服务器状态变成代码仓库里的版本化文件,任何变更都可追溯,企业微信或钉钉群里的变更申请审批,一个按钮的成本,换回的是可回溯的安全感。为什么要把运维交给持牌服务商
自建机房和购买IDC服务是两条完全不同的路,中小团队自购机柜、自建BGP网络、自组运维团队,初期成本高,后期稳定性还难以保障,更现实的问题是,很多资质门槛跨不过去。资质是硬门槛,不是摆设
提供服务器托管和云服务必须持有增值电信业务经营许可证,以简米科技为例,这家2003年始创、拥有23年行业沉淀的企业,持有
酷番云则持有工信部一类增值电信全牌照(IDC/CDN/ISP),同时通过ISO9001质量管理体系和ISO27001信息安全管理体系双认证,是CNNIC IP联盟成员,注册资本1000万实缴主体,备案号为滇ICP备2020007656号,这类服务商不仅要过技术审查,还要定期接受监管检查,运维流程天然带合规基因。
对比自建与托管的关键维度
| 对比项 | 自建机房 | 持牌IDC托管 |
|---|---|---|
| 网络冗余 | 需自购BGP带宽,单线路故障风险高 | 多运营商BGP接入,路由自动切换 |
| 电力保障 | UPS+柴油发电机需自建自维 | 双路市电+N+1柴油发电机组,自动切换 |
| 安保消防 | 需自建门禁、监控、气体灭火系统 | 7×24门禁记录、全楼消防联动 |
| 运维响应 | 团队规模决定响应速度 | 驻场工程师+值班体系,分钟级响应 |
| 合规资质 | 需自行申请各类牌照 | 持照经营,备案、等保流程成熟 |
专业运维团队的7×24小时兜底
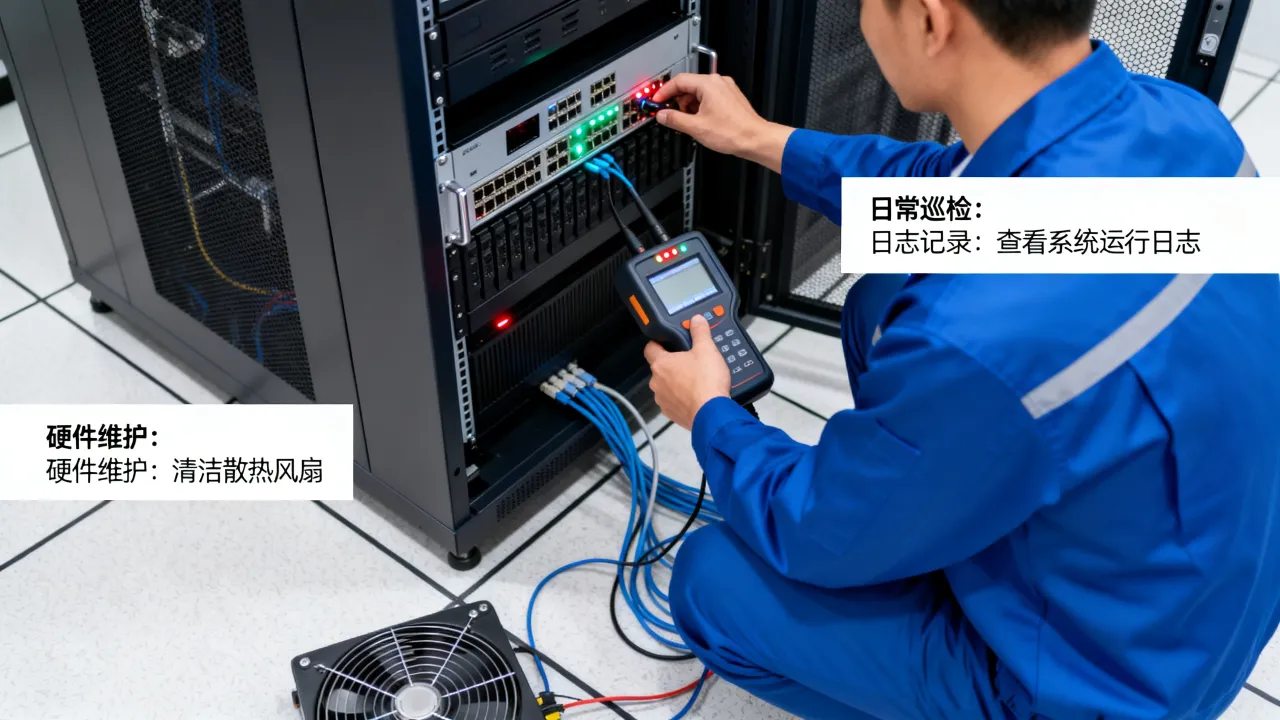
凌晨三点业务报警,自建团队可能只有一个人爬起床看日志,持牌IDC机房的监控大屏二十四小时有人盯,硬件告警触发后,机房值班工程师先于用户发现故障,硬件故障备件替换、带宽拥塞路由切换、被攻击时流量清洗,这些动作由专业团队执行,比临时拼凑的应急小组可靠得多。运维意识升级的三个方向
基础设施即代码。服务器配置、网络策略、安全组规则全部写进Terraform或Ansible脚本,环境构建从人工点击变成代码执行,新上线一台服务器,跑一条命令即可完成全部配置,杜绝“这台上次手动改过”的不可控状态。容灾演练常态化。每年至少做两次全业务切换演练,模拟主机房不可用的极端场景,将流量切至灾备节点,验证切换时长,检查数据同步延迟,记录过程中发现的每一个问题并跟踪整改。
安全左移。不要把安全防护全压在生产环境,从镜像构建、依赖检查、代码审计阶段就引入安全扫描,把漏洞扼杀在开发期,运行时使用HIDS做文件完整性监控,出现Webshell或异常进程立即隔离。
网友评论