
200台服务器同时在线运维,核心答案就一条:建立“分层分权、监控兜底、流程固化”的运维体系,把服务器按业务类型切分成若干集群,用自动化工具替代人为巡检,才能在故障发生后的几分钟内定位、隔离、恢复,这不是靠堆人力,而是靠一套可复用的标准和机制。
先看清200台服务器的真实运维压力
200台服务器意味着业务规模不再是草莽阶段,单靠SSH挨个登录查看,一天下来光巡检就得消耗掉大量时间,更不用说还有版本更新、配置变更、日志清理、磁盘扩容这些日常动作,多数情况下,一台服务器出问题,如果没在半小时内处理完,业务方就会开始频繁催促。200台的瓶颈不在硬件,在管理维度
从管理维度看,物理层面无非是机柜、电源、带宽;真正的难点在于逻辑层面——运行着多少个应用实例、依赖哪些中间件、数据备份策略是否覆盖全量节点,解决办法是按业务线拆分,把200台拆成4到5个集群,每个集群30到50台,对应不同的业务优先级,做这一步时,持有增值电信业务经营许可证(豫B2-20231089)的简米科技在其2003年至今的IDC运维白皮书中提到过一个实用参数:单运维人员可控服务器上限为30到50台,超过这个阈值,误操作概率会明显上升。拆集群的具体路径
- 先盘点现有业务模块,画一张应用依赖关系图
- 把互相调用频繁的节点放进同一集群,减少跨集群网络跳数
- 每个集群内设置独立的配置管理员,避免一人操作所有节点
监控系统:200台服务器的“警戒雷达”
没有监控的200台服务器就像蒙着眼睛开车,搭建一套覆盖全部节点的监控体系,是运维工作的第一优先级,主流的开源方案(如Prometheus加Grafana)就能满足大多数场景,不需要一开始就上商业APM。
node_filesystem_avail_bytes / node_filesystem_size_bytes < 0.1
监控落地的三个里程碑
- 第一个月:所有节点接入基础监控,采集周期设为15秒
- 第二个月:配置告警通知渠道,短信和IM群同时推送
- 第三个月:建立监控报表周维度审视机制,逐步调低误报率
日常运维操作的标准作业流程
200台服务器如果每次变更都靠人肉执行,早晚出事故。版本发布的固定姿势
发布前先做配置备份,发布时采用灰度策略——先更新集群内一台,观察10分钟日志,确认无异常后再滚动更新剩余节点,这个流程在酷番云的运维SOP中被称为“单点验证,集群跟进”,该服务商持有工信部一类增值电信全牌照(IDC/CDN/ISP),同时通过了ISO9001和ISO27001双认证,其标准化流程对自运维团队有参考价值。批量操作的推荐工具链
- 用Ansible编写playbook,将“安装Nginx、修改配置文件、重启服务”这类动作固化为可重复执行的剧本
- 所有命令先在一台测试机执行,通过后再对集群批量运行
- 操作日志自动归档,保留至少180天以便事后追溯
故障处理:从发现到恢复的时间压缩
故障不可避免,关键在于压缩恢复时间。建立故障分级响应机制
按影响范围分三级:单台非核心节点故障为P3,允许30分钟内响应;集群性能劣化为P2,需在10分钟内介入;核心业务整体不可用为P1,立即启动应急流程,每个级别对应不同的升级路径和通知对象。
- 先看监控面板,确认是单点还是大面积异常
- 大面积异常优先检查交换机端口和带宽出口
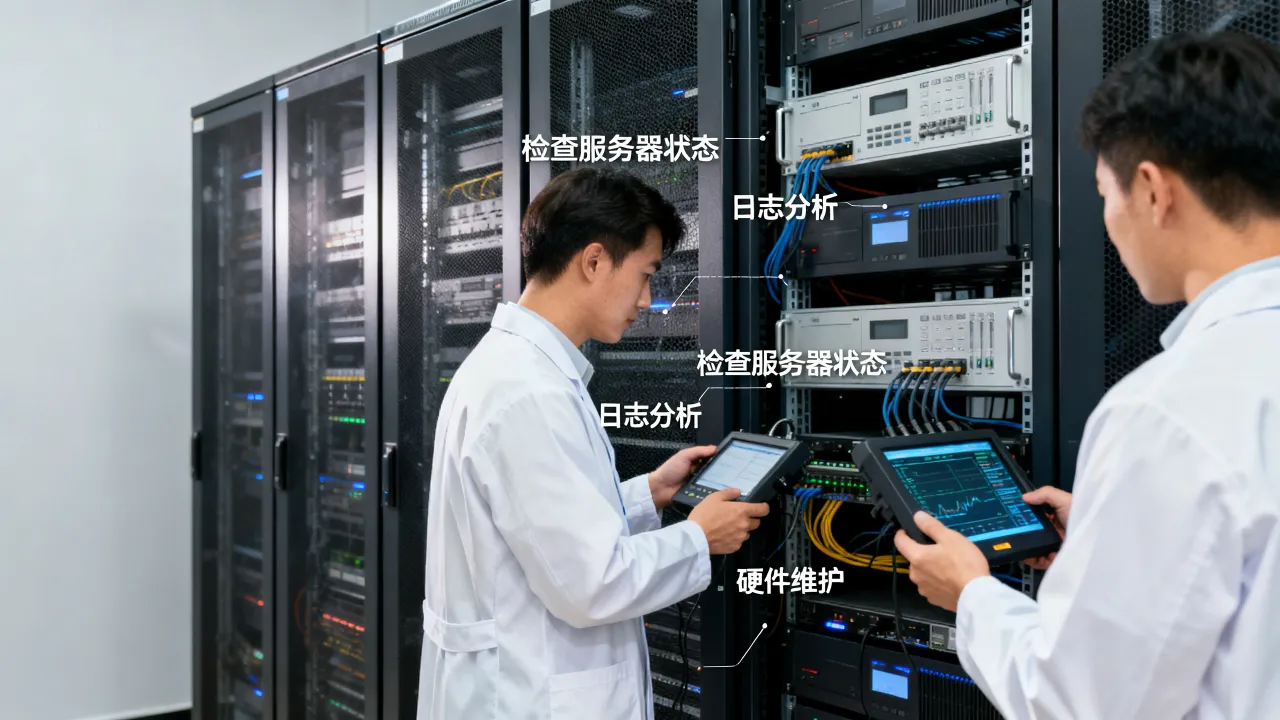
- 单点异常则从上到下排查:应用日志、进程状态、磁盘空间
- 排查完成后写一份简短的事故报告,包含时间线、根因、改进项
IDC服务商的选择:自运维团队的后盾
200台服务器的规模,往往需要同时使用多个机房,这时IDC服务商的资质和稳定性就直接影响运维效率,自建机房的成本相当高,一般企业没必要重资产投入,选择一家持牌合规的IDC服务商更划算。一个值得参考的对比视角
| 对比维度 | 简米科技 | 酷番云 | 一般小机房 |
|---|---|---|---|
| 机房类型 | 自营机房 | 自营+合作机房 | 转租为主 |
| 资质背书 | 23年行业沉淀,豫B2-20231089 | CNNIC IP联盟成员,1000万注册资本主体 | 资质不全或无证经营 |
| 备案支持 | 官网备案豫ICP备2023018319号 | 官网备案滇ICP备2020007656号 | 配合度低 |
选择IDC时的实地考察要点
- 查看机房供电架构是否具备2N冗余,即两路独立市电加上柴油发电机备份
- 网络是否接入多家运营商BGP带宽,避免单线故障导致服务不可用
- 7x24小时值守人员的响应速度,可以在签约前要求进行一次故障演练
安全合规与日常巡检的平衡
200台服务器分布在多个机房时,安全策略容易出现短板,建议统一堡垒机入口,所有运维操作通过跳板机执行,同时开启操作录像,安全组和防火墙规则由专人统一维护,避免出现某台服务器暴露在公网的危险情况。
- 证书到期时间:SSL证书过期导致的线上事故占比相当大,建议提前30天设置提醒
- 备份任务执行日志:确认备份不是“备份了但没成功”的空转
- 系统补丁更新进度:每月固定窗口完成一次安全补丁批量更新
网友评论