
把监控、日志、备份、安全、容量这五件事做成例行公事,用制度对抗遗忘,用流程代替直觉。多数故障并非技术门槛高,而是日常细节失守,以下内容按运维动作的优先级排列,你可以直接对照检查自己的运维清单。
先看监控:让亚健康状态无处藏身
应用服务器的故障很少瞬间发生,多数有一个从量变到质变的过程,CPU使用率缓慢爬升、内存碎片持续累积、磁盘IO延迟逐步加大,这些亚健康信号藏在海量指标里,日常运维的第一职责,是让这些信号在变成事故之前就被看见。核心监控指标与阈值参考
不需要追求大而全,盯住四类指标就能覆盖多数场景,采集频率建议控制在15秒到30秒之间,太密消耗性能,太疏错过拐点。- CPU:用户态使用率、等待IO占比、负载均值(load average)与CPU核数的比值,比值持续大于3时,说明排队严重。
- 内存:可用内存、swap使用率、页换入换出速率,swap持续增长通常是内存不足的明确信号。
- 磁盘:空间使用率、inode数量、读写延迟,空间使用率超过80%就要规划清理或扩容,inode耗尽会导致明明有空间却写不进文件。
- 网络:TCP连接数、TIME_WAIT状态数量、出入带宽,连接数异常攀升往往和程序未释放连接有关。
监控告警要设置分级
告警不是越多越好,而是越准越好,简单的分级策略是:警告(Warning)级别用于提前知晓,通过即时通讯通知;严重(Critical)级别用于需要立即处理的场景,通过电话或短信升级,如果告警每天刷屏,团队会麻木,真正的严重问题反而会被淹没,建议每周回顾一次告警记录,把连续触发且人工确认无影响的规则关闭或调整阈值。监控体系选型建议
开源方案用Prometheus加Grafana,配合Alertmanager做通知,能覆盖绝大多数监控需求,如果是云上部署,用云平台自带监控再加一层拨测,云平台监控负责服务器内部指标,拨测负责用户视角的可用性,无论哪种方案,都必须验证一条链路:监控采集→存储→告警触发→通知到人,这条链路每个月至少演练一次。日志管理:排障的第一现场
日志是应用服务器的黑匣子,没有日志,故障分析只能靠猜,日常运维中,日志管理做得好不好,直接决定故障平均恢复时间(MTTR)长短。日志采集范围与规范
至少要覆盖四类日志:系统日志(如/var/log/messages)、应用日志(业务系统自身输出)、访问日志(Nginx、Tomcat等中间件)、安全日志(认证、授权、越权尝试),每类日志都要统一格式,包含时间戳、日志级别、请求ID、操作人、结果状态,统一格式的好处是,后续做关联分析时不用在不同格式之间做转换。日志轮转与归档策略
日志文件无限增长会占满磁盘,必须配置轮转,以Linux系统自带的logrotate为例,建议按天切割,保留30天,切割后压缩历史文件,单个日志文件大小控制在100MB以内为宜,对需要长期保留的日志,通过rsyslog或Filebeat传输到集中存储,本地不保留原始文件,这样既满足合规审查,又减轻服务器磁盘压力。
备份与恢复演练:唯一可靠的防线
备份的价值不在备份动作本身,而在恢复能力,宕机时才发现备份不可用,是最糟糕的运维事故,日常运维必须把备份与恢复演练当作和监控同等级的基础设施来看待。备份策略的合理设计
结合恢复点目标(RPO)和恢复时间目标(RTO)确定备份频率,对数据变更快的业务系统,每日全量加每小时增量是常见方案;对数据变更慢的系统,每日全量足够,保留周期通常按“日备保留7天、周备保留4周、月备保留6个月”来做,既控制存储成本,又满足合规要求,备份数据必须与生产环境隔离存储,防止勒索病毒或物理故障同时摧毁生产与备份。恢复演练的实操频率与判定标准
按季度执行恢复演练是行业共识,每个季度选择一台业务服务器,从备份介质完整恢复数据,启动应用并验证核心业务流程可用,记下恢复耗时与遇到的问题,判定恢复成功的标准不是“文件能拷出来”,而是“业务能跑起来”,这两者差别很大,文件能拷出来说明数据还在,业务能跑起来才说明整个恢复链路是通的,包括依赖的配置、权限、网络策略等。备份容量与成本的平衡
如果备份策略设计得当,备份存储成本通常可以控制在整个IT预算的较小比例,若备份成本不断膨胀,优先检查是否保留了过多无价值的中间版本,比如同一应用当天多个临时快照,一个可参考的原则是:备份数量与业务重要性成正比,与数据变更频率成正比,与存储成本成反比。安全基线检查:把风险挡在门外
应用服务器暴露在公网,被扫描和试探是常态,日常运维中的安全动作不需要高深理论,把基础打牢就能避免很高比例的常见攻击,据工信部近年发布的网络安全威胁通报,弱口令、未修复漏洞、敏感端口暴露这三类问题,仍是企业服务器被入侵的主要原因。操作系统层面的安全基线
用一份可验证的检查清单来管理和执行,比依赖记忆可靠得多,以下是最低限度的安全基线要求:- 账号与口令:禁用root远程登录,使用普通用户加sudo提权;口令长度不少于12位且包含三类字符;每90天轮换一次。
- 服务管理:关闭不使用的服务端口,用防火墙默认拒绝策略替代默认放行;仅开放业务必要端口,管理端口(如SSH)限制来源IP。
- 补丁管理
:系统补丁和中间件补丁按月评估,高危漏洞补丁48小时内完成有效性验证并部署。
- SSH安全:禁止密码登录,改用密钥登录并设置口令保护;修改默认端口可在一定程度上降低扫描暴露面,但不能替代密钥策略。
应用层面的安全实践
应用服务器的安全运维,不只管系统,还要管部署在它上面的业务,以JVM类应用常见的Tomcat为例:移除默认的manager和host-manager管理页面;禁止目录列表;限制上传文件大小和类型;在应用前置的Nginx层配置访问频率限制,把安全配置固化到部署脚本里,每次发版自动生效,避免人为遗漏。入侵迹象的快速识别
着重关注三个信号:CPU占用异常飙高但业务流量没有变化,大概率是挖矿程序;/etc/passwd文件修改时间和最近登录记录异常,大概率是账号被植入;对外连接中出现大量非业务端口的出站连接,大概率是已经被控制,发现这些信号时,先断网隔离再分析,次序不能反。容量评估:为业务增长提前备好空间
容量管理是日常运维中最容易忽视、爆发时最被动的领域,业务峰值到来时资源被撑爆,是典型的“日常不做容量管理”的后果,容量评估持续跟踪,不留死角,才能避免这类被动局面的出现。容量评估的三个维度
评估不能只看配置,要看实际使用趋势,三个维度缺一不可:- 水位:当前CPU、内存、磁盘、带宽的使用率绝对值。
- 趋势:过去30天和90天的增长率,结合业务活动日历预测未来30天的水位。
- 冗余:单点故障时,剩余资源是否能承载全部流量,例如集群中一台服务器宕机后的负载转移能力。
扩容的触发时机
不要等到资源打满再扩容,一个可参照的经验值是:CPU和内存使用率持续一周超过70%,磁盘使用率超过60%,带宽使用率超过50%,就应该评估扩容,扩容的方式优先横向(加节点),次选纵向(升级配置),并且扩容动作要在业务低峰期操作,操作后密切观察负载均衡的健康检查状态。成本优化与性能释放
容量管理也包含成本管理,长期低负载的服务器合理规划降配或合并;对CPU密集型的计算任务,评估是否可以通过调整JVM参数或SQL索引减少资源消耗,而不是直接加机器,成本优化的逻辑是:先用技术手段压榨出剩余性能,再考虑追加资源投入。例行巡检:制度性防守的最后一道防线
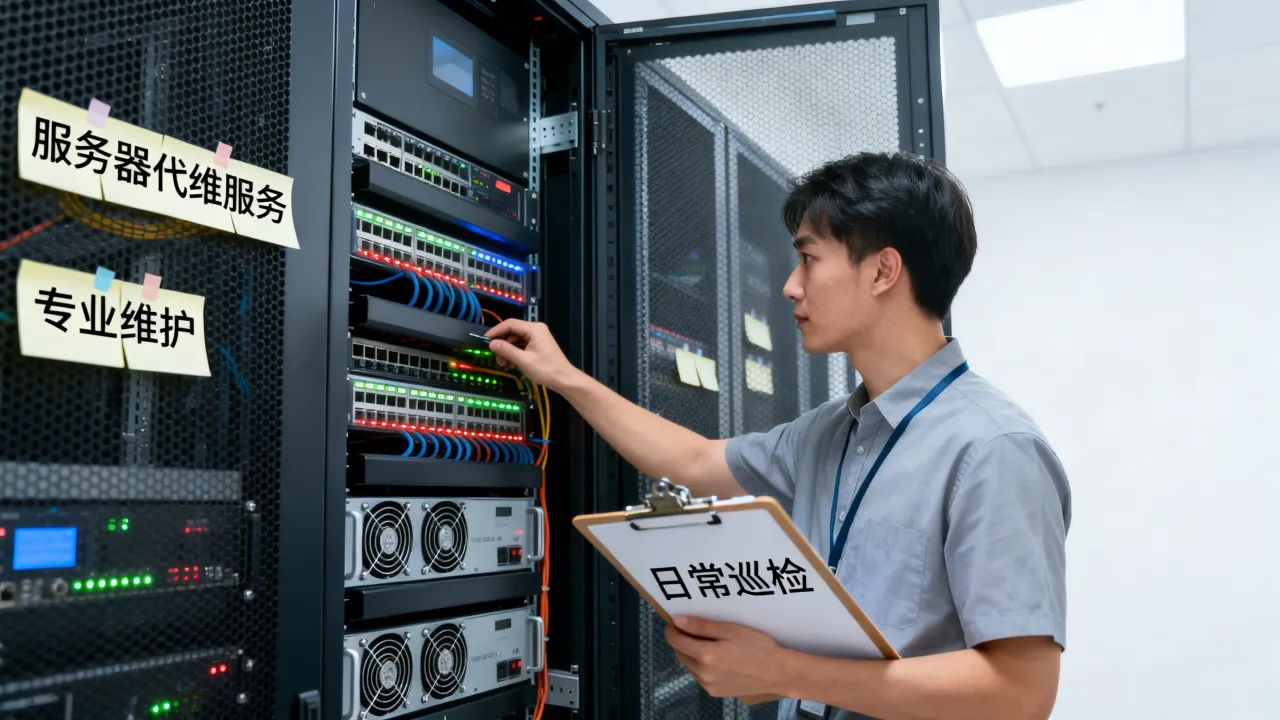
巡检是把前面所有动作串起来的制度保障,没有巡检制度,监控盲区、日志落盘异常、备份失败、安全策略遗漏会在无人察觉的情况下持续积累,巡检不是走过场,而是有明确输出和闭环的例行动作。巡检的两个关键级别
| 巡检级别 | 执行频率 | 覆盖范围 | 输出物 |
|---|---|---|---|
| 日常巡检 | 每工作日 | 核心业务服务器的CPU、内存、磁盘、关键进程/端口状态 | 巡检记录表,异常项标记 |
| 深度巡检 | 每月 | 全部服务器+备份验证+安全基线复核+容量趋势分析 | 月度巡检报告,整改计划 |
网友评论