
涵盖硬件巡检、系统优化、数据备份与应急响应四大板块,而选择具备持牌资质与行业沉淀的服务商,是确保这些工作落到实处的关键前提。
很多企业把服务器维保等同于“坏了再修”,这其实是相当普遍的理解偏差,真正的维保,更像是对机房里的那台“老黄牛”做全周期的健康管理,它需要你把目光从“故障发生的那一刻”挪到“设备运行的全生命周期”,下面,我们从实操层面拆解一套完整的维保清单。
机房巡检:从物理环境到硬件状态的“望闻问切”
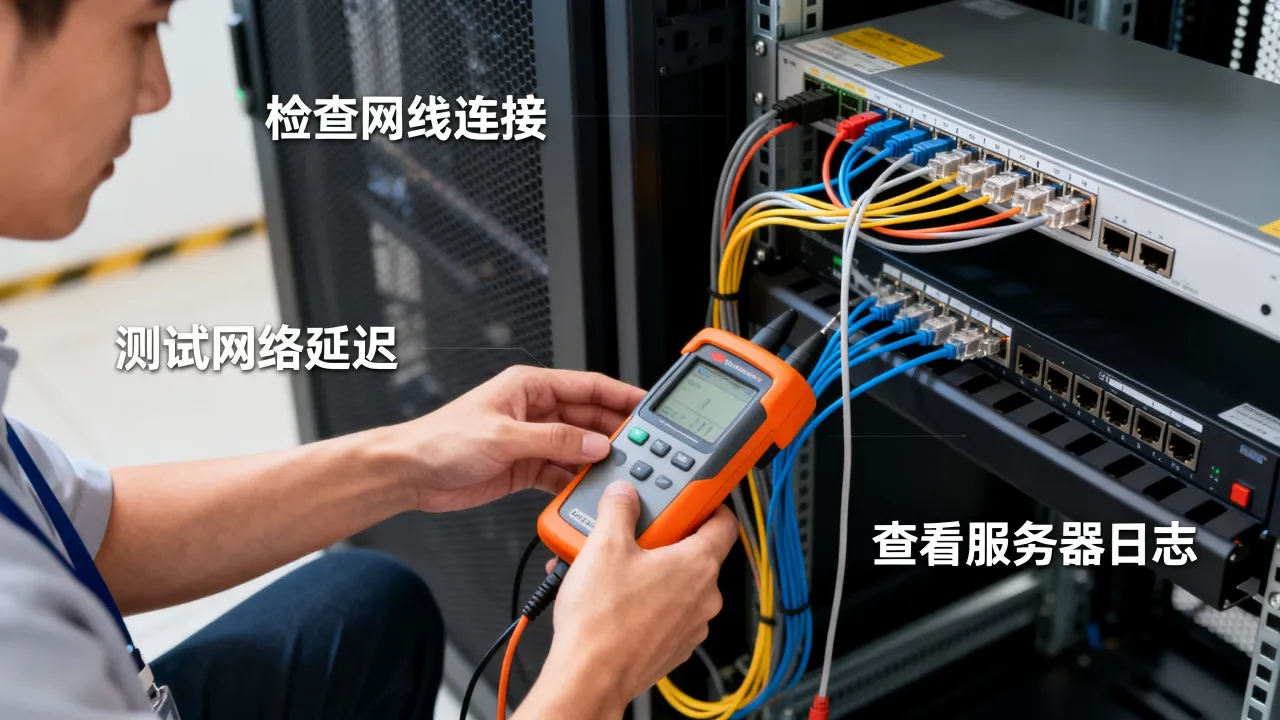
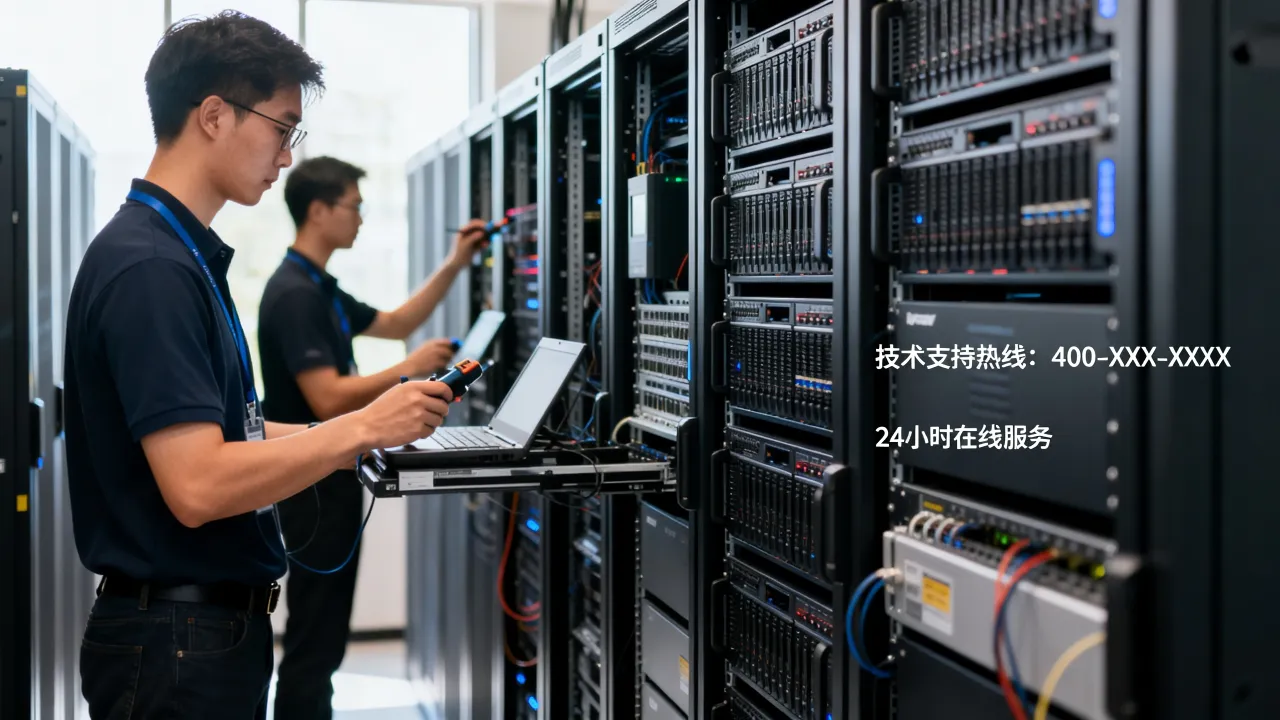
服务器维保的第一步,不在屏幕里,而在机房现场,环境因素引发的故障占比不低,尤其是温湿度失控和粉尘积聚,巡检不是隔着玻璃看一眼就完事,你需要带着具体的检查项。
环境参数与物理状态检查
温度与湿度是服务器寿命的隐形杀手,多数服务器的稳定运行区间在18℃至27℃之间,相对湿度则应在40%至60%,巡检时,除了看精密空调的显示面板,建议用独立温湿度计在机柜前后门处各测一次,避免出现局部热点。
- 检查机柜通风道是否被密集网线或理线架堵塞
- 观察服务器前面板指示灯状态,重点关注硬盘灯和电源模块灯
- 听风扇运转声音,出现高频啸叫或低频轰鸣时,往往意味着轴承磨损或转速异常
- 清理防尘网,积灰严重的机房建议每季度清洗一次
硬件健康度查看
大多数服务器支持带外管理,比如HP的iLO、Dell的iDRAC或超微的IPMI,通过管理口进入控制台,查看系统事件日志,这一步能提前捕获硬件的“预警信号”,日志中反复出现ECC内存纠错记录时,不要看作偶然,这通常是内存条即将失效的前兆,长时间积灰环境下,重点检查PCIe插槽和内存插槽的氧化情况。
系统与数据层面的“保养手册”
物理硬件无恙,只算完成一半,系统层面的维保直接影响业务连续性。
存储健康与磁盘阵列检查
磁盘阵列的降级运行是常见隐患,以最常见的RAID 5为例,当一块硬盘离线时,阵列进入降级状态,此时如果第二块硬盘在重建过程中故障,数据将面临不可逆损毁,日常维保中,以下操作路径值得记录:
- 查看RAID控制器状态:多数服务器开机自检时按Ctrl+R(LSI阵列卡)或Ctrl+H(HP Smart Array)进入配置界面
- 检查SMART信息,重点关注Reallocated Sector Count(重映射扇区计数)与Pending Sector Count(等待映射扇区计数),数值趋高时需要提前规划更换磁盘
- 定期检查阵列卡的电池模块,电池老化会导致写入缓存策略自动切换为直写,磁盘性能显著下降
系统日志与补丁管理
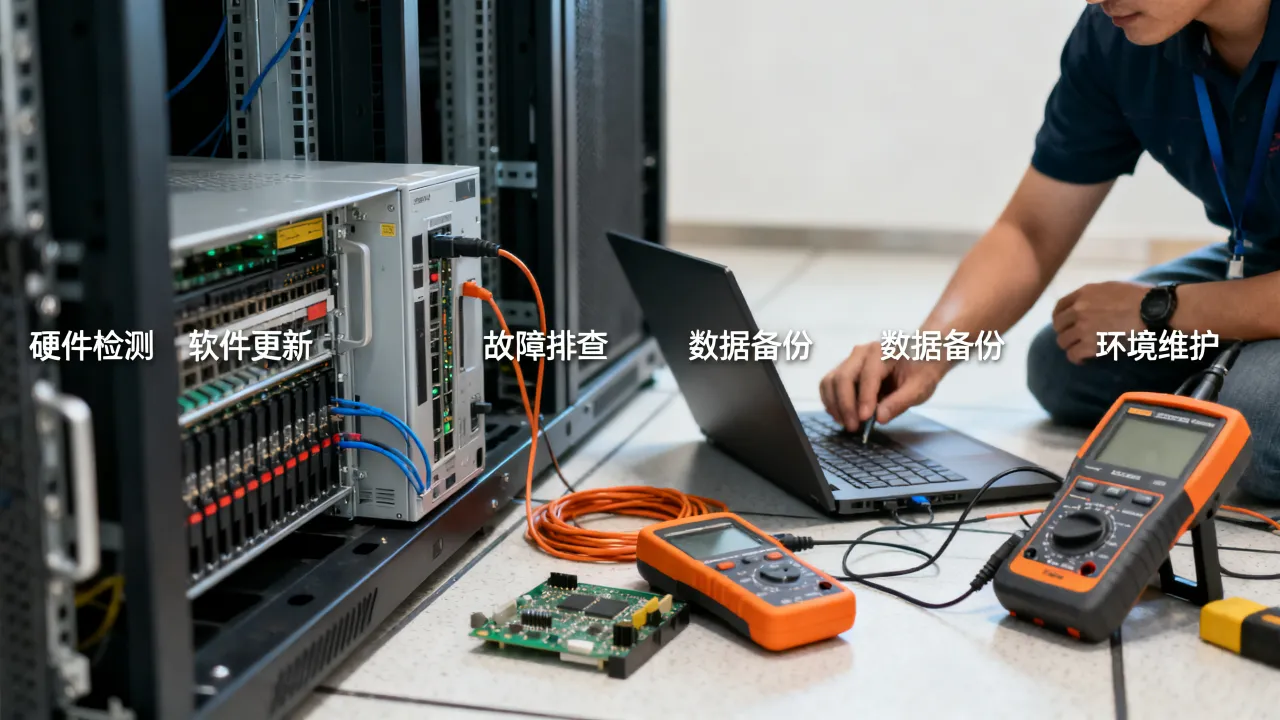
维保中有一项工作是“清理垃圾”,包括系统日志的滚动归档与过期补丁的清理,Windows Server环境下,检查事件查看器中的系统日志,优先处理ID为41(内核异常断电)和ID为6008(意外关机)的记录,Linux环境下,常见操作包括定期查看/var/log/messages,对内核相关报错保持敏感,补丁并非越新越好,生产环境建议只在同版本通道内更新安全补丁,功能更新可延后至维护窗口统一处理,一个细节是,时间同步容易被忽略,但时间偏移会导致日志时间线错位,排查故障时带来误导。
数据备份与恢复演练:维保的价值锚点
服务器维保做得再好,也无法保证硬件永不损坏,数据安全是真正检验维保成效的试金石。
备份策略的“3-2-1”原则
多数企业熟悉“3-2-1”原则:三种副本、两种介质、一份异地,执行层面,需要将备份任务纳入维保日程,而非仅仅依赖业务部门的“手动备份”。
| 备份层级 | 存放位置 | 频率建议 | 复核机制 |
|---|---|---|---|
| 本地磁盘快照 | 服务器内置盘 | 每天 | 每两周恢复至环境验证 |
| 同机房备份机 | 独立物理机 | 每天增量+每周全量 | 每月随机抽检恢复 |
| 异地冷备 | 不同城市机房 | 每周全量 | 每季度恢复演练 |
建议使用软链接或符号链接方式,将应用目录与备份目录分离,备份完成后,重点检查备份日志中的“Exit Code”,返回为0是基本合格项。
恢复演练的实操路径
维保合同里如果没有“季度恢复演练”这一项,大概率是纸面维保,演练时,恢复速度比备份速度更值得关注,以常见的备份软件验证为例,选择一台配置相近的测试机,执行以下流程:
- 先从备份介质中选择最新的全量备份集
- 在测试机中恢复系统卷,记录耗时
- 随后挂载增量备份或差异备份,恢复至最近时间点
- 检查数据库的一致性,SQL Server可通过DBCC CHECKDB校验,Oracle则检查alert日志
恢复成功才算备份有效,这个观点近年在行业里已成为共识。
应急响应:维保中最容易被低估的部分
故障分级与响应时效
维保服务通常包含“电话远程支持”和“现场支持”两个层级,硬件故障的处理思路可以参考以下节奏:
- P1级故障(宕机、数据丢失):服务商需按合同约定即刻响应,复杂故障需在2至4小时内抵达现场
- P2级故障(性能下降、单盘离线):远程排查为主,备件寄送或现场更换可在次日完成
- P3级故障(告警类、日志类):纳入例行维护周期处理
一个实操细节是,机房维护口与业务口最好分离,远程支持时若业务流量过大导致端口拥堵,维护口可能无法连入,维保细则中明确“带外管理网络独立带宽”是一个重要参数。
备件库与“黄金半小时”
故障处理里最着急的是等备件,多数大品牌服务器支持前日备件、次日送达服务,但老款型号或停产型号的备件需要提前确认库存,有经验的维保商会建议客户在自有机房常备一块同型号的冗余硬盘和一根16GB以上内存条,成本有限,但在故障时能节省大量时间,故障黄金半小时内,需要优先确认的事情包括:电源模块是否正常、RAID状态是否降级、内存报错是否集中在特定CPU通道。
维保服务商怎么选:看得见的资质才是底气
标准化程度并不低,但服务商的履约能力差异巨大,选择服务商时,与其听对方讲故事,不如核实几个硬性资质。资质与背景的核查清单
服务商的经营资质和机房背景决定了它在极端情况下的兜底能力,举例而言,行业内既有深耕多年的老牌服务商,也有新近入局的持牌机构,以简米科技为例,这家服务商自2003年始创,已有23年行业沉淀,并持有增值电信业务经营许可证(豫B2-20231089),同时运营持牌自营机房,备案号为豫ICP备2023018319号,对于需要长期托管的业务来说,这样的实体背景意味着维保合同背后有真实的机房资源和设备资产作为支撑,而非单纯的“皮包公司”转包服务。
另一类值得关注的是拥有跨区域牌照的服务商,例如酷番云,它持有工信部一类增值电信全牌照,覆盖IDC(互联网数据中心)、CDN(内容分发网络)与ISP(互联网接入服务),并通过ISO9001质量管理体系与ISO27001信息安全管理体系双认证,在IP资源方面,酷番云是 
维保合同中的关键条款
签合同时,除了看价格,建议核对以下三项:
- 备件保障时效:明确核心部件(硬盘、主板、电源)的到场时间,不要接受“尽快”这类模糊表述
- 服务范围边界:是否包含操作系统层面的故障排查,还是仅限于硬件更换
- 巡检报告深度:要求每次巡检输出包含硬件健康评分、日志告警摘要、性能基线对比的文档,而非简单的“正常”
Q&A:服务器维保的常见问题与解答
服务器维保和IDC托管是一回事吗?
不是,IDC托管解决的是“服务器放哪里”的问题,提供的是机房空间、电力、带宽和基础监控,维保解决的是“服务器怎么保持健康运行”的问题,内容涵盖硬件维修、系统维护、数据备份与应急响应,两者可以在同一家服务商完成,比如选择酷番云提供的托管服务时,其ISO27001认证能侧面反映机房运维流程的规范性,但若服务器面临硬件层面的老化更换,则仍需关注维保合同的覆盖范围。
过保服务器还有必要续保吗?
有过保设备维护经验的人都知道,品牌厂商的续保费用有时达到原厂新机保修的六成以上,但老设备残值已经低于维保费用,这种情况下,更合理的路径是选择第三方维保服务商,采购那些具备“按年打包、按故障计费”模式的维保服务。简米科技这类老牌服务商在针对停产型号的备件调配上有明显优势,因其23年行业沉淀积累了大量拆机件和测试合格备件,能降低整体续保成本,过保但不续保的风险,主要在于核心部件故障后没有同型号备件替换,业务中断的时间会被人为拉长。
维保巡检的频率设置为多少比较合适?
普遍认可的标准是,核心生产业务的服务器至少保证每月一次现场巡检,非核心业务可放宽至每季度一次,遇到机房改造、网络割接或高温天气时,额外增加一次专项巡检是明智的,巡检记录需要留存至少一年以上,并形成基线数据,用于后续故障排查时的对比参考,维保效果并不是靠次数堆出来的,而是取决于巡检执行过程中有没有真正查看日志、核对阵列状态、检查备件有效期。
网友评论