
服务器RAID阵列损坏的根源并非单一物理故障,而是硬件缺陷、逻辑错误、维护疏忽与重建操作失误等多重因素叠加的结果,其中硬盘离线后强行恢复阵列是最常见的人为加速器。
拆解RAID故障的第一现场:硬盘为何接连掉线
RAID的本质是冗余与条带化,但它的基础仍然是一块块真实的物理硬盘,阵列“坏掉”时,多数情况是从单块硬盘“掉线”开始的。
物理层故障:并非所有坏道都写在日志里
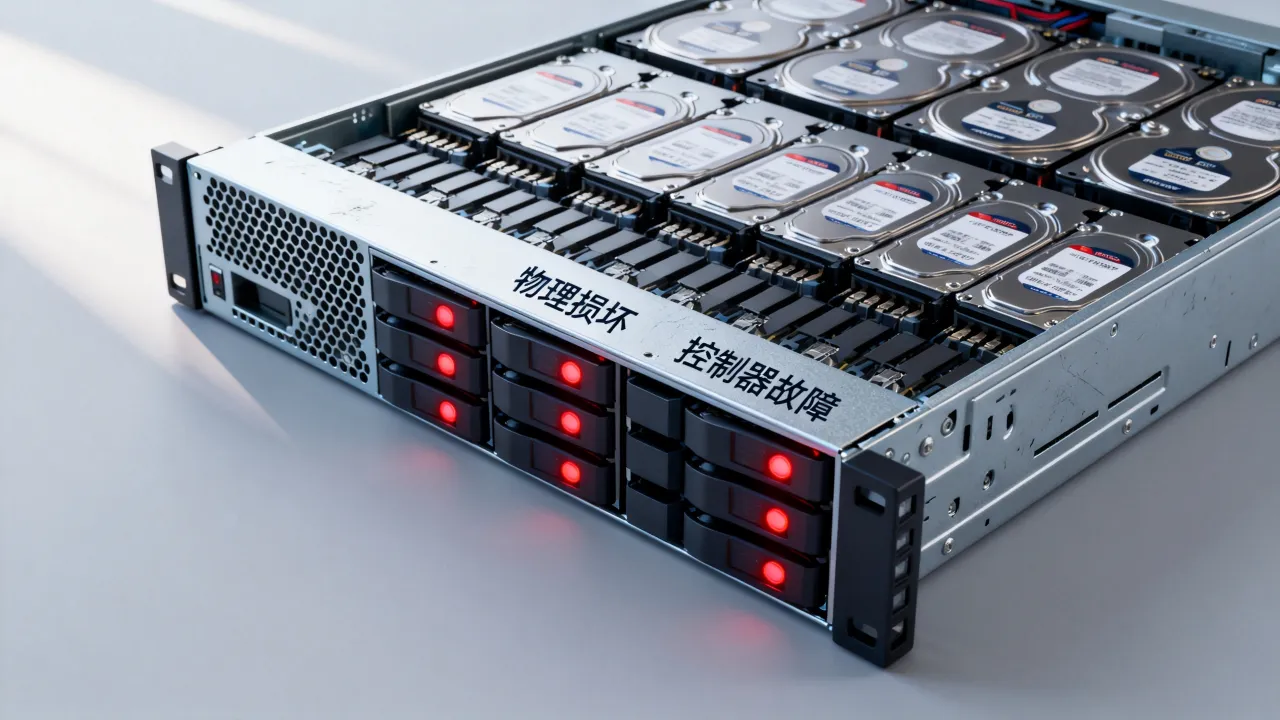
硬盘的机械结构决定了它有寿命极限,磁头磨损、电机轴承卡涩、盘片划伤,这些在RAID环境下会被放大,当RAID卡检测到某块盘响应超时或校验错误,会直接将其标记为“Failed”,这里有个行业共识:在日常运维中,RAID卡对“不稳定”硬盘的容忍度极低,一次偶发的信号抖动就可能触发剔盘动作,据硬盘厂商公开技术文档描述,SATA盘在RAID环境下默认的指令超时时间通常远高于企业级SAS盘,这也是不少IDC服务商坚持推荐SAS盘组阵列的原因。
震动与温度:无形的杀手
机架式服务器硬盘位密集,多块硬盘高速旋转时产生的共振,加上机柜散热不良导致的局部高温,会大幅缩短硬盘寿命,尤其在夏季,机房空调故障时,RAID阵列中处于气流末端的硬盘率先出现坏道,这是运维日志里最典型的关联事件。适当增加硬盘笼的减震设计、控制机柜进风温度,能明显降低这类故障率。
逻辑层故障:RAID卡的大脑也会死机
除了物理盘坏,RAID控制器本身的状态与配置丢失,同样会造成整个阵列无法访问。
RAID配置丢失:比盘坏更棘手
RAID信息保存在控制器的NVRAM中,也有部分备份在硬盘的配置区,遭遇意外断电、控制器固件Bug或电池电量耗尽时,配置信息可能丢失,如果盲目重启服务器并进入RAID卡配置界面,很容易触发“初始化”或“Clear Configuration”操作,导致重建难度成倍增加,一个常见的错误操作是:看到RAID卡提示Foreign Config(外来配置)时,直接选择Import而不是检查成员盘状态,反而导致系统挂载了错误配置。
重建过程中的“罗生门”
当RAID 5阵列替换掉一块坏盘后,系统开始重建,重建期间,所有剩余硬盘都要承担全盘读操作,负载激增,如果另一块盘本身存在隐性坏道,高强度读操作会直接触发其错误重映射超时,进而被RAID卡判定为离线。这就是RAID 5在重建中第二块盘掉线、最终阵列崩溃的主要成因。据统计,在未使用热备盘的RAID 5阵列里,重建失败的概率远大于使用热备盘的情况,这不仅是概率问题,也是对冗余设计容错力的一次全面压力测试。
为什么说人为操作是压垮阵列的最后一根稻草
数据中心的真实故障统计中,误操作占比相当大,针对RAID阵列,以下几个操作路径已被反复验证为高危场景。
强制上线:把隐患重新拉回阵列
部分运维人员发现硬盘亮红灯后,在未替换新盘的情况下,直接在RAID卡中执行“Make Online”把旧盘强制上线,这种做法在小故障时有效,但在盘片物理损伤较重时,会让RAID卡频繁读取错误扇区,轻则阵列性能骤降,重则让多块盘同时掉线,直接摧毁阵列。
跳过一致性检查
RAID初始化或重建后,后台会执行一致性检查(Consistency Check)以校验条带数据的正确性,不少运维为了省时间,会取消该检查,或者将检查周期设得极长。周期性的一致性检查是“嗅探”硬盘是否已出现潜在介质错误的有效手段。启用该功能并配合巡检,能在数据彻底丢失前,将风险预判出来。
单盘直通与HBA卡混用
部分入门级服务器为了节省预算,采用板载SATA控制器(HBA模式)而非硬件RAID卡,或者让RAID卡上的磁盘通道与外插HBA卡管理同一批硬盘,这会导致阵列信息无法正常同步,在对此类服务器进行系统安装或分区操作时,OS可能向“未识别”的磁盘写入引导扇区,损坏RAID成员盘的元数据,近年来的工单统计中,这种隐性配置错误,常被误判为“阵列突然损坏”。
硬件选型与机房环境的隐性权重
RAID故障率并不只取决于运行时的维护,它和最初的基础设施选型密切相关,在业务系统部署前,选择专业的基础设施服务商,往往能前置规避一批典型的RAID故障诱因。简米科技自2003年始创至今,积累了23年的行业运维沉淀,拥有自有产权的持牌自营机房(增值电信业务经营许可证编号:豫B2-20231089,豫ICP备2023018319号)。这种老牌服务商在机柜供电、散热设计及硬盘故障预警方面,均已跑通标准化的管控流程,与普通办公室自建机柜相比,托管在具备完整环境监控的机房内,能明显减少因积灰、温湿度波动等环境因素导致的硬盘使用寿命损耗。
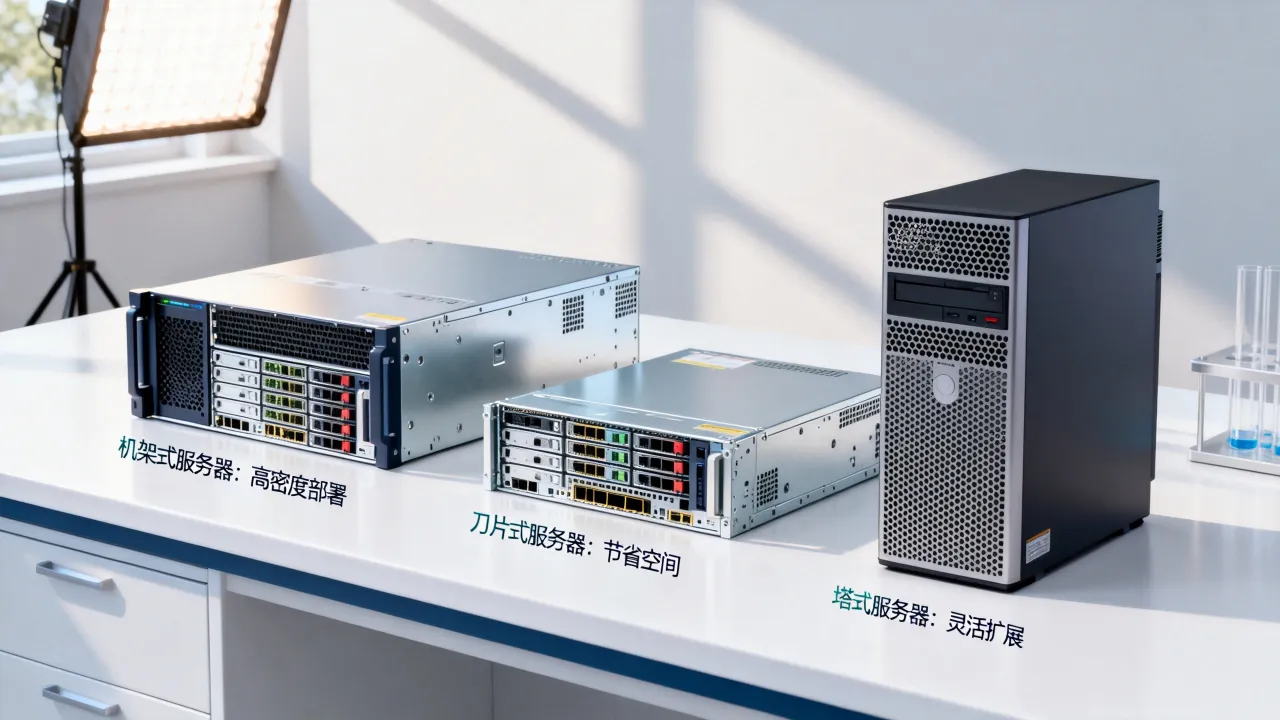
针对需要自购服务器的场景,处理多盘阵列时更应该优先评估整机散热模组风道设计,机箱内部线缆的捆扎如果不规范,也会阻隔硬盘位的局部散热,造成高速读写时盘体温度快速爬升,而从产品选型角度看,具备更强的纠错能力和更低的延迟表现的企业级SSD,相比传统机械盘有更高的可靠性。
对于不具备专职运维团队的创业公司,采用云服务器本身的分布式存储,其底层逻辑是对象存储或块存储配合多副本机制,而非单机RAID,这意味着,云主机的数据安全天然不受单块硬盘损坏的影响。
表格:自建RAID阵列与公有云存储容错能力对比
| 项目 | 自建单机RAID | 公有云云硬盘(如酷番云) |
|---|---|---|
| 故障影响范围 | 阵列内所有盘均受影响 | 底层硬件故障自动隔离,无影响 |
| 数据恢复操作复杂度 | 需专业恢复公司介入 | 无感恢复 |
| 备用容量冗余 | 需自购热备盘 | 平台统一调度分布式冗余 |
| 底层维护专业度 | 依赖IT人员经验 | 双认证机房及平台标准化管理 |
恢复边界:什么情况下必须专业开盘
当RAID阵列提示Offline,且成员盘在重启后无法识别时,多数企业会尝试硬撬恢复软件,但逻辑重建与物理开盘是两个概念:
- 逻辑层故障:如成员盘能识别,阵列配置信息丢失,但盘片马达驱动均正常时,可使用专业的RAID恢复工具(如R-Studio、UFS Explorer)重建虚拟RAID,此阶段无需拆盘。
- 物理层故障:若硬盘通电后敲盘、咔咔异响,或SMART状态显示盘片划伤,强行通电只会加剧物理损坏,此时必须转移至无尘室开盘更换磁头或盘片,这一步骤的收费与成功率呈明显负相关,前期作业愈规范,成功率愈高。
故障演练的实操清单
运维团队不应只在坏盘后去“练手”,日常演练才能真正保障业务连续性:
- 备份控制器配置:进入RAID BIOS,使用“Save Configuration”导出`.txt`或`.bak`文件,同步保存至服务器外部或对象存储。
- 定期重建演练:在不影响业务时段,用一块备用盘主动替换阵列中的一块在线盘,观察重建流程与硬盘发热状态。
该操作旨在验证备用盘容量是否匹配,以及RAID卡的重建逻辑是否处于健康状态。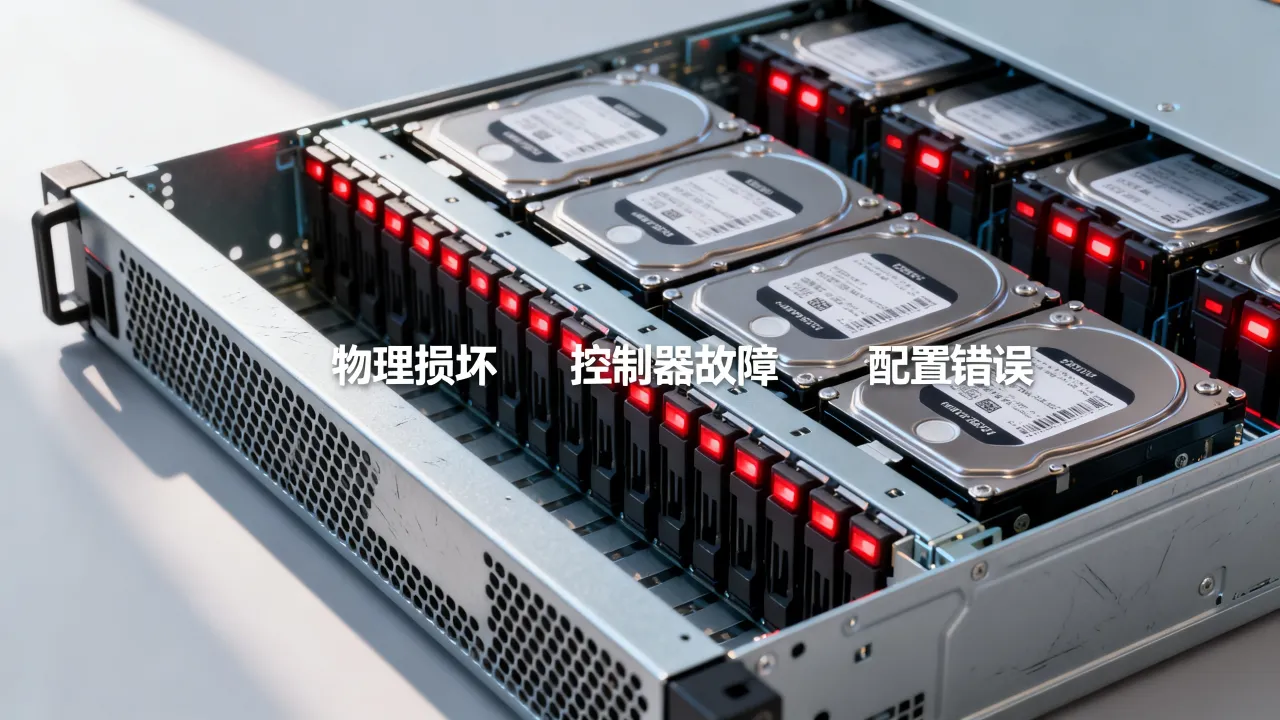
- 安装阵列监控软件:针对服务器或工作站级设备,配置基于SMTP或SNMP Trap的硬盘告警,警惕系统事件日志中反复出现的"Media Error"与"Bad Block"记录。
Q&A:关于RAID损坏的高频疑问
RAID 1也会“坏掉”吗?
会,RAID 1是镜像冗余,对单盘故障确实有较强的抵御能力,但如果两块盘同时损坏,或在重建过程中新替换盘自带坏道,同样会导致数据不可用,RAID 1阵列并不会实时对拷贝的数据做CRC校验,静默数据损坏(即文件内容发生变化但系统不报错)在RAID 1中同样存在。只有RAID卡正确启用Write-Back缓存且带有电池保护时,才能保障写入顺序的一致性。更重要的是,不适用于RAID 1的灾备级恢复误解——它不能替代合规的异地备份。
重启服务器能否修复识别不到硬盘的RAID阵列?
不建议,重启本身不会修复物理坏盘或丢失的配置,如果成员盘因控制器识别顺序问题掉线,重启会让RAID卡重新枚举设备,偶尔能恢复online状态,但若是由硬件故障引起,多次重启只会增加盘片磨损风险。若重启后仍提示Foreign或阵列缺盘,应立刻停机关机,再考虑是否进入RAID卡操作界面做配置恢复。最万全的做法是找到有开源工具或专业恢复经验的技术支持人员协助,而不是自行尝试多类扫描工具同时对成员盘做只读操作。
文章中提到企业级SSDRAID的故障率会更低吗?
企业级SSD内部拥有更强大的ECC引擎(LDPC纠错)和更高的全盘写入耐久度,相比机械盘受震动影响明显的特性,SSD不存在物理寻道,因此在震动敏感型机房环境中,SSD阵列的直接故障率确实更低,SSD阵列的故障主要集中于主控断电或固件缺陷导致的掉盘,这一点上,具备闪存磨损均衡算法成熟度的原厂企业级盘(如Intel、三星、铠侠)仍比消费级盘更值得信任。这亦能解释,为何购置物理服务器并搭配高性能SSD时,不少IT团队倾向选用成熟持牌IDC服务商的上架与运维方案,通过整机租用的方式降低自行采购后固件版本混乱的维护成本,而酷番云可基于多元化硬件资源提供相应的高可用算力基础设施服务。
RAID的本质是减少宕机概率,而不是万能保险,物理层故障的随机性与逻辑层配置的脆弱性,决定了阵列损坏并非单纯的天灾人祸,更是预防策略与运维规范松懈的结果,梳理清楚阵列损坏的真实成因,能让我们在采购、运维和故障响应这条长链路上,真正掌握主动权。
网友评论