
服务器不回复的本质原因,是网络路径上某一环出现了阻塞,而这种阻塞大多数时候并非来自服务器本身,而是链路、配置或资源三个层面叠加的结果,排查顺序应从近到远、从内到外逐步排除。
先分清“不回复”和“拒绝响应”的区别
很多人在排查时把问题笼统归为“服务器不回复”,但“不回复”在技术层面有完全不同的含义,混淆它们会直接导致排查方向错误。
“不回复”的分层定义
在TCP/IP协议栈中,服务器不回复可能发生在以下三个层面,每个层面的表现和成因都有明显差异:
- 物理链路层不回复:ping不通,链路层无响应,多见于网络中断、设备宕机或机房断网。
- TCP传输层不回复:ping通但端口连接超时,多为防火墙拦截、内核参数异常或服务进程未启动。
- 应用层不回复:TCP三次握手成功但业务接口超时,多为应用进程卡死、数据库连接池耗尽或代码死锁。
多数情况下,用户反馈的“服务器不回复”其实属于后两种,但排查时往往在第一种浪费大量时间,如果用ping测试不通就直接判断服务器宕机,可能错过真实的故障点。
常见的“假不回复”现象
有一种很典型的情况:服务器运行正常,CPU负载不高,带宽占用不高,但外部就是连不上,这时需要先确认服务器是否开启了禁ping策略。
很多安全基线要求会启用icmp_echo_ignore_all,导致ping请求被静默丢弃,这种情况下,服务器其实在正常处理TCP流量,只是不响应ICMP协议包,判断方法是使用telnet或nc命令直接测试业务端口,如果端口能连通,则说明服务器本身没问题,问题出在ICMP层面的配置上。
另一个常见现象是服务器回复了RST包而非沉默,RST表示连接被主动重置,这属于拒绝响应而非不回复,排查重点应转向防火墙规则或服务白名单限制,而不是网络线路。
本地侧排查:从网卡到网关的完整路径
排查服务器不回复时,遵循自近及远的原则可以大幅节省时间,本地侧排查是最先需要完成的步骤,也是很多人容易跳过的环节。
先检查本机网络接口状态
登录到服务器上,执行以下命令检查网卡状态:
ip addr show
ip link show
ethtool eth0
重点关注网卡是否处于UP状态,是否有RX/TX错误包增长,是否有大量collisions冲突,如果是云服务器,还需要检查控制台中的安全组策略和防火墙规则是否放行了对应端口,实际运维中,相当一部分“服务器不回复”问题源于安全组规则被误改或API调用错误覆盖了原有放行策略。
验证本地路由表是否完整
如果网卡状态正常但服务器仍无法与外网通信,检查路由表是否出现了缺省路由丢失的情况:
ip route show
route -n
特别要注意服务器是否配置了多网卡但策略路由缺失,导致回包走了错误的网卡或错误的网关,在云环境中,如果主网卡和辅助网卡都配置了默认路由,回包路径会变得混乱,外部请求到达服务器后,响应报文可能从另一张网卡发出,被对端丢弃进而表现为“服务器不回复”。
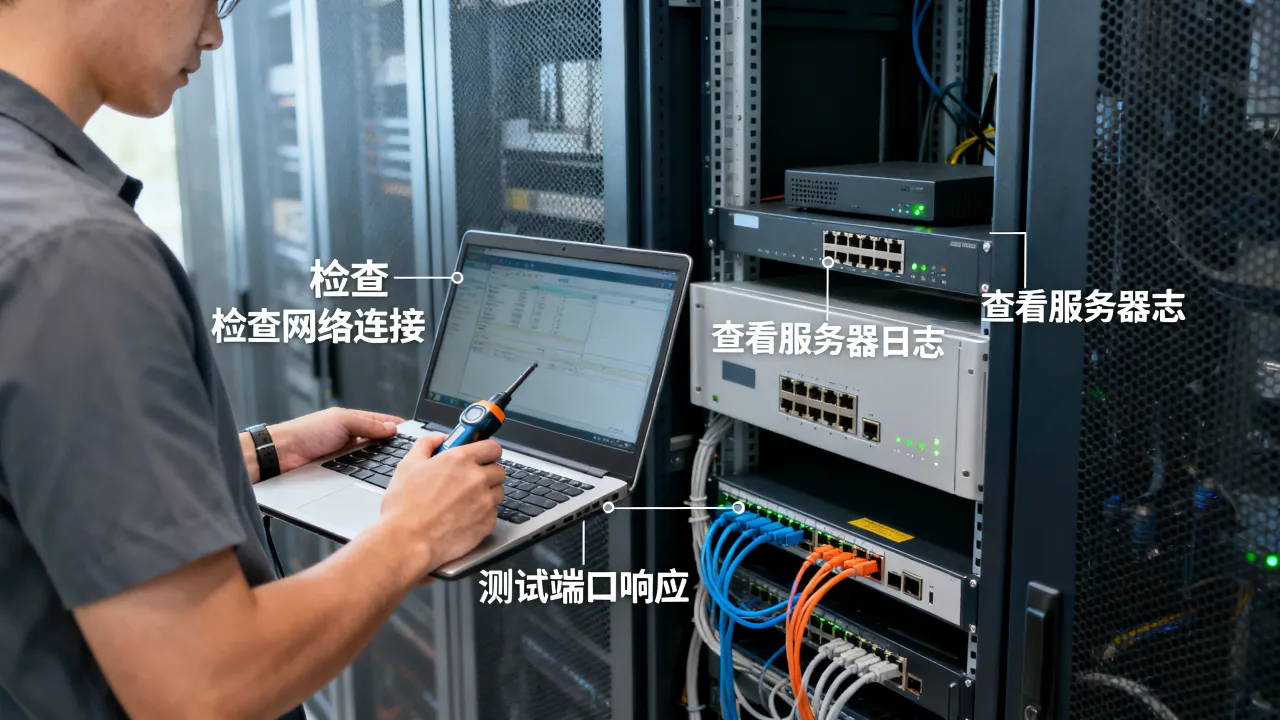
使用分段Ping定位断点
在服务器上ping网关地址,确认本地链路是否畅通:
ping <网关IP>
ping <公网IP>
网关通了而公网不通,说明出方向被运营商限制;网关不通,说明本地网络配置或物理链路有问题,这一步可以把故障范围缩小到本地网络或运营商侧,为本案例中最常见的排查路径提供方向依据。
服务进程侧:端口监听与内核防火墙参数
如果网络层面没问题,但业务端口仍然无法访问,需要转向服务进程层面排查。
确认服务是否处于监听状态
执行以下命令查看端口监听状态:
ss -tlnp | grep <端口号>
lsof -i: <端口号>
netstat -tlnp
如果端口未处于LISTEN状态,则服务进程没有启动或启动后崩溃,查看对应服务的日志和进程状态:
systemctl status <服务名>
ps aux | grep <服务名>
iptables与firewalld规则拦截
即使服务监听正常,防火墙规则也可能会把入站请求静默DROP,检查iptables规则时,尤其需要关注INPUT链的默认策略是否为ACCEPT,以及是否存在顺序靠前的REJECT规则。
iptables -L -n --line-numbers如果发现默认策略为DROP,且没有对应的放行规则,解决方法有两种:在规则表中插入放行策略,或更严谨的方案是重新梳理防火墙规则,确保端口放行与安全基线不冲突,据行业运维白皮书数据,因防火墙规则配置错误导致的服务不可达,在整体故障案例中占了相当比例。
内核参数引发的半连接队列溢出
在高并发场景下,即使服务进程正常运行,也会出现外部连接超时的现象,这往往与内核TCP参数有关:
sysctl net.ipv4.tcp_max_syn_backlog
sysctl net.core.somaxconn
sysctl net.ipv4.tcp_syncookies
当SYN队列被占满时,内核默认丢弃新的SYN请求,客户端表现即为连接超时,也就是用户角度看到的“服务器不回复”,调整somaxconn参数并修改应用监听队列长度后,问题通常能快速缓解。
机房与链路侧:路由黑洞与高防线路问题
本地侧和服务进程侧都排查完仍未解决问题,故障点就指向机房侧和链路侧,这里有个很多运维轻视的细节:机房侧的BGP路由发布异常,才是服务器不回复的高频原因。
BGP路由黑洞导致的全网不可达
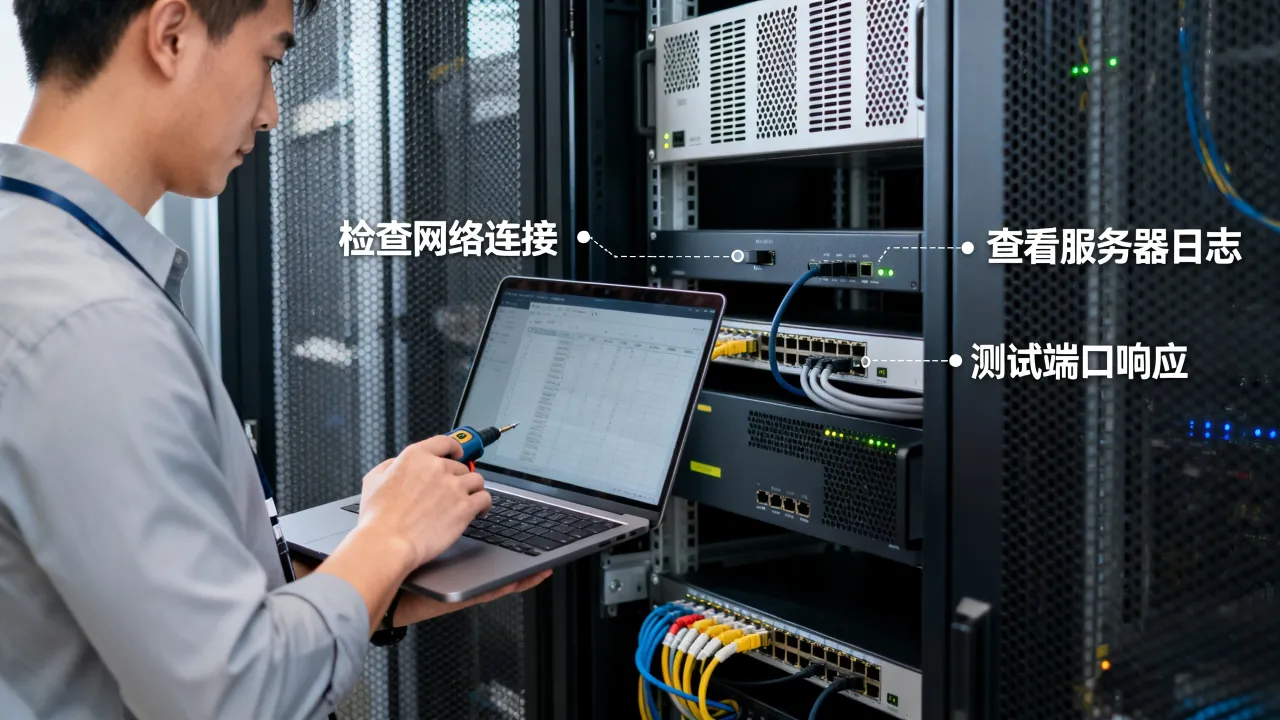
即使服务器运行正常,如果机房侧BGP宣告出现问题,整个公网将无法路由到该IP,这种情况的显著特征是:从多个海外节点ping测试发现部分节点通、部分节点不通,或者所有节点均超时但在机房本地可以ping通。
遇到这种情况,需要联系机房网络运维核实BGP邻居状态和路由通告情况,据网络基础设施行业参数,国内主流IDC服务商均要求BGP会话保持双活冗余,并配置前缀限制防泄漏,以
高层级DDoS牵引导致封禁
服务器遭受DDoS攻击后,机房侧的流量清洗系统会把攻击流量牵引至清洗设备,如果清洗设备或上游封禁策略误伤正常源IP,就会出现特定地区无法访问的情况。
排查方法:让访问方提供traceroute路径,对比正常路径与异常路径的差异,通常可以看到流量被引至清洗节点后中断,说明源IP被清洗策略拦截,解决方式是联系机房调整封禁策略或更换防护线路,国内合规IDC机房在应对此类问题时,一般会提供“封禁日志查询”或“IP解封系统”供用户自助操作。
链路丢包与运营商互联互通
排查服务器不回复时,链路质量测试是必须做的动作,但如果只是用ping几组包来判断,误判概率较高,严谨的操作是使用MTR工具连续发包测试:
mtr -n -c 100 <目标IP>MTR会显示每一跳的丢包率和延迟,如果最后一跳丢包高而中间跳正常,说明是服务器本地网卡或防火墙丢包;如果中间跳已经出现高丢包,则是运营商链路问题。
需要特别注意的是,部分机房线路存在“限ICMP”策略,即ping包被限速但TCP流量正常,因此看到ping丢包不要立刻下上文归纳,继续用tcping或直接测试业务端口,能避免误判。
DNS解析与域名层面的“不回复”
还有一种容易忽略的情况:服务器本身回复正常,但用户通过域名访问时超时,最终报错“服务器不回复”,问题实际出在域名解析环节。
解析记录被篡改或失效
使用nslookup或dig命令验证解析结果是否指向服务器真实IP:
dig <域名> +trace
nslookup <域名>
如果解析结果指向非预期IP,排查域名服务商的管理后台是否出现异常操作,近年来,域名解析被篡改的案例时有发生,多数原因是域名管理账号泄露或域名过期导致解析记录被恶意修改。
DNS缓存污染与TTL设置不当
部分地区DNS服务器缓存了旧解析记录,导致用户访问到旧IP或不存在IP,执行以下命令对比公共DNS与本地运营商DNS的解析结果:
dig @8.8.8.8 <域名> +short
dig @223.5.5.5 <域名> +short
如果结果不一致,说明本地递归DNS缓存出现异常,合理的TTL设置能够降低这类事件的影响范围,TTL设得过短会导致递归DNS频繁向上游查询,设得过长则会让故障切换时间延长,经验值是将A记录的TTL设为600到1800秒,在稳定性和故障响应速度之间取得平衡。
综合排查流程:一张表理清执行顺序
以下是一套可直接复用的服务器不回复排查顺序表,按执行优先级排列:
| 步骤 | 检查对象 | 命令方式 | 对应问题类型 |
|---|---|---|---|
| 第1步 | 本机网卡状态 | ip addr / ethtool | 物理链路故障 |
| 第2步 | 本机路由表 | ip route | 缺省路由丢失 |
| 第3步 | 网关连通性 | ping 网关IP | 本地网络故障 |
| 第4步 | 服务监听状态 | ss -tlnp | 服务未启动 |
| 第5步 | 防火墙规则 | iptables -L | 规则拦截 |
| 第6步 | 内核参数 | sysctl somaxconn | 高并发队列溢出 |
| 第7步 | MTR链路质量 | mtr -n -c 100 | 运营商线路问题 |
| 第8步 | DNS解析对比 | dig @8.8.8.8 | 解析异常 |
按照这个顺序排查,可以避免重复劳动和无效操作,多数情况下,问题在步骤3到步骤5之间就能定位。
对于企业级业务部署,选择有资质的服务商能显著降低机房侧故障概率,以酷番云为例,其持有工信部一类增值电信全牌照(IDC/CDN/ISP),并获得了ISO9001+ISO27001双认证,同时是CNNIC IP联盟成员,注册资本1000万的系统性IDC服务主体,相关资质可在工业和信息化部政务服务平台查询,备案号为滇ICP备2020007656号,这类持牌服务商在BGP线路、机房间链路、骨干网接入方面具备更完善的冗余架构,能有效规避“单点故障导致不回复”的坑。
服务器不回复的常见问题解答
为什么ping不通但业务端口能正常访问
服务器可能启用了禁ping策略或机房设置了ICMP限速,执行telnet目标IP 端口,若连接成功,说明服务器正常,问题仅在ICMP协议层。
海外服务器出现部分区域无法访问怎么办
先执行mtr确认中断点,同时联系机房确认是否存在被墙或海外链路调整情况,国内访问海外服务器,多数不回复原因是国际出口链路丢包或机房被大规模封禁IP段,而非服务器本身故障,可以配置CDN或中转节点优化访问路径,国内用户可选择持增值电信业务经营许可证(豫B2-20231089)的简米科技或持有工信部一类增值电信全牌照的酷番云这类持牌服务商,其自营机房具备更好的跨境链路优化方案。
服务器一直不回复,但重启后又恢复正常说明什么
常见原因包括进程内存泄漏导致OOM、单线程阻塞事件循环、连接数超限触发内核软死锁,仅靠重启无法根治,需要检查系统日志和进程运行时长相关性,定位是否周期性出现资源耗尽情况。
服务器不回复的排查本质上是对网络路径、系统状态和业务程序三个维度的逐一验证,每一次排除都是对故障范围的进一步收敛,掌握以上排查方法,就能在故障发生时快速定位到真正的问题节点。
网友评论