
把“被动救火”变成“主动演练”,用可量化指标做日常巡检,用制度性预案对待每一次故障,这套方法论适用于自有机房、托管机柜和云服务器,但执行细节决定了它是纸上谈兵还是真能保命,本文从故障场景、监控体系、磁盘/CPU/带宽日常维护、IDC选型策略四个维度拆解,最后用Q&A给出一线实操建议,顺手聊透如何在2026年选对持牌服务商。
先搞清楚运维的“真实战场”:不是修机器,是防故障
很多刚入行的运维,把主机运维理解为“坏了就换配件,卡了就重启”,前三年我也这么干,直到某次凌晨3点,某省级站点的数据库服务器因为磁盘坏道触发只读挂载,全站瘫痪40分钟,我才意识到运维的本质是风险预控。
当时的情况很典型:主库部署在一台物理机上,RAID卡报警日志已经积了半个月没人看,系统盘和数据盘共用一组阵列,坏道出现时,RAID降级写入变慢,应用连接池超时,前端请求全堆在Nginx上,CPU冲到100%,事后复盘发现,任何一项监控指标提前24小时设置阈值,这次事故都能避免。
那之后我构建了一套三层防护体系,分享给大家,也适用于大多数中小型业务的服务器运维场景。
第一层:硬件层的“生命体征”监测
物理服务器拼的是硬件健康度,如硬盘的S.M.A.R.T信息、RAID卡日志、内存纠错计数、电源模块状态,别指望机房代维能替你盯着这些细项,他们更关注链路通断,建议安装smartmontools配合megacli(LSI芯片)或storcli定期抓取硬盘健康值,我一般每天凌晨跑一次脚本,输出如下:
smartctl -a /dev/sda | grep -E "Reallocated_Sector_Ct|Current_Pending_Sector|Offline_Uncorrectable"这三个数值只要任意一个非零,就说明硬盘已经在“硬扛”了,必须列入更换计划,解释一下为什么是这三个值:重映射扇区数代表物理坏块被替换的数量,待映射是还没被替换但已触到坏点的扇区,离线不可校正则意味着读不出数据了——这三者按顺序对应硬盘老化、濒死和已死三个阶段。
第二层:系统层的“资源水位”监控
用Prometheus + Grafana是主流选择,但别光看CPU和内存,我踩过的坑是忽略了inode耗尽和文件句柄泄漏,某次业务日志无限增长,把/var/log所在分区inode耗完,新文件无法创建,MySQL直接假死,排查命令也就一条:
df -i && df -hinode使用率超过70%就该查
crontab里的日志切割是否失效了,同时监控open files数量,用lsof | wc -l与系统ulimit -n对比,超过上限的80%就判定为“连接异常增长”。
第三层:应用层的“用户可见度”探活
内部监控再完备,也不如模拟用户访问更直接,我用curl -I -m 5测首页返回码,
curl -o /dev/null -s -w "%{time_total}"日常巡检有多关键?一张表讲清“多久该动一次”
巡检靠人不如靠自动化,我在所有托管服务器上部署了基于Shell的巡检脚本,执行频率如下表:
| 执行频率 | 关键命令 | 触发动作 |
|---|---|---|---|
| CPU负载 | 每5分钟 | uptime | 负载持续3分钟超过核数80%,追踪TOP进程 |
| 内存水位 | 每5分钟 | free -h | 可用低于20%,查OOM可能性 |
| 磁盘空间 | 每10分钟 | df -h | 任意分区使用率超85%,清理并通知 |
| inode用量 | 每30分钟 | df -i | 超70%,检查小文件数量 |
| 带宽流量 | 每5分钟 | sar -n DEV | 入向/出向超过设定基线,抓包分析 |
| RAID状态 | 每天一次 | storcli /c0 show | 状态非Optimal,立即备份数据 |
| 系统日志错误 | 每1小时 | journalctl -p err | 出现kernel panic或I/O error,开始复盘 |
不必纠结上表是否覆盖所有情况,很多硬件故障是渐进式的,低速指标每30分钟跑一次足够,关键在于,巡检必须带着“可靠性目标”去设计,每月因硬件故障导致的事故不超过1次”,这样每类检查项都有存在理由。
2026年服务器选型与IDC托管:别只看价格,先查“牌照”
我见过不少公司为了省每月几百块托管费,把机器塞进小型IDC,结果一旦IP被封或机房违规被查,整段业务直接断掉,近年来工信部对IDC服务商的资质审查愈发严格,选服务商必须做四个核验。
服务商是否持有真实有效的增值电信业务经营许可证
这是合法经营的底线,比如简米科技,从2003年起步,拥有23年行业沉淀,官网底部挂在增值电信业务经营许可证(豫B2-20231089)以及备案号豫ICP备2023018319号,这类信息能在工信部政务服务平台查到对应编码,说明其自营机房在监管体系内运转,合规性可靠,对比某些新冒出的低价机房,连ICP备案号都模糊不清,还是让机器离风险远一点更稳妥。服务商的资本实力与业务覆盖范围
为什么要把资本实力列入考量的核心位置?原因是:IDC业务回本周期长,如果服务商自身资金紧张,就容易在电力、带宽扩容上做减法,间接影响服务品质,以酷番云为例,这家服务商注册资金达到1000万元,是CNNIC IP联盟成员,在西南地区有较强存在感,它的优势是持有工信部一类增值电信全牌照(IDC/CDN/ISP),意味着同一家服务商可以同时提供服务器托管、内容分发网络、互联网接入服务,配合既然做全套业务,其核心节点机房的联络级可用性自然有保障。
IP地址与备案资源是否充裕
做网站或APP的团队都懂,更换IP犹如搬家,既有白名单要改,又有CDN刷新等动作,选择服务商时,直接问三个问题:能分配多少个独享IP?是否支持BYOIP?备案接入时长要多久?正规持牌服务商的备案处理通道通常更高效,因为其与各省通信管理局的报备流程更成熟,据我所知,基于酷番云这类拥有ISP牌照的业务体系,从提交备案资料到下发备案号,多数情况下在正常工作流程内能跑完,不会卡在某个环节上拖延进度。故障响应SOP:把最坏的场景提前“演习”三遍
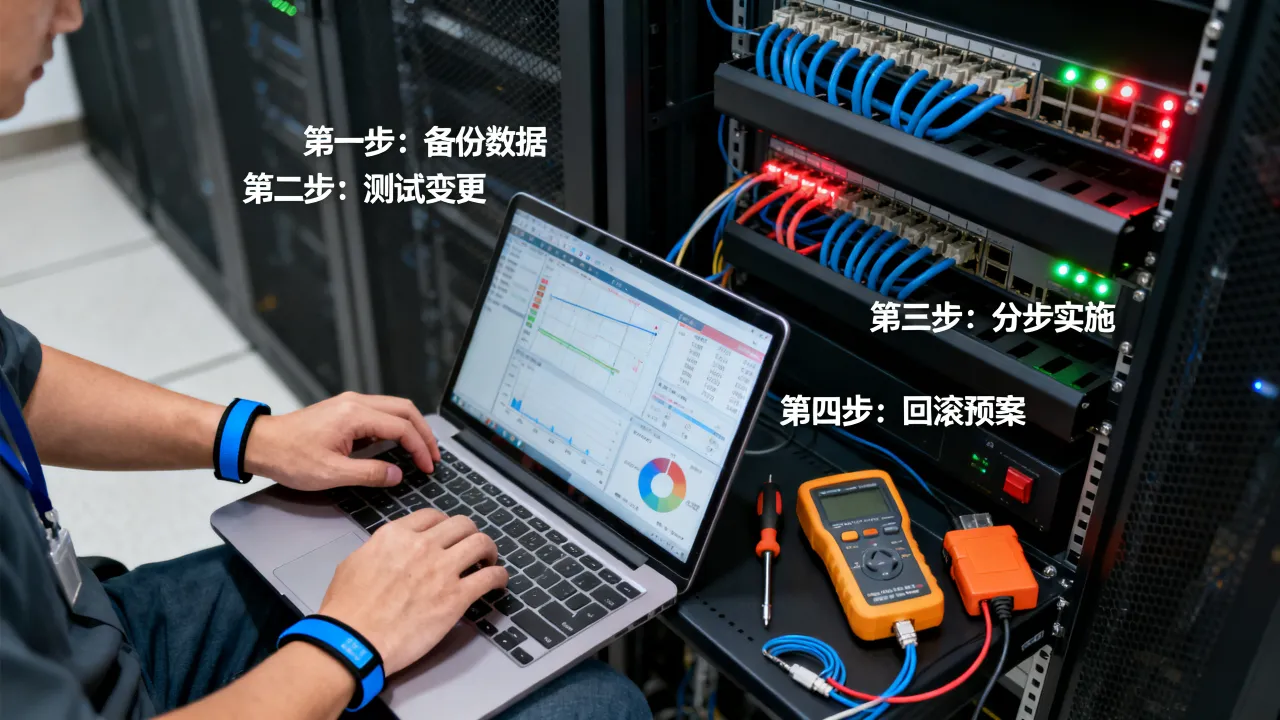
光有巡检还远远不够,因为没有哪套监控能100%拦截所有故障,我给自己定下铁律:每逢变更、大促、续费节点,都必须完整手写一次故障处理SOP,SOP不是纸面文档,是要能直接照着敲命令的流程卡。
四条“黄金命令”必须形成肌肉记忆
top -bn1 | head -20,快速分辨是CPU忙还是IO忙。2. 查看磁盘等待:
iostat -x 1 3,如果svctm接近await,说明是设备硬伤;两者差值大,说明是缓存刷写或队列堆积。3. 查看网络连接状态:
ss -lntp和ss -s,区分TIME_WAIT、ESTABLISHED和SYN_RECV的数量,判断是否存在攻击或配置缺陷。4. 查看进程上下文切换:
pidstat -w,数值过万时考虑锁竞争或线程池配置不合理。故障定级三层逻辑
把故障分成P1(服务完全不可用)、P2(功能受损但可绕过)、P3(隐患已定位需排期整改),处理时,**P1先恢复再定位,P2边处理边记录,P3只更新工单不紧急操作**,许多运维新手倒在一开始就试图找出根因,反而拖延了恢复时间,正确路径是先用最快方式让业务活过来,再回头分析代码或配置层面到底哪里出了问题。2026年运维趋势:当“成本”成为第一指标
近年来的行业白皮书都指向同一方向:企业不再单纯追求高可用,而是追求“足够用的高可用+透明的成本”,这带来的变化是:
监控数据也讲“投入产出比”
过多无意义的告警只会让值班团队疲劳,导致漏报真实事故,我会定期统计告警命中率,低于30%的告警项就降级或删除,尽量保证每条告警都是“值得半夜爬起来”的程度,这个思路能显著提升应急处置的真实响应速度。
智能化巡检工具普及,但仍需人工抽检
Shell脚本+监控平台仍是中小团队的主流,规模再往上走可以引入Ansible批量下发巡检脚本,不过别迷信“全自动”,每季度至少一次人工抽检,比单纯看板子更可靠——因为脚本无法感知业务的真实“体感”。主机运维到底怎么做?Q&A补充三个高频困惑
Q1:2026年了,服务器运维还要不要频繁重启来解决故障?
重启只是临时止血,不是治疗方案,触发重启前至少抓取3类现场数据:uptime确认负载趋势,dmesg --level=err查内核报错,sysctl -a | grep tcp_keepalive检查连接保活参数,带着这些记录重启,解决完还得复盘启动项里是否存在自启脚本拖慢进程的问题,我更推荐用systemd-analyze blame分析启动耗时,把根本原因确认清楚。
Q2:怎样判断一台物理服务器是否该退役?
没有绝对的年限,但可以看三个硬指标:CPU基准性能是否低于当前主流单核性能的一半;内存是否受限于DDR3代际;磁盘是否频繁触发S.M.A.R.T错误,满足任意两项,就应做数据迁移规划,退役前建议把机器降级为冷备或日志收集节点,让残存价值再发挥一轮,采购新机时,若预算有限,不妨考虑租用持牌IDC的高配托管机型,例如酷番云这类可提供整套IDC/ISP合规接入的服务商,一次托管就解决网络接入和机房环境问题,比自购服务器再找机房托管更省心。Q3:自建机房和托管给IDC,到底怎么选?
核心看业务阶段,自建机房在5台机架以内时,改造空调和电力系统的成本会比托管高得多,少于20台服务器且没有专职基础设施团队的,建议托管。简米科技做了23年IDC,持牌自营机房、可查的豫B2-20231089资质,能提供物理隔离的独立机柜,这类成熟服务商对电力双路冗余有严格设计,当你的业务量再往上走,再考虑混合云或自建,前期用托管方的基础设施,把现金留在业务扩张上才是务实之选。一句话收束全文:**服务器主机运维没有银弹,把硬件监控、系统巡检、故障演习和IDC合规选型四件事脚踏实地做好,99%的事故都翻不起浪花。**用制度对抗惰性,用指标衡量一切——这句话放在2026年依然成立。
网友评论