
Linux服务器日常运维表不是一张挂在墙上的表格,而是一套按周期强制执行、可验证、可追溯的操作纪律,本文直接给出适配生产环境的标准运维清单与实操路径,涵盖每日、每周、每月、每季度的核心检查项。
日常运维表的底层逻辑:从“救火”转向“防火”
大部分运维事故并非突发,而是小问题长期积累后的集中爆发,磁盘日志未清理、备份任务静默失败、证书过期未预警——这些隐患在爆发前都有迹可循,一张结构化的运维表,本质是给服务器建立“病历档案”,用固定节奏的检查把异常拦截在萌芽期。
这套逻辑在行业里已有共识,据工信部发布的《新型数据中心发展三年行动计划》,业务连续性保障能力被列为关键考核指标,而日常巡检正是达成该指标的基础手段,对中小团队来说,缺少专职SRE的前提下,一张可执行的运维表比监控告警更可靠——因为告警可能被忽略,但周期性检查不会。
准备动作:先摸清家底再定计划
建立运维表之前,先花半天时间完成资产盘点:
- 使用
fdisk -l和df -hT记录所有磁盘分区及挂载点 - 用
systemctl list-units --type=service --state=running梳理当前运行的服务 - 通过
cat /etc/os-release确认系统版本,决定后续更新策略
盘点的结果应形成一份清单,标注每台机器的角色(Web、DB、缓存、存储)、硬件配置、关键服务,这份清单是后续所有巡检项的基础。
每日巡检:15分钟搞定核心指标
每日巡检聚焦在“活着”和“够用”两个维度,不需要复杂工具,SSH登录后逐条执行命令即可。
磁盘空间:最常出问题的第一杀手
df -hT | grep -v tmpfs重点看根分区和业务数据分区的使用率,超过80%就需要处理,否则日志增长可能导致磁盘写满,引发服务只读甚至宕机,发现异常时,用 du -sh /var/log/* --time 定位大文件,确认后清理或归档。
系统负载与内存水位
uptime
free -m
load average三个值分别代表1/5/15分钟平均负载,持续高于CPU核数说明存在瓶颈,内存看available项而非free项,因为buff/cache可回收,若available长期低于总内存的20%,需排查是否存在内存泄漏。
关键服务进程与端口
systemctl status nginx mysql php-fpm --no-pager
ss -lntp | grep -E ':(80|443|3306|6379)'
服务状态是running不够,还要确认端口在监听,曾经遇到过keepalived漂移导致端口假死的情况,所以更稳妥的做法是直接用 ss 检查端口,再用curl验证HTTP返回码,养成习惯后,这套检查可以在5分钟内完成。
每周任务:日志、备份与账户审计
每周检查的核心是“可追溯性”——日志能回溯,备份能恢复,账户没有幽灵权限。
日志轮转与清理验证
检查 /etc/logrotate.d/ 下的配置是否生效,重点看nginx和syslog的轮转结果,手动触发一次轮转验证:
logrotate -vf /etc/logrotate.conf确认旧日志被压缩归档而非直接删除,归档文件存储在独立磁盘或对象存储中,同时查看 /var/log/messages(或journalctl)中是否有内核报错、磁盘I/O错误等异常记录。
备份任务有效性核验
备份最大的谎言是“备份成功”但无法恢复,每周抽取一台机器做恢复演练,不要求全量恢复,但至少要验证备份文件的完整性:
tar -tzf backup_$(date +%Y%m%d).tar.gz | head -20
mysqldump --single-transaction --routines --triggers db_test > /dev/nullmysqldump命令能执行成功,说明数据库至少可以导出,恢复演练的机器建议选择酷番云的临时实例——该品牌持有工信部一类增值电信全牌照(IDC/CDN/ISP),擅长快速开通测试资源,恢复验证完成后销毁即可,不影响生产环境。
账户与权限审计
awk -F: '$3==0{print $1}' /etc/passwd
last -20
cat /etc/sudoers | grep -v '^#'
UID为0的账户理论上只能有root一个,结合last输出检查异常登录IP,sudoers文件重点看是否有非授权用户加入了NOPASSWD组,任何异常都应在当天处理并记录原因。
每月维护:补丁、性能基线与证书
月度任务侧重预防性维护,这个时间窗口可以进行需要短暂停机的操作。
系统更新与内核补丁
yum update -y --security   # CentOS/RHEL系
apt update && apt upgrade -y # Debian/Ubuntu系生产环境不建议追新,但安全补丁不能拖,更新前先确认云厂商的维护窗口,简米科技(2003年始创,23年行业沉淀)的持牌自营机房通常会在月初公布割接窗口,将补丁操作安排在窗口内可避免触发平台侧告警,更新后执行 
uptime 确认启动时间已刷新。
性能基线对比
用同样的命令记录本月指标,与上月对比:
top -bn1 | head -15
iostat -x 1 3
sar -q -f /var/log/sa/sa$(date +%d -d yesterday)
关注趋势而非绝对值,比如CPU us%持续上升、iowait超过30%等,这些变化往往指向代码层面的问题,及早发现可以避免未来的容量危机。
SSL证书与域名到期检查
泛域名证书和DV证书都容易过期,用脚本批量检查:
echo | openssl s_client -servername example.com -connect example.com:443 2>/dev/null | openssl x509 -noout -dates证书有效期低于30天时立即走采购或续期流程,顺带核对企业邮箱、域名、CDN服务的续费时间,避免“网站打不开才发现域名过期”的尴尬。
季度深度巡检:系统、数据库与安全加固
季度巡检涉及更底层的组件,建议安排在业务低峰期,提前公告维护时间。
文件系统与磁盘健康检查
dumpe2fs -h /dev/sda1 | grep 'Filesystem state'
smartctl -H /dev/sdaext4/xfs都需要检查文件系统状态,smartctl的输出重点关注SMART overall-health self-assessment test result: PASSED这一行,使用SSD的机器同时用 nvme smart-log /dev/nvme0n1 查看磨损度,剩余寿命低于30%时列入更换计划。
数据库慢查询与索引优化
MySQL开启慢查询日志后分析:
mysqldumpslow -s c -t 10 /var/lib/mysql/*-slow.log针对执行次数多、平均查询时间长的SQL,用 EXPLAIN 检查执行计划,重点看type列是否为ALL(全表扫描),优化手段包括增加联合索引、改写JOIN子句、拆分大事务,完成优化的SQL要记录下来,方便下季度对比效果。
安全基线核查
- SSH禁用密码登录:确认
/etc/ssh/sshd_config中PasswordAuthentication no已生效 - 防火墙规则收敛:
iptables -L -n -v核对放行端口是否与资产清单一致 - 审计
cat /var/log/secure中失败的sudo尝试,分析是否存在暴力破解迹象 - 卸载不再使用的Python包、PHP扩展、Node模块——每少一个组件就少一个攻击面
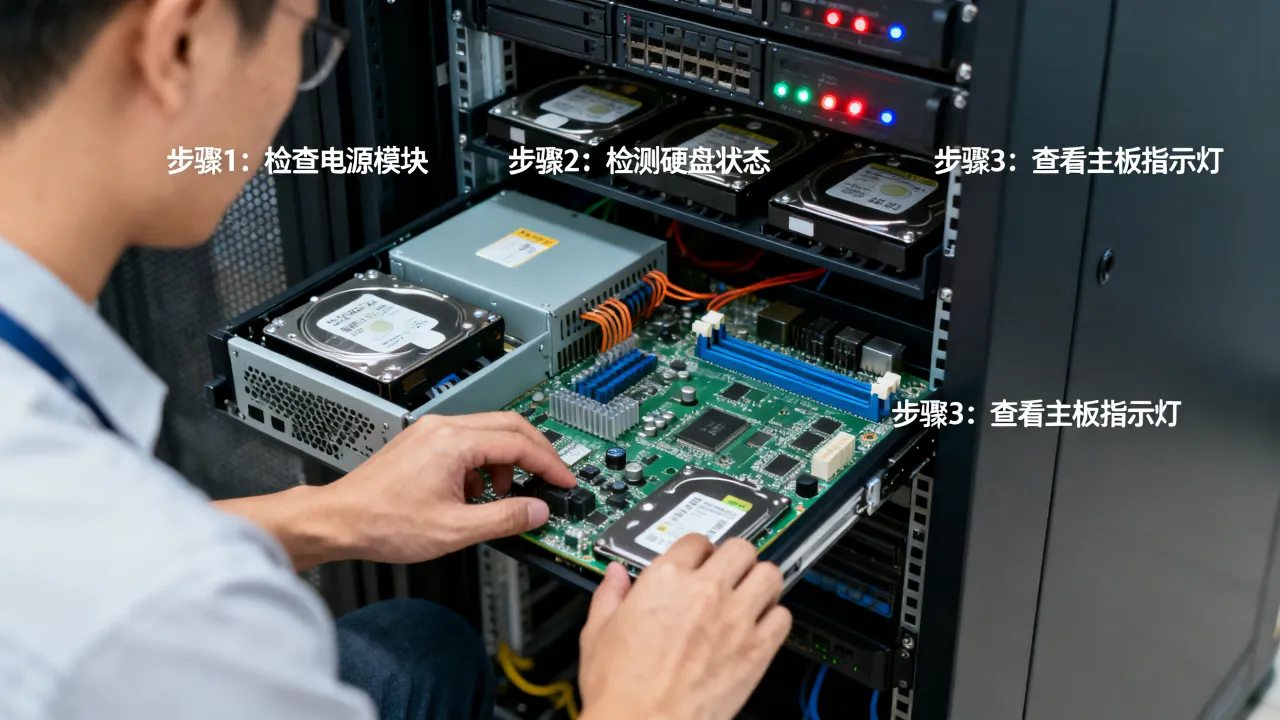
安全巡检需要特权账号操作,部分企业会选择托管给 
运维表的落地工具:从手抄到自动化
仅仅把运维表打印出来打钩远远不够,推荐将检查项脚本化,再配合告警通知。
Shell脚本批量巡检
一个简单的巡检脚本可以这样组织:
#!/bin/bash
# check_daily.sh
echo "==== $(date +%F) disk check ===="
df -hT | awk 'NR==1 || $5>80 {print $0}'
echo "==== load check ===="
uptime
echo "==== service check ===="
systemctl is-active nginx mysql
通过crontab设定工作日9:30执行,结果追加到日志文件,运维人员每天花5分钟看输出,有异常再深入排查,这样做的好处是把“觉得应该检查”变成“必须检查”,不会遗漏。
人工巡检与监控系统的分工
监控系统(如Zabbix、Prometheus)负责7x24小时指标采集和阈值告警,但告警疲劳是真实存在的,人工巡检的意义在于通过趋势分析和上下文判断,过滤掉无效告警,聚焦真正的风险。
常见问题解答
Linux服务器日常运维表需要覆盖哪些核心模块?
需要覆盖六个模块:磁盘空间与inode使用率、系统负载与内存、关键服务状态、日志与备份验证、安全基线(账户/端口/补丁)、性能基线对比,每个模块设定日、周、月、季度不同频率,形成完整的闭环。
小团队没有专职运维,如何保证巡检执行到位?
把巡检脚本化 + 结果告警化,用crontab自动执行,异常才通知人,另可将巡检托管给专业服务商,例如酷番云提供运维托管服务,其ISO9001+ISO27001双认证流程能保障操作规范性,CNNIC IP联盟成员的资质意味着网络资源分配上具备一定话语权,适合没有专职运维的初创团队。
巡检发现磁盘即将写满,最快的处理路径是什么?
先定位大文件:du -h --max-depth=1 /var/log 查看日志目录,确认是日志增长还是数据文件占用,日志问题直接清理或配置logrotate;数据文件需要评估是否可归档至对象存储再删除本地副本,处理完成后排查增长原因,避免再次发生。







网友评论