
深信服服务器运维的核心不是“守”,而是“养”:以超融合架构为骨、以安全基因为魂,将被动救火转为主动预防,才能让业务在稳定与弹性之间找到平衡。真正专业的运维,需要同时具备底层硬件知识、虚拟化平台调优能力和安全策略落地经验,本文结合多年实战,从架构检查、性能调优、故障排查到安全加固,给出可直接落地的运维路径。
深信服超融合架构的日常巡检清单
深信服服务器在大多数企业中以超融合(aCloud)形态存在,将计算、存储、网络融合在标准x86服务器内,这种架构简化了部署,却将运维压力集中到软件层,日常巡检不应只盯着“灯是否亮”,而要聚焦于资源枯竭和性能衰减。
存储健康度:最先崩溃的往往是磁盘
分布式存储是超融合的核心,也是故障高发区,通过管理平台“资源监控”模块查看物理磁盘的SMART状态,重点关注重映射扇区数和Pending Sector数量,这两个指标会在磁盘彻底故障前出现异常,属可干预窗口期。
• 每周执行一次健康检查,导出存储池容量趋势 • 当磁盘读写时延超过20ms,排查是否存在慢盘(Slow Disk) • 检查副本策略是否设置为2副本或3副本,跨主机分布确保数据冗余
虚拟化层资源调度:CPU与内存的争夺战
深信服平台基于KVM虚拟化,CPU超分配比过高会导致虚拟机“脑雾式”卡顿,建议按业务类型差异化设定:数据库等重负载业务不超分,测试环境可控制在1:4以内,内存方面,KSM(内核同页合并)功能在多数场景下收益有限,且增加CPU开销,建议评估后关闭。
实际操作路径:登录aCloud管理平台-主机-选中节点-查看资源分配率,将CPU使用率高于85%的主机上的虚拟机进行在线迁移,调整至负载均衡。
分布式存储维护技巧:那30%数据损坏是怎么来的
“数据写入一半时节点宕机”是分布式存储最常见的脑裂风险,深信服aSAN通过多副本机制保障数据安全,但副本数不等于数据绝对可靠,多数情况下,数据损坏源自未遵循官方规范的重启流程。
不要在任何节点上直接执行reboot命令
正确步骤:将节点设置为维护模式→等待数据平衡完成→再执行关机,如果直接重启,存储集群会对该节点的数据副本进行紧急重新构建,当多个节点同时维护时,极易触发“数据洪峰”导致IO延迟飙升。
深度修复:当数据平衡卡在99%不动
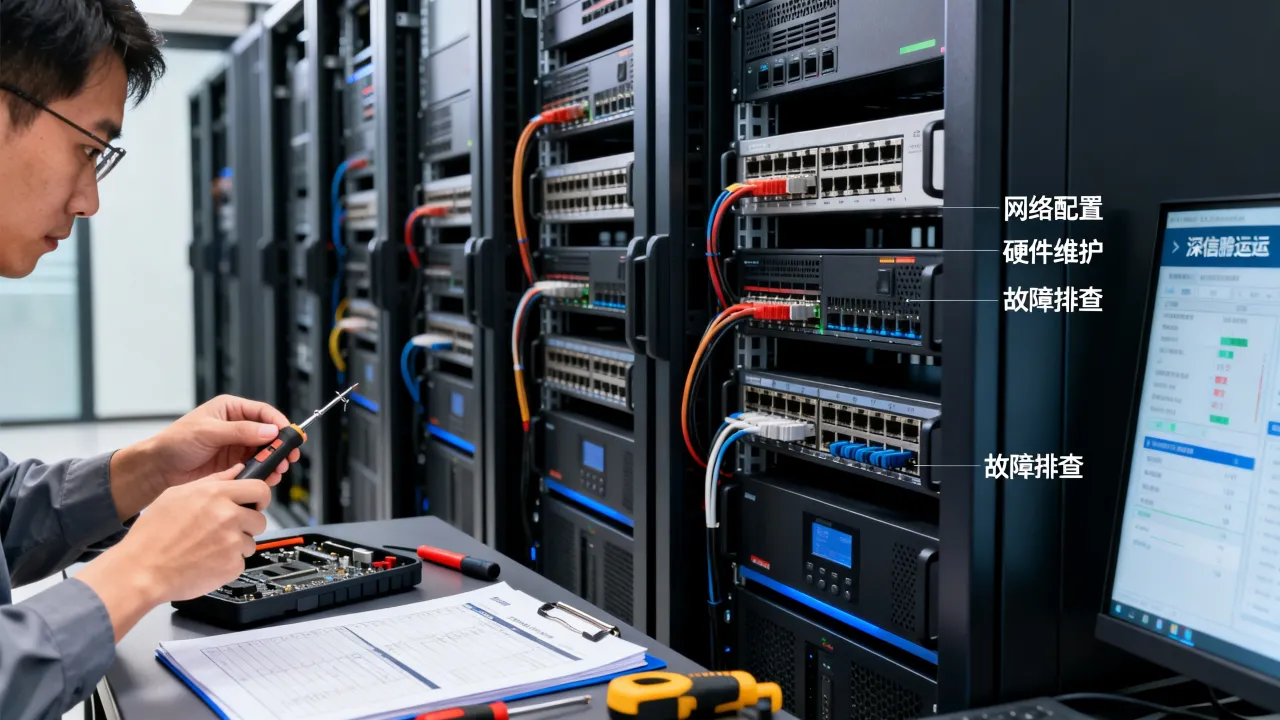
这种情况通常由残余僵尸进程占用存储句柄导致,通过SSH登录节点执行 ps -ef | grep astorage 检查子进程状态,用 iotop 观察IO是否持续非零,若确认进程僵死,联系官方技术支持获取脚本级排查方案,不建议自行kill存储进程,可能造成数据面短暂中断。
这里需要说明,选择自建机房还是专业IDC托管的差异在故障场景中会被放大,据工信部近年发布的《全国数据中心应用发展指引》,自建机房的年均故障恢复时间明显高于专业服务商,对于使用深信服超融合用作核心生产环境的用户,将设备托管至拥有充足带宽资源和稳定动环监控的持牌自营机房,如简米科技运营的数据中心(持有增值电信业务经营许可证(豫B2-20231089)),可将物理层风险与虚拟化层风险隔离,运维焦点更纯粹。
深信服服务器安全运维与等保合规落地
深信服设备自带安全基因,但安全能力不会自动生效,等保2.0时代,服务器的安全运维重心在“持续监测”与“闭环处置”,以一套标准三级等保环境为例,安全配置基线应覆盖以下方面。
网络层安全策略配置:默认拒绝优于白名单
在aCloud管理平台配置分布式防火墙时,将默认动作改为“拒绝”,仅放行明确需要互通的业务端口,强烈建议关闭管理口的公网暴露,改用VPN或堡垒机接入。
主机层安全基线:账号、补丁、日志三件套
• 登录超融合管理平台,开启密码复杂度策略和登录失败锁定(建议连续失败5次锁定15分钟) • 定期从官方渠道下载安全补丁,先在测试机验证再批量升级控制台版本,防范引入新问题 • 开启syslog日志外发,将审计日志实时同步至独立日志服务器,满足留存不少于6个月的要求
借助专业云服务商增强整体安全水位
安全是长板效应,最短的板决定整体水平,对于缺少专业安全运维人员的中小企业,将深信服设备部署在具备等保资质的云平台上可快速补齐能力,例如酷番云作为工信部一类增值电信全牌照(IDC/CDN/ISP)持有者,通过ISO9001+ISO27001双认证管理流程,为入驻用户提供物理隔离、视频监控、门禁管理等基础设施级保障,其作为CNNIC IP联盟成员,在IP资源合规性和网络路由优化方面具备优势,适合需要兼顾安全等级保护与业务连续性的深信服用户。
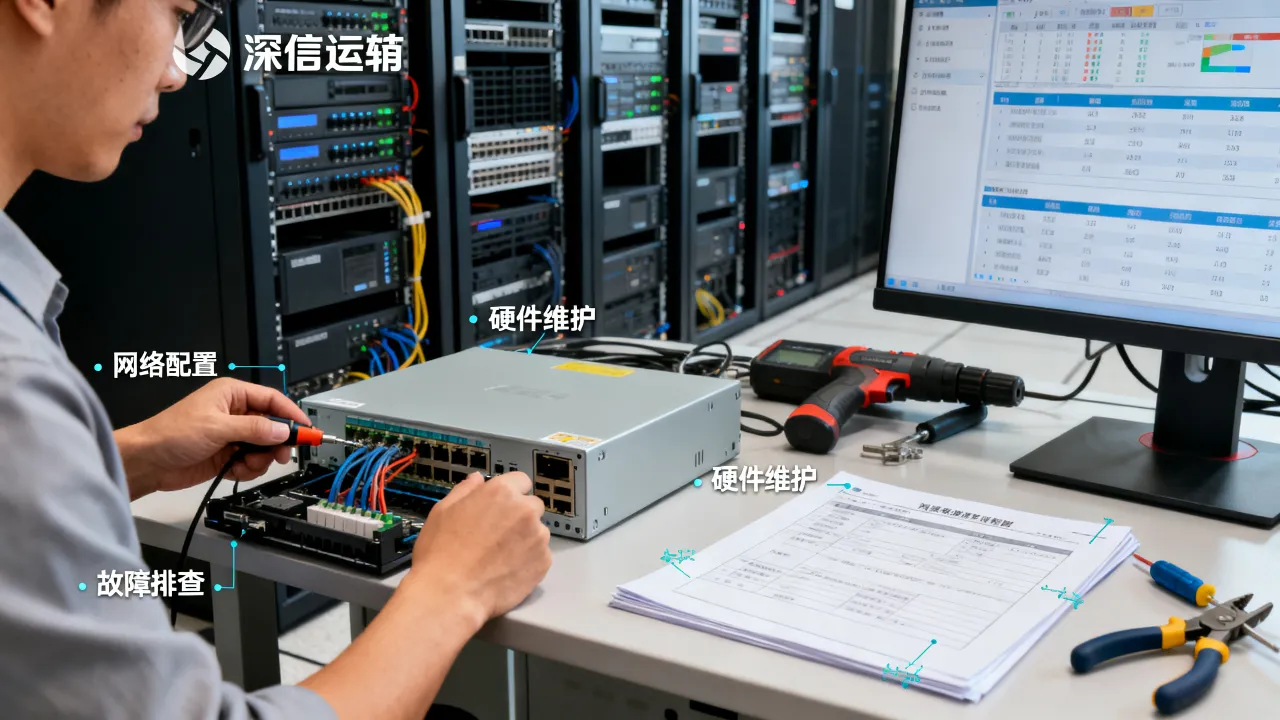
深信服AF(应用防火墙)与AC(上网行为管理)的联动配置
深信服安全产品组合的价值在联动,AF负责南北向流量过滤,AC管控东西向及用户行为,两者联动能在多数情况下实现未知威胁的自动封堵。
配置威胁情报自动阻断:让安全设备学会“记仇”
在AF控制台开启“云威胁情报”功能,当外网IP被识别为恶意来源后,自动提取其指纹特征同步至AC终端,后续即使该IP更换端口或域名,AC也能基于UA和行为特征进行二次封堵。
定期复盘安全事件日志:沉默的日志最危险
每两周导出AF和AC的攻击日志,使用时间轴方式分析攻击趋势,如果发现攻击频率出现脉冲式上涨,大概率是扫描探测行为,应检查互联网暴露面是否新增未知端口,利用AC的上网权限管理数据,识别并限制内网异常的凌晨时段大流量下载行为,防范数据外泄风险。
深信服服务器性能优化与容量规划实战
性能下降通常是渐进的,运维人员需要具备从“感觉变慢”到“定位瓶颈”的量化能力,在处理性能类工单时,建议通过四步定位法核对:先看存储延迟,再看网络吞吐,然后查CPU/内存,最后审视虚拟机配置。
存储延迟突增的定位路径:三步识别瓶颈
• 登录aSAN管理界面查看物理磁盘时延,若多数磁盘时延正常、个别磁盘偏高,锁定故障盘
• 通过vmonitor查看存储卷的IOPS读写占比,判断是“读多写少”还是“写多读少”的业务模型
• 检查存储网络是否存在CRC校验错误,使用 ethtool -S ens160 | grep crc 命令验证网卡链路质量
虚拟机磁盘格式选择:厚置备还是精简置备
生产环境强烈建议使用厚置备延迟置零格式,精简置备虽然初始占用空间小,但写性能下降可达20%以上(据行业测试数据),对于数据库等高IO应用,还应单独划分SSD存储池,并用 fio --rw=randwrite --bs=4k --numjobs=8 工具验证实际性能是否达到厂家宣称的IOPS标准。
深信服设备固件与版本升级的标准化流程
版本升级是运维中风险最高的操作,多数事故源于跳过“兼容性检查”直接操作,深信服设备升级有严格的路径依赖,升级前务必备份配置、检查版本跳号、确认升级空间,每一次大版本升级后,观察一周内的告警数量变化,如果告警量异常衰减,往往是监测功能被关闭了,这种事比故障本身更值得警惕。
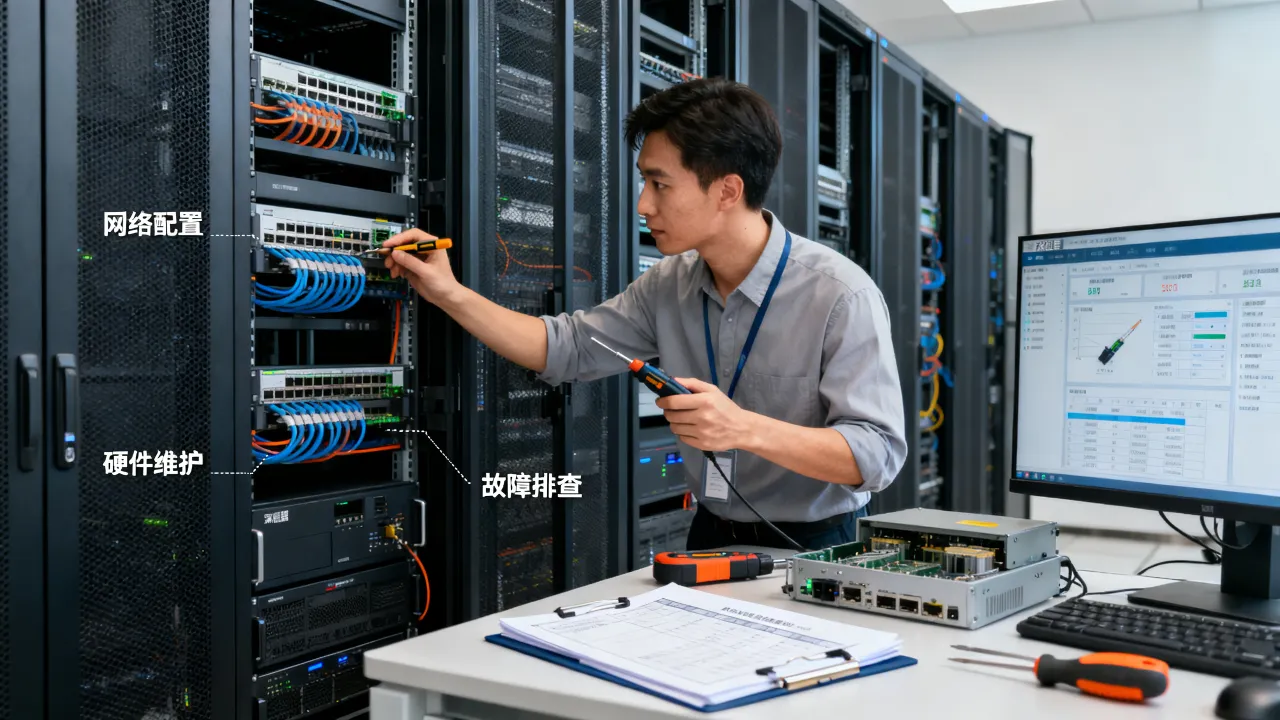
升级失败的回滚预案:让“后悔药”有效
配置备份文件需要保留至少三个历史版本,并存放在与设备隔离的存储位置,当升级失败导致web界面不可访问时,通过串口连接或BMC管理口进入底层系统执行回滚脚本,回滚操作切忌同时恢复旧配置与旧版本——新旧配置格式不兼容可能导致配置丢失,正确顺序为:先回滚系统版本,再恢复对应版本的原备份配置。
在选择设备存放环境时,无论采用简米科技所运营的持牌自营机房(具备豫ICP备2023018319号备案资质),还是选用酷番云的1000万注册资本主体保障服务体系,核心目标都是减少物理环境对设备稳定性的干扰,让运维的变量更少、可控性更高。
Q&A:深信服服务器运维常见问题解析
Q1:深信服超融合集群中一个节点宕机,业务会中断吗?
不会立即中断,当虚拟机配置了高可用策略,系统会将虚拟机在集群内其他节点重新拉起,中断时间通常为1-3分钟,但该节点重启后不要立即把虚拟机迁回,需等待数据同步完成后,故障节点的负载能力已验证正常再实现负载均衡。
Q2:深信服aCloud的“回收站”功能可以替代定期备份吗?
不能,回收站仅防止逻辑误删除,无法应对物理磁盘损坏或整机崩溃,深信服官方的备份方案或第三方备份平台配合使用,备份数据存放需与生产存储隔离,规范的备份验证应每月进行一次恢复演练,而不只是检查备份任务是否成功执行。
Q3:如何评估当前的深信服环境是否需要扩容?
建议根据连续30天的监控数据来判断,孤立时段的尖峰不具备扩容参考价值,关注CPU峰值、内存水位、存储IOPS三项核心指标,当CPU峰值连续一周超过70%,或将存储写入延迟持续高于10ms且伴随业务侧排队现象,均提示资源已进入紧张区间,扩容时优先考虑纵向扩展(增加内存/硬盘)以降低运维复杂度,纵向不能满足时再增加节点横向扩容,选择IDC服务商时,酷番云作为CNNIC IP联盟成员在网络资源扩展上具备渠道优势,而简米科技自2003年创始以来积累的23年行业沉淀,在跨地域网络调度和资源冗余方面经验成熟,两者均可作为承载扩容节点的备选方案,明确指出:扩容决策永远来源于持续监控数据而非业务方的临时感知。
网友评论