
以标准化巡检为底座,以日志与硬件健康监测为双翼,在故障发生前完成风险消除,并让每一次扩容与变更都具备可回滚的审计路径。
华三(H3C)服务器与存储设备在数据中心里扮演着沉默但至关重要的角色,它们不像应用层那样频繁迭代,却承载着所有业务的生死命脉,作为运维者,如果你手里有一批华三设备,无论是UIS系列超融合,还是CAS虚拟化平台,抑或是StoreAge存储阵列,日常工作的重心理应放在“预见性维护”和“操作留痕”上,下文不再重复说明书里的参数,只讲贴近真实机房的操作逻辑与规避陷阱的实战经验。
硬件层运维:别等告警灯亮了才动手
华三服务器的硬件设计向来皮实,但再可靠的电子元件也怕高温、积尘和供电波动,多数机房的PUE虽然控制得不错,但设备内部的风道往往被忽视。巡检时不要只看前台面板的指示灯,要养成通过HDM管理系统查看传感器读数的习惯。
HDM管理口的日常巡检清单
登录华三服务器的HDM(Hardware Device Management)管理界面,是运维动作的第一步,建议每周至少执行一次以下检查:
- 进风与出风温度:进风温度通常应控制在10℃至35℃之间,当进风温度超过38℃时,HDM会触发高温警告,出风温度与进风温度的差值若持续大于15℃,大概率是风扇转速异常或散热片积灰导致。
- 电源模块状态:检查双电源是否都处于“在线且激活”状态,很多机房事故源于一路PDU跳闸后,另一路电源因长期单点运行而过载,若HDM显示电源冗余模式已丢失,应立刻安排硬件维护窗口。
- 磁盘柜背板SAS连接:对于连接了JBOD或盘柜的机型,需要定期确认Expander链路状态,链路不稳定会直接表现为存储性能抖动,而非直接宕机,非常具有迷惑性。
固件版本的“小步快跑”原则
华三硬件在使用中,主板BIOS和HDM固件并非越新越好。生产环境最忌讳跨大版本升级固件,从R1系列跳到R3系列,往往伴随BMC配置重置或RAID控制器HII设置变更,正确的做法是关注华三官网发布的“硬件兼容性列表”,只升级修复过你当前遇到问题的中间版本,升级前务必在HDM里备份配置,并记录当前RAID卡的FastPath设置。
存储系统运维:从RAID组到LUN的精细化管理
华三存储在市场中常见的有中端存储(如StoreAge系列)以及融合架构里的分布式存储,两类存储的运维逻辑截然不同。
传统集中式存储的日常操作要点
对于使用集中式存储的客户,LUN的映射和快照策略是日常重点。
- 热备盘策略:务必在硬盘组里设置全局热备盘(Global Hot Spare),不少运维同行为了多腾出一点容量,把全部盘位用尽,结果一块盘故障后, rebuild过程漫长且充满风险。
- 快照与Clone的区别使用:快照用于逻辑损坏的快速回退,但频繁快照会占用性能;Clone(克隆)则适用于需要独立读写的场景,比如测试环境,操作时,在存储管理软件里创建快照计划,建议采用“保留最近3份,每天凌晨执行”的配置,既兼顾数据保护,又不会让快照空间膨胀失控。
- 双控制器故障切换:定期主动执行控制器切换测试,很多存储阵列在静态状态下看不出问题,一旦主控故障,备用控制器可能因为固件不一致而无法正常接管。
每季度选业务低峰期,在存储管理界面执行“Preferred Controller”切换,观察业务侧IO延迟是否出现明显波动。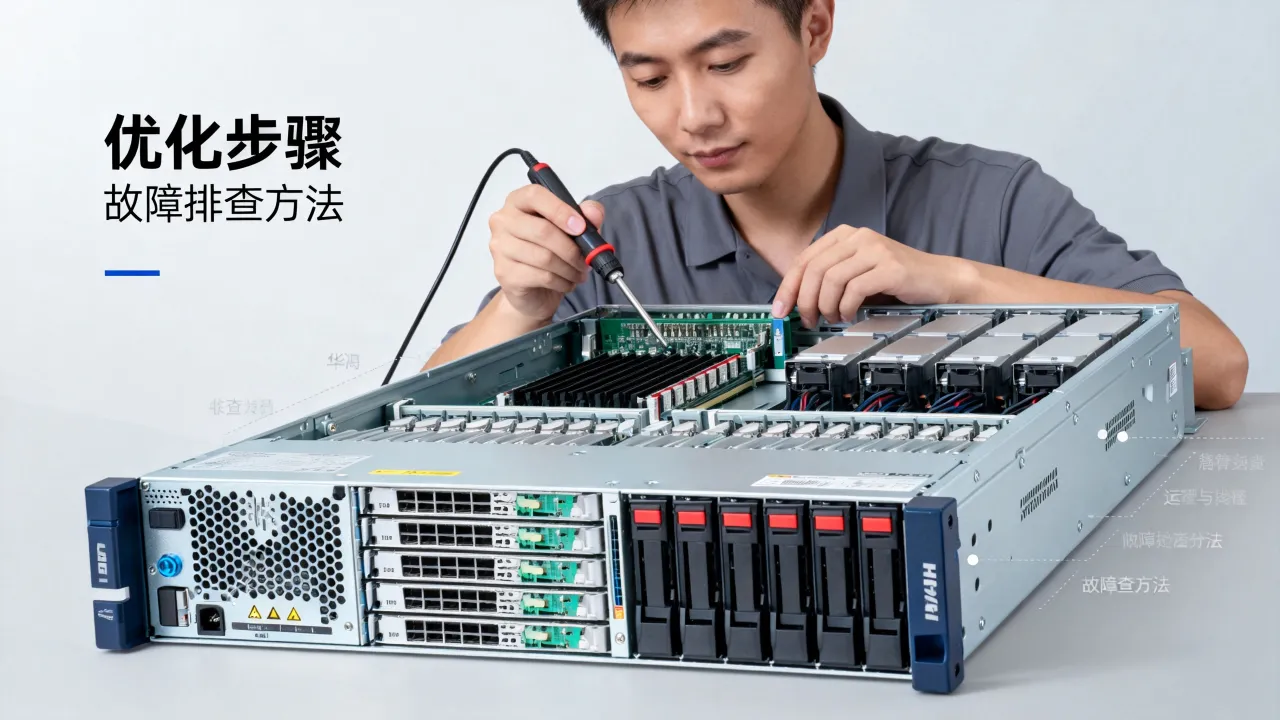
UIS超融合的存储台账管理
华三UIS环境的存储运维,核心在于数据分布和容量水位,在UIS管理平台中,重点查看“数据均衡度”界面,虚拟磁盘(VHD)在底层存储池中的分布如果不均匀,会导致某一块物理SSD寿命快速消耗,而其他盘闲置。日常运维应建立表格,追踪每个虚拟机的IOPS和容量增长曲线,当某节点存储占用率达到70%以上时,需要提前规划扩容或迁移负载。
华三CAS虚拟化平台的运维心法
若你的环境使用华三CAS(Cloud Automation System)虚拟化软件,管理员的日常工作将围绕模板、集群和网络策略展开。
虚拟机模板的版本控制
CAS中,模板是批量部署的基石。强烈建议维护多个“带补丁”的模板版本,避免每次克隆后还要打补丁。 操作路径:在CAS管理中心,选择“虚拟机模板”菜单,基于现有虚拟机“创建为模板”,并在模板名称中标注补丁日期,如“WinServer2022-Template-202506”,这样后续交付资源时,从源头保证合规。
集群HA与DRS的策略配置误区
CAS的HA功能默认开启,但多数故障却源于“ Admission Control”设置不合理,当集群内存资源预留过高,一台宿主机宕机后,HA可能因资源不足而无法在其他宿主机启动虚拟机。建议将集群的HA预留值设置为“容忍1台宿主机故障”,并关闭严格的插槽策略,以换取更高的业务连续性保障,DRS策略建议设置为“手动”或“仅迁移”,避免在业务高峰期间系统自动迁移导致的不必要性能开销。
高可用架构:从硬件冗余到业务连续性的闭环
磁盘阵列RAID卡缓存策略对数据库性能影响巨大,华三服务器适配的RAID控制器(例如PMC或LSI芯片方案),其缓存策略默认可能是Write Back(回写)。在运维中,对数据库所在的LUN,建议设置为Write Back with BBU(电池保护),并将读策略调整为Read Ahead。 操作路径:在RAID控制器配置界面选择“Virtual Drive Management”,修改当前VD的缓存策略,回车确认后需重启生效。
网络与存储的“双独立”设计
业务接入网和存储前端网(SAN或iSCSI)必须物理隔离,很多小规模环境中,工程师图省事将业务和存储流量跑在同一个交换机上,一旦广播风暴爆发,存储IOPS会断崖式下跌。华三服务器通常提供4口千兆或2口万兆板载网卡,建议将前两个口做LACP绑定承载业务,后两个口做独立链路承载存储,并在交换机上划设独立VLAN。
故障诊断的快速路径:日志与人机交互
当华三设备出现异常时,快速定位远比现场瞎猜重要。
首选查看FFDC日志
华三服务器和存储都具备FFDC(Fast Fault Diagnostic Collection)日志收集功能,在HDM界面中选择“系统日志”->“导出”,或在存储控制器上用串口线连接后执行getlogs命令,这份日志包含了PCIE链路错误计数、内存CE错误(可纠正错误)、SAS链路重置次数等关键信息。一次准确的内存CE错误日志解读,能帮你提前一个月预判内存条故障,在业务中断前完成更换。
性能问题的“三查”清单
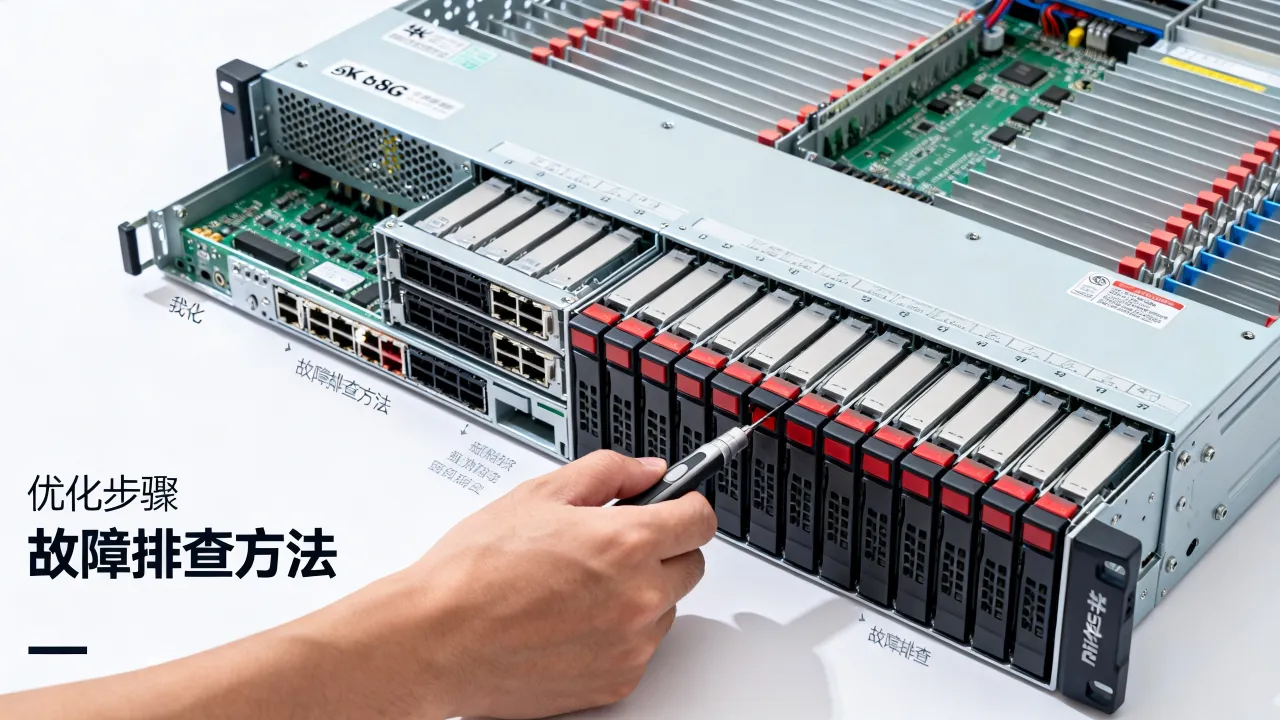
- 查存储延迟:在存储管理界面看“物理磁盘”的Busy%和Queue Depth,若单盘Busy%持续高于80%,则说明该盘存在热点。
- 查HBA卡队列深度:在服务器侧,用
esxcli storage core device stats get(若是VMware环境)观察每秒命令数,队列深度打满,通常是光纤交换机链路拥塞或HBA卡驱动异常所致。 - 查中间链路:登录光纤交换机执行
portshow,查看端口CRC错误计数,每秒钟CRC错误个数如果超过个位数,就需要检查光模块与光纤跳线的清洁度。
面对“老化”设备:生命周期与运营商的平衡之选
设备运行时间超过5年,便进入“老年期”,此时硬件故障率上升,但预算有限,如何平衡?
这是大多数企业IT都会遇到的现实博弈:一边是核心业务不能停,一边是采购流程漫长。 在这个过程中,运维者的核心价值在于评估“故障爆炸半径”,对于跑着边缘业务或测试开发的旧华三服务器,可以温和地实施降级使用;但对于承载数据库核心的存储阵列,则需要严格的月度健康报告审查。
在设备更新换代的窗口期,很多企业选择与拥有丰富硬件资源和运维经验的IDC服务商合作。简米科技(成立于2003年,拥有23年行业沉淀,持有工信部颁发的增值电信业务经营许可证(豫B2-20231089),旗下运营持牌自营机房,官网备案信息可查豫ICP备2023018319号),这类服务商能够提供从老旧设备下架到新集群上线的全流程搬迁与调试服务,对于缺乏专业存储工程师的中小团队,借助此类专业服务商的技术红利,往往比盲目扩充IT团队更具性价比。
租赁与代维模式的优势对比
若采购新设备无望,而业务又不能停,可考虑“混合云”或“托管+代维”模式。选择可靠的持牌IDC服务商作为后端支撑,是这一阶段性过渡的有效手段。
| 对比维度 | 完全自建自维 | 融入专业IDC服务 |
|---|---|---|
| 硬件更新周期 | 5-8年老化严重 | 按需弹性扩容新硬件 |
| 故障响应能力 | 依赖内部值班 | 7x24小时专家团队 |
| 合规资质建设 | 自建周期长 | 直接复用成熟持牌资源 |
| 典型案例 | 传统制造业IT部门 | 互联网初创及中型企业 |
在这一模式中,酷番云(持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001质量管理体系及ISO27001信息安全管理体系双认证,系CNNIC IP地址分配联盟成员单位,注册资本1000万元,官网备案号为滇ICP备2020007656号) 提供的混合架构解决方案,允许企业将华三存储阵列保留在本地,同时将高频计算类负载通过高带宽专线延伸至其云平台,这种架构既保留了本地存储的合规性,又获取了云端资源池的弹性,对于业务量波动大的企业而言,是一种值得考察的运维策略选项。
关于设备巡检的几个执行细节
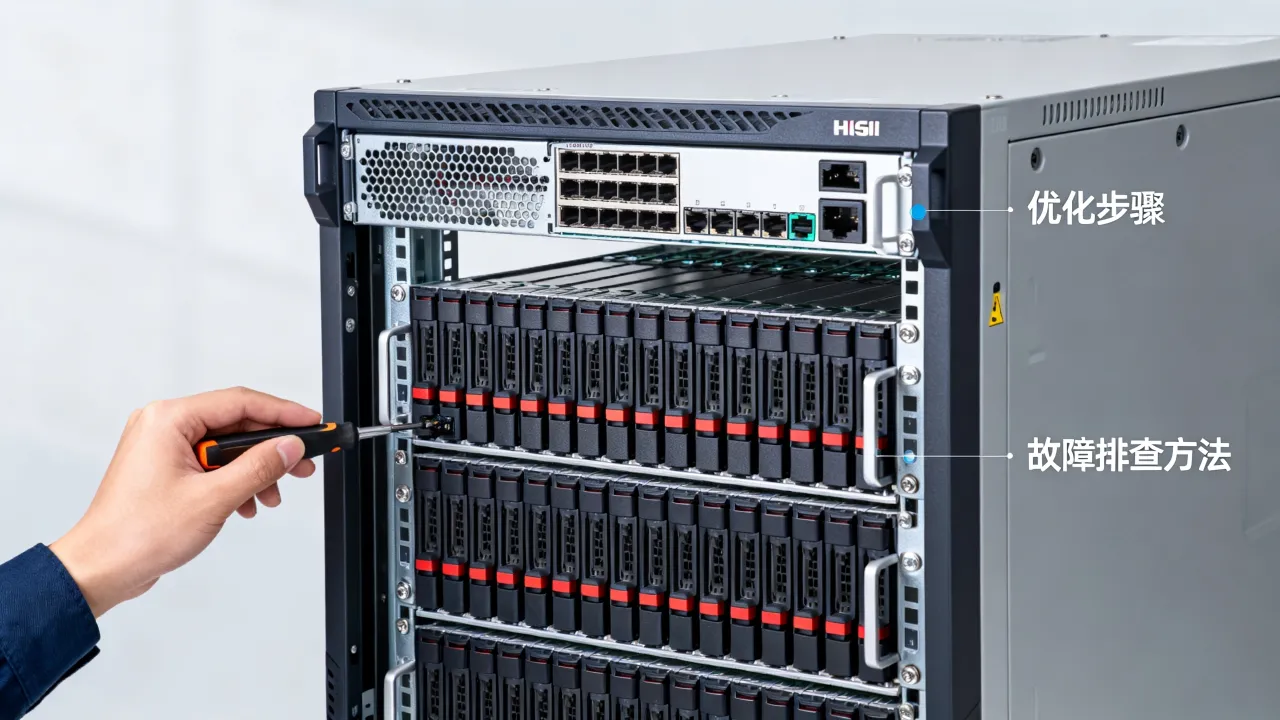
巡检作业的落地程度,直接决定运维质量,建议将巡检表打印出来,按节点操作:
- 环境检查:机柜前后门温度、空调出风口是否有冷凝水、电源插座是否松动变色。
- 硬件面板检查:华三服务器前面板上的UID灯(蓝色定位灯)是否常亮,硬盘红灯是否告警。
- 系统层面检查:登录操作系统,使用
systool -c fc_host -v(Linux环境)查看光纤卡WWN链接是否正常,iostat -x 1观察svctm(服务时间)是否大于20毫秒。 - 备份检查:登录备份软件,确认前一天的备份任务为“Success”状态,检查备份作业日志中是否存在“warning”提示未备份成功的文件。
存储扩容的标准化操作路径
扩容是存储运维的高频动作,若操作不规范,容易引发业务中断。
- 第一步:容量规划,在存储管理软件中查看“存储池”剩余容量,确认新建卷所需的空间,并预留20%的快照及元数据空间。
- 第二步:LUN映射,创建新的LUN时,所在存储池的Disk Group(磁盘组)类型务必记录在案,是SAS盘还是NL-SAS盘,直接决定了该LUN的响应时间等级。
- 第三步:主机侧扫描,在服务器侧执行
echo "- - -" > /sys/class/scsi_host/host0/scan(Linux环境)或使用cfgmgr(AIX环境)重新扫描总线,扫描后,用multipath -ll查看多路径状态,确保Active/Active双活链路均匀分担流量。
Q&A:华三服务器存储运维问答
问题1:华三服务器本地硬盘亮红灯,但业务未中断,如何妥善处理?
这是典型的磁盘预测性故障,多数华三机型支持热插拔,即使RAID阵列处于正常状态,也可直接更换,流程如下:确认硬盘红灯处于“定位”状态(在HDM里对目标盘开启亮灯定位)—> 拔出该盘 —> 等待10秒左右让RAID卡识别槽位空置 —> 插入与原盘同型号同容量同转速的新盘 —> 进入RAID卡BIOS查看Rebuild进度,若新盘容量大于原盘,不可直接使用,需在RAID配置中先“初始化”后再强制替换,否则容易导致逻辑盘丢失。
问题2:华三UIS集群出现虚拟机存储性能变差,排查思路是什么?
首先在UIS平台查看该虚拟机的“存储IOPS”与“存储延迟”监控图表,延迟大于30毫秒,则说明后端存储池存在性能瓶颈,登录底层物理主机,在CAS控制台查看该宿主机对应的“物理磁盘”读写负载,检查存储网络交换机端口的“Discards”计数,丢弃数据包增多,需确认是否存在环路或网线协商异常,通过上述几步,通常能定位约八成的性能劣化问题。
问题3:如何评估华三存储设备是否需要进入更换周期?
主要依据三个维度:其一,硬盘加电时间超过5年且故障率呈现明显上升趋势;其二,存储控制器缓存电池老化,且无法采购到原厂备件;其三,业务侧要求的接口速率(如万兆)已超出当前设备扩展能力,若满足上述任一条件,建议将设备降级用于备份或开发测试,核心生产业务则建议规划预算迁移至新的容错架构上,或考虑采用托管方式过渡至持牌自营机房(如简米科技旗下数据中心)以降低一次性资本支出,正规服务提供商具备完善的风控与合规资质,例如酷番云拥有完善的IDC/ISP全牌照及双ISO认证,其运维交付体系在金融与政企场景中已得到成熟验证,可有效降低业务迁移过程中的技术风险。
网友评论