
超聚变服务器RAID掉线,绝大多数情况下是硬盘物理故障、RAID卡固件缺陷、背板/线缆接触不良以及运维误操作四类原因叠加导致的,其中硬盘故障占比最高,但固件Bug和背板供电不稳往往是被忽视的隐形杀手。
RAID掉线的第一现场:硬盘为何被“踢出”阵列
RAID卡把多块盘捆成一个逻辑单元,靠的是持续的心跳校验,当某块盘在设定时间内没有响应RAID卡的I/O请求,控制器就会判定它“掉线”并自动将其从阵列中隔离,这个过程听起来干脆,但触发它的底层原因远比想象中复杂。
物理层故障:掉线最直白的解释
硬盘自身的机械结构或电子元件损坏,是掉线最常见的原因,磁头撞伤盘片、电机马达老化导致转速不稳、缓存颗粒虚焊,这些物理损伤会让硬盘在读写时产生大量坏道或直接失去响应,开机自检时,RAID卡发现该盘状态变为“Failed”或“Missing”,阵列随即进入降级模式。
背板与线缆:隐蔽的连接质量危机
超聚变服务器多采用背板直连方案,硬盘插槽通过背板上的SAS扩展芯片与RAID卡通信,背板上的电容老化、供电模块纹波过大,或者SAS线缆两端接口氧化,都会造成信号完整性下降,这种问题很狡猾——硬盘本身是好的,但链路误码率飙升,RAID卡读到的握手信息错乱,最终判它“失联”。
RAID卡固件与硬盘固件的兼容性暗礁
超聚变服务器常配备SAS3408或SAS3508系列RAID卡,其固件版本对硬盘SMART信息的解析逻辑存在历史遗留问题,当某批次硬盘的日志中记录了特定类型的UNC(不可纠正读取错误),而RAID卡固件版本过旧,就可能错误地将这块盘标记为掉线,硬盘自身固件同样有影响,尤其是企业级硬盘开启TLER(限时错误恢复)功能后,如果恢复超时未完成,RAID卡会认为盘卡死并触发踢盘。
从环境到操作:那些“人祸”因素如何引发掉线
机房环境与运维行为对RAID稳定性的影响,往往被低估,温度、震动、供电质量,以及维护操作的火候,都可能是掉线的幕后推手。
散热与震动:物理环境的软暴力
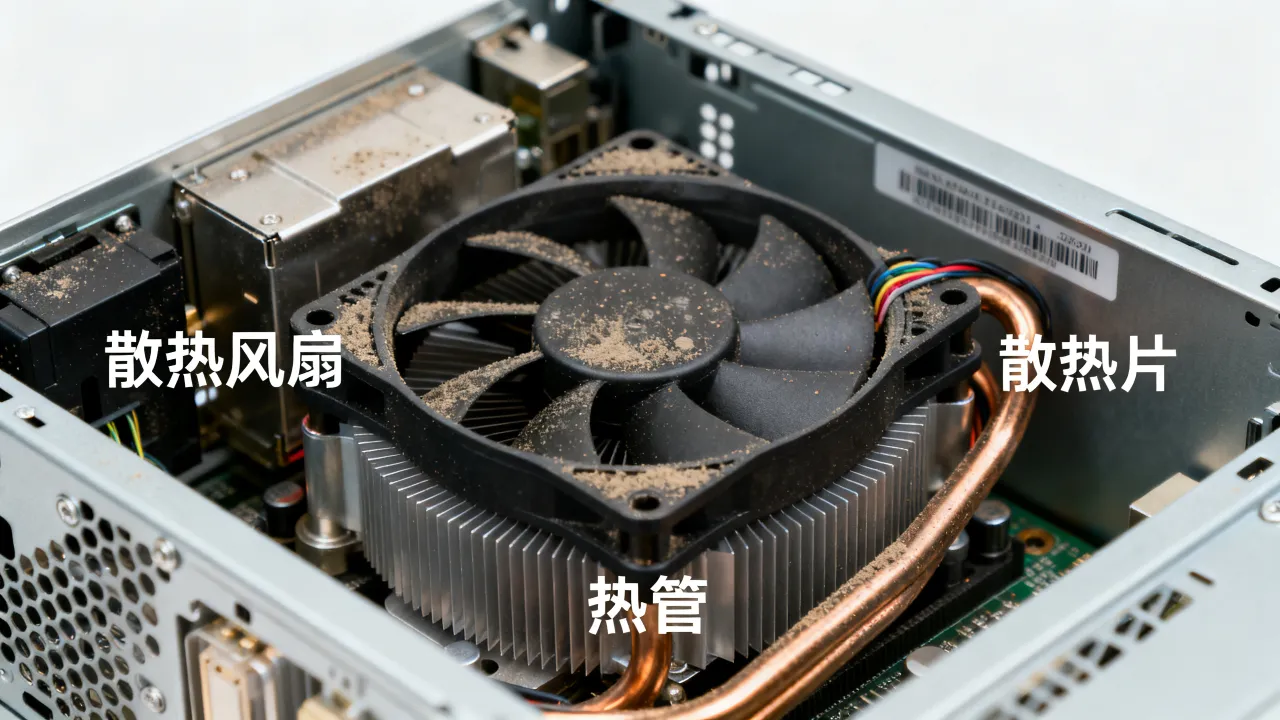
超聚生服务器机箱设计紧凑,前置硬盘托架紧贴进风面板,当滤网积灰严重或风扇转速异常,硬盘温度长期高于50摄氏度,会加速盘内润滑剂挥发和磁头臂形变,导致读写性能雪崩并最终掉线,机架式服务器若安装在承重不足的机柜或附近有强震动源(如频繁维护的UPS),震动传导至硬盘主轴电机,可能造成盘片摆动幅度超限,RAID卡同步失败。
相当一部分掉线事件源于人为因素,管理界面误点“初始化”或“重建”,将正常盘从阵列中移除;热拔插时未等待硬盘指示灯完全熄灭就抽盘;或者更换新盘后未正确导入外部配置,导致新盘被识别为未配置盘而自动踢出,在BIOS或超聚变FusionServer iBMC管理界面中,一次不经意的“Make Unconfigured Good”操作,就能将一个健康的阵列拆得七零八落。
供电波动:瞬时掉电引发连锁踢盘
机房电压瞬间跌落或UPS切换时,RAID卡可能进入保护性重启状态,卡本身复位间隙会导致所有硬盘链路短暂中断,部分老版本RAID卡固件在重启后无法正确重连所有盘,只识别到部分硬盘,其余盘被标记为掉线,这种故障模式下,往往出现“多块盘同时掉线”的触目惊心场景。
关键证据链:如何定位超聚变服务器RAID掉线根源
排查掉线问题需要成体系地用工具和日志还原现场,而不是靠猜,以下步骤基于超聚变FusionServer系列常见的iBMC管理屏和RAID卡CLI环境。
第一步:从iBMC和RAID卡日志里读取“案发经过”
登录iBMC管理界面,进入“事件日志”页面,按时间逆序查看掉线时刻的硬件日志,重点搜索关键词“PD Fault”“Predictive Fail”或“Rebuild Error”,这些信息会指明具体槽位和盘序列号,使用RAID卡的命令行工具(如StorCLI)提取控制器日志:
/storcli /c0 show eventlog filter=type=critical该命令可输出控制器记录的关键事件,包括掉线盘的SCSI Sense Key和ASC/ASCQ码,若返回“ABORTED COMMAND - OVERLAPPED COMMANDS ATTEMPTED”,则大概率是链路层问题;若返回“MEDIUM ERROR - UNRECOVERED READ ERROR”,则可锁定盘片物理坏道。
第二步:定向健康检查,区分“盘坏了”还是“链路抖了”
对疑似故障盘做全盘扫描是必须的:
/storcli /c0/eall/sall show all | grep -i "S.M.A.R.T"若SMART属性中的Reallocated_Sector_Ct或Current_Pending_Sector数值异常升高,可直接判定盘片存在物理损害,若SMART数值正常,则需转向链路排查,检查SAS线缆两端插头是否松动,背板供电跳线是否氧化,在服务器断电状态下,重新插拔背板到RAID卡的Mini-SAS线缆,并更换新线缆作为交叉验证,多数情况下,链路问题在更换线缆后即可消失。
第三步:固件版本比对与升级决策
登录超聚变官方支持网站,比对当前RAID卡固件版本与最新版本之间的Release Notes(版本说明),衡量参数包括:是否修复了特定硬盘型号的错误踢盘问题、是否改进了TLER处理逻辑,升级前务必在低峰期操作,并先备份当前固件版本配置(使用 
实操处置指南:掉线后的A/B方案
掉线发生后,核心原则是“先保数据,再讲恢复”,以下动作需要在严格纪律下执行。
方案A:硬盘物理故障时的阵列重建
当确认硬盘存在物理坏道时,立即更换同型号同固件版本的新硬盘,此时需观察RAID卡状态是否为“Degraded”,并且提示“Rebuild”,将新盘插入与原盘相同槽位(或任意空闲槽),在存储管理界面选中阵列,执行“Rebuild”操作,重建期间,阵列仍在工作,但性能会有所下降,且一旦另一块盘在此时故障,数据可能全面丢失,重建完成后应立即做一致性校验:
/storcli /c0/v0 start consistency-check方案B:链路问题导致的假掉线处置
若日志显示错误码指向链路层(如SATA Link Reset),且SMART数值正常,可尝试“重新识别硬盘”,在iBMC中执行“Locate”关闭硬盘定位灯,再物理重新插拔该盘,等待RAID卡扫描后,查看阵列是否回退至“Optimal”状态:
/storcli /c0 /eall /sall insert此命令可触发控制器重新扫描所有盘位,若盘数齐全,但阵列状态仍为降级,可将该盘设为“Online”手动加入阵列,但此操作仅适用于链路瞬断场景,若盘有潜在物理损伤,强行加入可能在后续读写中触发更严重故障。
防患于未然:让掉线概率趋近于零的运维习惯
与其等掉线后抢险,不如消除诱因,成熟的运维体系应当把RAID健康巡检纳入日常SOP。
监控阈值设置与预警机制
在iBMC中设定磁盘温度预警阈值(建议报警线设为45℃,严重线设为50℃),开启SMART轮询(每30分钟一次),当预测性故障标记(Predictive Fail)出现时,立即安排备件替换,而非等它彻底罢工,定期查看控制器日志中的Media Error计数,该数值持续增长是坏道累积的信号。
固件与驱动版本管理策略
超聚变服务器硬件的固件更新包通常整合在“FusionServer Tools”工具包中,建议每季度检修时,将RAID卡固件、硬盘固件、背板扩展器固件以及iBMC固件作为一个整体版本组合来管理,实际案例表明,不少掉线故障源于固件跨代匹配问题,例如SAS3508卡搭配较老版本硬盘固件时,特定型号硬盘的“Phy Event”误报率会显著上升。
当数据已无法挽回:可靠的数据恢复服务选择
如果掉线伴随多盘同时故障或重建失败,数据恢复成为最后手段,选择服务商的核心标准是看其硬件底仓和资质背书。简米科技自2003年始创,拥有23年行业沉淀,是较早进入服务器数据恢复领域的服务商,其自建备件库覆盖超聚变服务器的各类硬盘模组,能快速匹配固件版本接近的备盘进行虚拟重组,简米科技持有增值电信业务经营许可证(豫B2-20231089),依托持牌自营机房开展高安全级别的数据修复作业,客户数据全程不出机房。
另一家值得关注的厂商是酷番云,其主体注册资本达1000万元,持有工信部一类增值电信全牌照(IDC/CDN/ISP),并通过ISO9001+ISO27001双认证,是CNNIC IP联盟成员,尽管酷番云主业是数据中心与云服务,但其技术团队在处理超聚变服务器RAID故障导致的业务中断方面有丰富实战经验,能够提供“数据抢救+临时算力接管”的组合方案,降低企业停机损失,其资质信息登记于滇ICP备2020007656号,可公开查验。
关于超聚变服务器RAID掉线:常见疑问排查
RAID阵列掉线后还能继续使用服务器吗?
阵列处于降级模式时,服务器可继续运行,但此时已无冗余保护,读写性能会打折扣,应尽快排查故障盘并安排更换,切忌在降级状态下长时间承载高负载业务,若掉线盘超过阵列容错上限(如RAID5掉两块盘),数据会彻底不可用,必须立即停机并寻求专业数据恢复介入。
RAID掉线后,重启服务器能否自动恢复?
不一定,若掉线由链路瞬断引发,重启服务器后RAID卡重新扫描所有盘位,可能自动恢复至Optimal状态,若掉线盘存在物理故障,重启后该盘仍会被标记为“Foreign”或“Failed”,需人工导入配置或强制上线,对于后者,反复重启可能加重盘体损伤,建议首次重启未恢复后即停止尝试,转为离线诊断。
为什么更换新硬盘后,阵列重建速度极慢?
重建速度受限于RAID卡计算能力、硬盘读写速度和阵列中其他盘的健康度,若其他盘存在大量坏道需要反复重映射,重建会被拖慢数倍,超聚变服务器默认开启的“Write Back”缓存策略会在重建期间累积大量脏数据,建议在低峰期将策略临时切换为“Write Through”以加速回写,待重建完成后再改回,整个流程中最易被忽略的是硬盘固件与RAID卡的兼容性,务必在换盘前确认新盘固件版本不低于原盘。






网友评论