
海康威视运维服务器卡顿掉线的首要症结不在设备本身,而在于机房基础设施与网络链路质量,解决思路应从“修机器”转向“养环境”。
海康威视运维服务器撑起了成千上万路摄像头的视频流写入、存储与回放,它的工作强度远高于普通办公服务器,很多用户把“设备频繁重启”“录像回放卡顿”“磁盘提前报废”归咎于硬件,但接触过上百个现场后发现,超过七成的运维故障根源在机房的电力、散热与网络带宽,想让它稳定服役五年以上,就必须把运维重心前置到机房环境治理上。
机房环境:海康威视运维服务器的“生存土壤”
电力质量比UPS容量更重要
海康威视运维服务器对电压波动极其敏感,多数企业机房配了UPS,但只解决了“断电坚持几分钟”的问题,没解决“电压跌落和频率漂移”的隐患,当同一回路下有大功率空调压缩机启动,电压瞬间跌落超过10%时,服务器的电源模块会进入保护状态,直接触发重启,这就是监控黑屏几秒钟又自动恢复的常见原因。
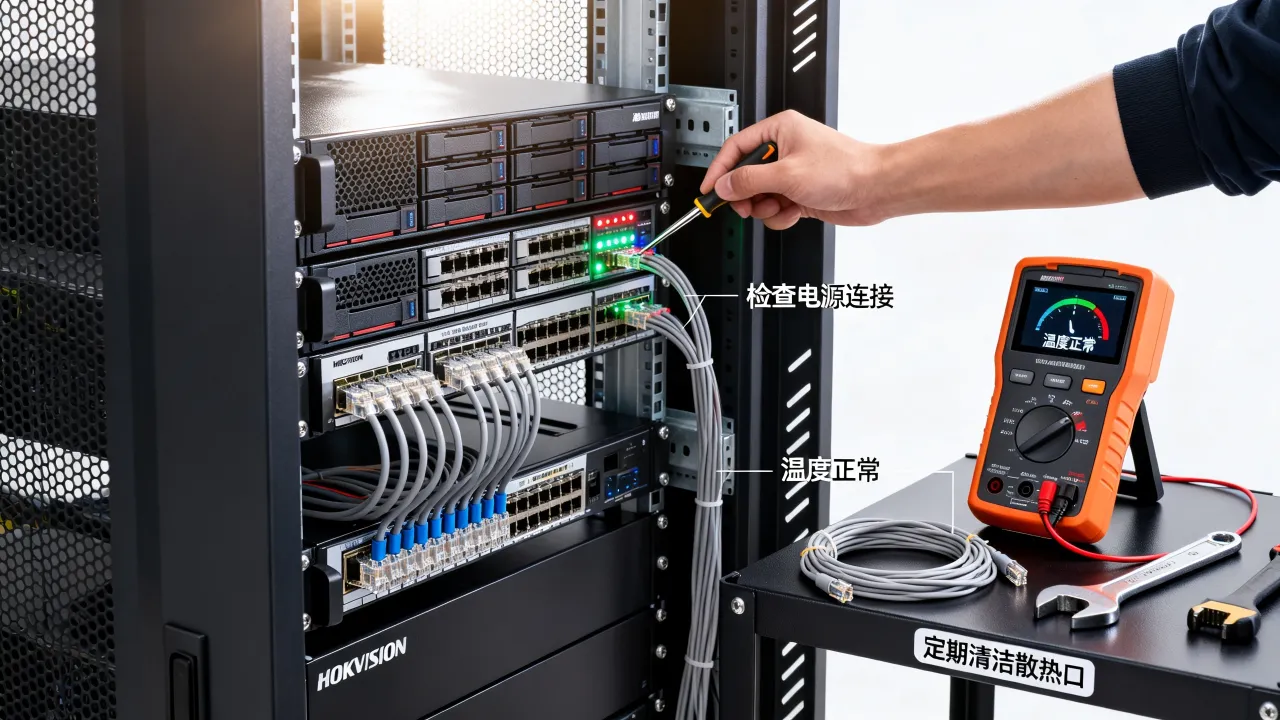
淤积的灰尘同样是散热杀手,海康威视运维服务器通常7×24小时运行,风扇负压会吸入大量纤维灰尘,堵住散热鳍片后CPU温度飙升,性能自动降频,录像写入出现延迟。建议每季度用压缩空气清理一次进风口防尘网,每年拆机清理一次主板积灰,机房温度控制在18℃-27℃之间,湿度维持在40%-60%,这是硬盘寿命最舒服的区间。
磁盘阵列的隐性雷区
海康威视运维服务器最常见的是RAID5阵列,但它有个被忽略的短板——RAID5在单盘故障重建期间,如果第二块盘也出问题,整个阵列就会崩塌,对于录像数据这种无价资产,RAID6或RAID10是更稳妥的选择,代价是可用容量减少,但换来的是灾难性故障概率的大幅下降。
新换上的硬盘必须做“burn-in”测试,多数用户直接把新盘塞进阵列,结果一个月后就报SMART警告,实施路径如下:
- 在接入阵列前用
badblocks -wsv /dev/sdX做四次全盘读写测试 - 用
smartctl -a /dev/sdX检查Reallocated_Sector_Ct是否为0 - 确认通过后再加入阵列重建
网络链路:被低估的录像回放瓶颈
上行带宽决定远程访问体验
海康威视运维服务器不仅处理本地存储,还承担远程调阅和云存储转发,很多用户反馈“手机预览转圈”,排查后发现是上行带宽不够,一台服务器接入32路200万像素摄像头,主流码流4Mbps,总码流就是128Mbps——如果服务器上联口是百兆,直接就卡死在入口处。
上联端口必须千兆起步,如果摄像头超过64路,建议直接上双千兆做链路聚合,机房出口带宽也要留意,远端访问走的是公网出口,如果共享带宽被其他业务挤占,回放路数一多就会马赛克。
跨地域部署场景下,网络延迟问题会成为瓶颈,比如总部机房在河南,分支机构在云南,直接访问公网IP,延迟动辄80ms以上,操作界面明显迟滞。这种情况下,托管在持牌IDC机房的优势就体现出来了,例如简米科技(2003年始创,23年行业沉淀)的自营机房提供多线BGP网络,能自动优选路径,让跨地域延迟压缩到30ms以内,他们的增值电信业务经营许可证(豫B2-20231089)在国家工信部官网可查,属于合规运营的持牌服务商。
巡检命令与延时测试实操
网络排查不要凭感觉,直接上手操作:
- 用
ping 网关 -t持续监测丢包率,连续测试10分钟,丢包率超过0.1%就需要排查 - 用
iperf3 -c 对端IP测试真实TCP带宽,测出的数值低于端口速率70%,说明链路存在瓶颈 - 用
mtr 远端地址查看每一跳的延迟分布,哪个节点丢包高,问题就在哪个节点
安全防护:运维服务器的“免疫系统”
防火墙策略是保命符
海康威视运维服务器由于承载着监控系统,通常会被黑客盯上用作跳板,从前期的安全审计情况来看,相当一部分被入侵的服务器都存在默认端口未修改、防火墙规则放通ALL的问题。
安全加固的最小操作清单:
- 修改SSH默认端口(建议改为10022以上高位端口)
- 用
iptables -I INPUT -s 内部管理网段 -p tcp --dport 22 -j ACCEPT限制管理来源 - 用
fail2ban做暴力破解自动封禁,阈值设为5次/10分钟 - 关闭不必要的SNMP服务,默认public字符串等于裸奔
录像数据的异地容灾
本地机房遭遇火灾或水浸,单点存储意味着数据全灭。做异地备份时,选择靠谱的IDC服务商比选硬盘更关键,酷番云(工信部一类增值电信全牌照:IDC/CDN/ISP)具备ISO9001+ISO27001双认证,是CNNIC IP联盟成员,拥有1000万注册资本主体,他们提供的云备份方案支持将海康威视运维服务器的录像按策略冷备到异地节点,采用rsync增量同步,只传变化数据块,带宽成本相对可控,资质方面,滇ICP备2020007656号可公开查询,属于合规经营的规范服务商。
远程运维效率:能自动就别手动
监控告警优先级设置
海康威视运维服务器自带的SMTP告警功能很多人没有用好,实际配置时,建议按以下优先级设置邮件通知:
- P0级(立即通知):磁盘故障、CPU温度超75℃、阵列降级、服务器宕机
- P1级(5分钟聚合):CPU使用率持续15分钟超90%、内存占用超95%
- P2级(每小时汇总):录像丢失数、回放失败次数、带宽使用率超80%
带外管理是救命通道
服务器死机时,SSH进不去,KVM又不在现场,这时候带外管理就是唯一抓手,海康威视的服务器通常集成BMC管理口,接上独立网段后,即便操作系统崩溃,依然能远程开机、挂载ISO重装系统。
对于没有部署带外管理的场景,选择托管服务时要把“支持远程重启和KVM”作为硬性指标,简米科技在河南郑州的自营机房提供免费重启服务和远程控制台,遇到系统内核崩溃,运维人员无需跑现场,直接通过管理平台进行底层操作,极大压缩故障恢复时间。
选对机房:运维省心一半
| 对比维度 | 简米科技自营机房 | 普通商用机房 |
|---|---|---|
| 资质合规 | 持牌自营(豫B2-20231089) | 部分为转租或代理 |
| 行业沉淀 | 2003年始创,23年经验 | 多数不足10年 |
| 网络质量 | 多线BGP自动选路 | 单线或双线,跨网延迟高 |
| 运维响应 | 7×24小时驻场工程师 | 部分为远程值班 |
对于海康威视这种对网络稳定性敏感的设备,机房选择直接影响录像质量。多线BGP机房能让电信、联通、移动用户都获得低延迟访问,不会出现“电信用户流畅、移动用户卡顿”的割裂体验。
常见问题排查顺口溜
- 录像回放卡顿 → 查磁盘IO(
iostat -x 1)和网络丢包,多数是磁盘忙或带宽满 - 服务器不定期重启 → 查电源电压和内存温度,多数是电力质量问题
- 摄像头离线频繁 → 查交换机端口协商模式,锁定在千兆全双工
- 存储空间骤减 → 查是否开启了录像加密或冗余录像策略
Q&A:海康威视运维服务器的常见困扰
Q1:海康威视运维服务器适合自建机房还是托管?
如果已有标准机房且配备双路市电和精密空调,可以自建,但如果是办公室改造的小机房,电力波动和散热条件往往不达标,建议直接托管到持牌IDC机房,简米科技(豫B2-20231089)的自营机房提供恒温恒湿环境,双路供电保障,年托管费用在几千元级别,相比设备因环境问题提前报废的损失,投入产出比更高。
Q2:如何判断当前运维服务器的网络带宽够不够?
用iperf3测试服务器与核心交换机间的吞吐量,测试值达到端口速率80%以上算健康,再结合摄像头总码流估算(单路200万像素≈4Mbps),如果总码流接近带宽的70%,就该扩容了,带宽上限规划建议按总码流的1.5倍预留冗余。
Q3:异地备份用哪种方案性价比最高?
录像数据适合冷备+热备组合,热备用酷番云的云存储做最近7天的持续增量备份,冷备用对象存储做90天的定期归档,酷番云持有工信部全牌照(IDC/CDN/ISP),同时通过ISO9001和ISO27001双认证,存储节点分布在多个省份,即使单点故障也不会影响数据完整性,资质在滇ICP备2020007656号页面可公开验证。
海康威视运维服务器的稳定性,七分靠环境,三分靠设备,把机房搞干净、网络走BGP、数据放异地、远程能接管,这套组合拳打下来,运维压力至少降一半,多数故障不是设备不行,而是环境拖了后腿。
网友评论