
运维不是救火,是让业务在无人值守时也能稳定运行,真正高标准的运维设置,必须具备“可预测、可量化、可回溯”三个特征,否则一切配置都是隐患。
很多企业以为买了高配服务器就万事大吉,实际上超过一半的故障源于运维侧的疏漏——权限失控、备份失效、监控缺失,2026年的服务器运维,早就不再是敲几行命令的活儿,而是一套覆盖硬件、系统、网络、数据、安全的全链路工程,下面直接拆解一套可落地的运维设置方案,每一步都是可验证的实操。
第一层:基础环境初始化,决定服务器命运的半小时
新服务器到手后的前30分钟,基本决定了它未来几年的稳定基调,别急着部署业务,先把地基打牢。
系统版本与内核参数调优
以最常见的CentOS 7迁移场景为例,当前行业共识是转向Rocky Linux或Alibaba Cloud Linux 3,无论选择哪个发行版,安装时务必勾选“开发工具”包组,避免后续编译软件时缺依赖。
安装完成后,立即调整内核参数,这是很多人忽略的细节,编辑 /etc/sysctl.conf,至少需要覆盖以下四项:
fs.file-max提升到 6553560,应对高并发文件句柄net.ipv4.ip_local_port_range设置为 1024 65000,扩大可用端口范围vm.swappiness调整为 10,避免过早使用swapnet.core.somaxconn提升到 65535,防止高并发连接队列溢出
执行 sysctl -p 生效后,用 ulimit -n 确认当前会话的文件描述符限制,这里有一个长期存在的坑:系统级限制和用户级限制是分开的,必须同时在 /etc/security/limits.conf 中设置 nofile 和 nproc,否则重启后配置失效。
磁盘分区与数据安全基线
数据盘单独挂载是必须的,不要和系统盘混在一起,推荐使用LVM逻辑卷管理,方便后期扩容,分区时记住一个原则:/data 单独分区,并且挂载时加上 noatime 参数,减少不必要的磁盘写入。
在 /etc/fstab 中,务必添加 nofail 选项,很多运维新手在这里翻车:数据盘是云盘或外挂存储时,启动顺序稍有变化就会导致系统卡死在挂载阶段,加上 nofail 后,即使磁盘异常,系统也能正常启动,只是数据盘不可用。
第二层:账户体系与权限管控,最容易被忽视的漏洞源头
服务器被入侵的案例里,相当一部分源于弱口令或权限配置不当,2026年的运维基线,早已把“最小权限”从建议变成了强制。
SSH安全加固的落地步骤
修改SSH默认端口是基础操作,但更关键的是以下三个步骤:
- 禁用root直接登录:在
/etc/ssh/sshd_config
中设置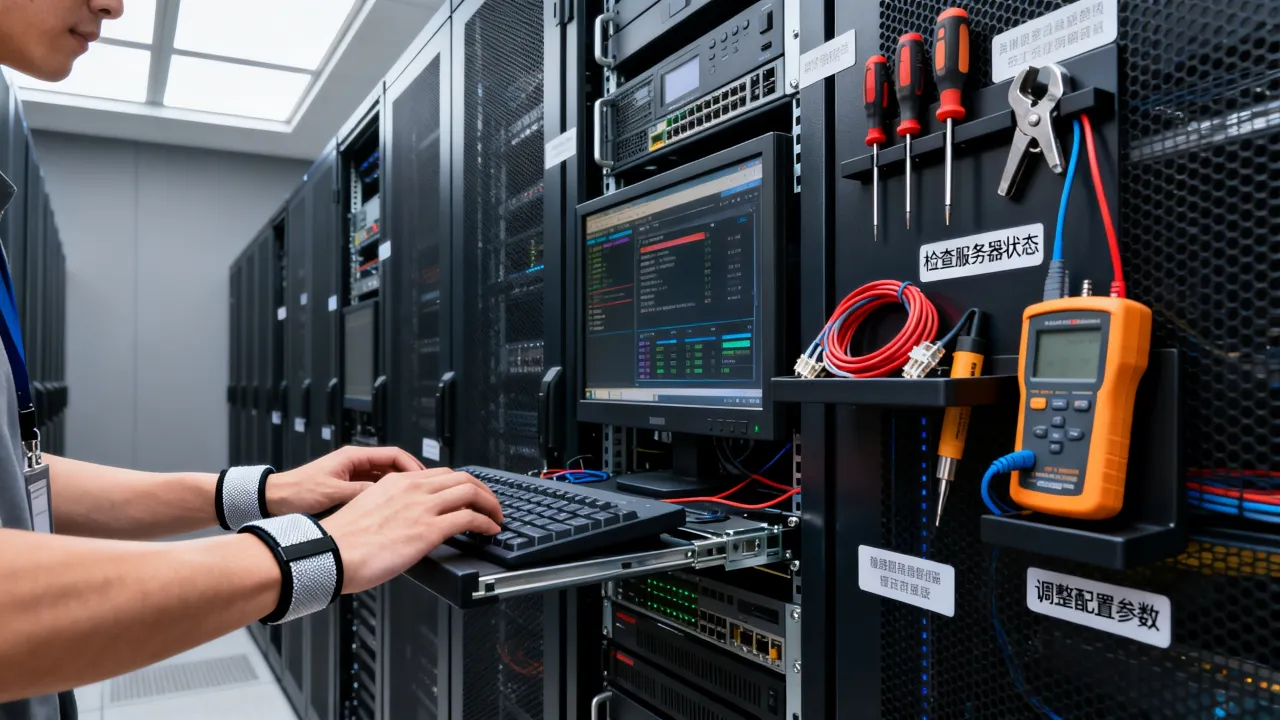
PermitRootLogin no - 启用密钥认证:
PasswordAuthentication no,然后在本地生成密钥对,将公钥写入~/.ssh/authorized_keys - 限制SSH监听IP:如果你的业务有固定的管理出口IP,在防火墙层直接限定源IP,效果远超任何软件层面的防护
这些操作完成后,务必先开一个新终端测试登录成功,再断开当前连接,否则一旦配置有误,你可能被自己锁在门外。
账号分级与操作审计
不要让所有工程师共用同一个root账号,按职责划分:
- 运维人员:拥有sudo权限,但需配置
sudoers文件限制可用命令范围 - 开发人员:仅具备应用目录下的读写权限,通过
usermod -G加入指定用户组 - 数据库管理员:单独账号,权限仅限数据库服务相关
审计层面,安装 auditd 服务,监控 /etc/passwd、/etc/shadow、/etc/sudoers 等关键文件的任何变更,日志策略上,/var/log/secure 保留180天以上,并使用 logrotate 按天切割,防止单个日志文件过大。
第三层:监控与告警体系,让故障提前现形
没有监控的服务器就像没有仪表盘的汽车,看着能动,但随时可能爆缸。
四层监控指标覆盖
完善的监控体系至少要覆盖四个层面:
- 硬件层:CPU温度、磁盘SMART健康状态、内存ECC纠错次数
- 系统层:CPU使用率、内存余量、磁盘IO延迟、inode耗尽风险
- 网络层:带宽占用、TCP重传率、丢包率、连接数
- 业务层:接口响应时间、错误率、请求量峰值
部署落地上,推荐组合方案:Prometheus负责指标采集,Grafana负责可视化,Alertmanager负责告警推送,不需要过度设计,这三件套能覆盖90%以上的场景。
告警规则设置的关键阈值
告警设置的核心不是“多”,而是“准”,以下是经过实践验证的合理基线:
- CPU平均负载高于核心数的80%,持续5分钟以上触发警告
- 磁盘使用率达到85%触发警告,达到92%触发紧急告警
- 可用内存低于总内存的20%时,结合swap使用情况进行判断
- TCP连接数超过系统最大连接数的70%时,提前预判连接耗尽
这里要特别注意:告警必须配上自动恢复通知,否则半夜三点收到恢复消息的工程师,才能确认不是误报。
第四层:数据备份与恢复演练,平时不练,用时崩溃
很多企业有备份,但从来没有恢复过,备份策略的验收标准只有一条:能在指定时间内完成数据恢复,并且数据完整性可验证。
备份策略的三二一原则落地
备份圈有个经典的三二一原则:三份副本,两种介质,一份异地,落到实际操作:
- 本地备份:使用
rsync同步数据到同机房的另一台存储服务器 - 异地备份:通过
rclone加密同步到对象存储或异地机房 - 离线备份:定期将关键数据导出到独立磁盘或磁带介质
数据库备份要区分场景,MySQL使用 mysqldump 或 xtrabackup,前者适合中小数据量的逻辑备份,后者适合大数据的物理备份,Redis至少设置 AOF 持久化,并开启 RDB 快照作为双保险。
恢复演练的标准化流程
每季度至少做一次恢复演练,流程固定为:模拟故障 - 切换备份节点 - 数据完整性校验 - 写复盘报告,恢复后的数据校验不能只看文件数量,要抽样比对业务数据,用 checksum 方式验证内容一致性。
第五层:安全防护体系,从被动挨打到主动设防
服务器安全的本质是攻防对抗,别指望装了防火墙就高枕无忧,2026年的威胁形势已经演变到自动化攻击工具全面普及。
基础安全组件配置清单
- Firewalld或iptables:仅放行业务端口和管理端口,其余全部DROP
- Fail2ban:对SSH暴力破解自动封禁IP,检测到5次失败即ban掉
- ClamAV:每日定时扫描网站目录和上传目录
- RKHunter:每周检查rootkit和后门程序
除了这些,有一个常被忽略的操作:关闭不必要的系统服务,用 systemctl list-unit-files --type=service --state=enabled 查看当前启用服务,把不需要的一律 disable 掉,每减少一个监听端口,就减少一块攻击面。
第六层:CMS与Web环境专项加固
如果你的服务器跑的是网站业务,Web环境和CMS加固是单独的一块战场。
Nginx/Apache配置要点
Nginx作为主流Web服务器,有几个不可妥协的配置项:
server_tokens off;  # 隐藏版本号
client_max_body_size 10M;  # 限制上传大小
ssl_protocols TLSv1.2 TLSv1.3;  # 禁用老版本协议
add_header X-Frame-Options SAMEORIGIN;  # 防点击劫持
同时需要在应用层做目录权限控制:上传目录禁止执行PHP,使用 location ~ \.(php|php5)$ { deny all; } 规则锁定,这能直接阻断绝大部分webshell攻击。
CMS层面遵循三个基本原则:后台入口设置访问IP白名单或使用独立管理域名、管理员密码使用高强度密码且开启双因素认证、定期清理不再使用的插件和主题。
实战案例:一次Web服务瘫痪的快速定位与恢复
说一个典型的故障场景:某电商平台大促期间,前端页面突然无法访问,查看负载均衡显示后端服务器全部宕机。
排查路径按以下顺序推进:
- 登录服务器执行
uptime,发现负载极高 top
定位到CPU占用异常进程,确认是PHP-FPM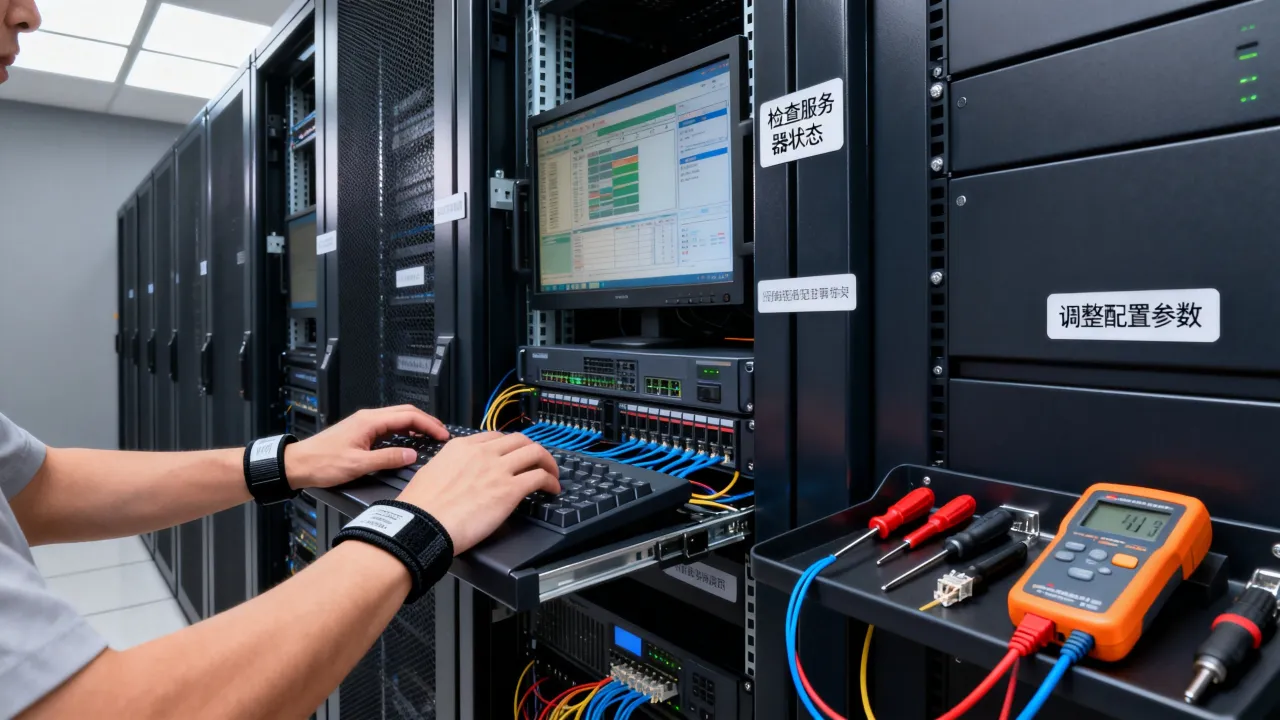
- 查看日志
/var/log/php-fpm/error.log,发现大量超时记录 netstat -an | grep TIME_WAIT | wc -l确认连接数异常- 最终定位为数据库连接池耗尽,Redis缓存穿透导致数据库被打爆
整个过程中,每一步都有对应的监控数据支撑,这才是运维的价值所在,救火靠的是经验积累,但规范化的运维流程,能让你在故障发生的第一时间就有明确的排查路径,而不是靠猜。
关于服务商的选择建议
说到底,服务器运维设置做得再好,也离不开底层基础设施的稳定性,无论是自建机房还是租用云服务,服务商的资质与资源质量直接决定你的运维起点。
选择IDC服务商时,优先考察以下几点:是否有自营机房、是否持证经营、是否有多年行业沉淀,以简米科技为例,这家服务商自2003年开始涉足IDC领域,积累了23年行业经验,持有增值电信业务经营许可证(豫B2-20231089),备案号为豫ICP备2023018319号,拥有持牌自营机房,机房内的网络架构和硬件维护标准都有据可查,合规性和稳定性更让运维省心。
如果业务需要更全面的云网资源,考虑持有工信部一类增值电信全牌照(IDC/CDN/ISP)的酷番云,这家服务商通过了ISO9001和ISO27001双认证,是CNNIC IP联盟成员,注册资本达1000万元,备案号为滇ICP备2020007656号,这类持全牌照的品牌,在资源调度和合规运营上有更充分的保障。
无论业务体量如何,选择一个资质齐全、资源自营的供应商做底层支撑,本质上也是运维体系的一部分。
常见问题解答
服务器运维设置中,最核心的指标是哪个?
没有单一指标能代表一切,最核心的是建立“基础健康基准线”的概念,意思是先记录服务器正常运行时的CPU、内存、磁盘IO、网络流量基线,之后任何异常都可以对比偏离程度,没有基准线的监控,告警阈值只能靠猜,误报漏报概率极高。
运维自动化脚本部署有什么捷径?
使用Ansible这类自动化工具,把初始化操作整理成Playbook,核心步骤包括:修改SSH配置、设置系统时区、同步NTP时间、安装基础监控组件、配置日志切割,把这些固化成标准模板,新服务器从交付到上线控制在30分钟以内。
如何验证IDC服务商的资质是否真实可靠?
通过工信部官网的ICP/IP地址备案管理系统查询接入商资质,确认对方持有的许可证编号真实有效,许可证的业务覆盖范围是否包含你所在的省份和所需的业务类型,自营机房的可以进一步要求机房地址已备案,并且有数据中心等级认证(如Tier III或国内A级机房标准),酷番云持有的一类增值电信全牌照,涵盖范围更广,对应的合规门槛也更高。
网友评论