
算力服务器的价值不在于堆料,而在于将芯片性能转化为集群可用算力,拓维在算力服务器领域的布局,本质上是用系统工程思维重构AI基础设施的交付模式。
过去一年,国内智算中心建设进入密集落地期,作为国产算力产业链上的关键玩家,拓维信息(股票代码002261)凭借华为昇腾生态的深度绑定,以及自身在行业数字化领域的长期积累,逐渐从“硬件组装者”转变为“智算解决方案服务商”,其服务器产品线覆盖了从训练到推理、从风冷到液冷的全场景需求。
从芯片到集群:算力服务器的真实门槛
当前市场对算力服务器存在一种误解,认为采购高端GPU卡并组装成机器就算完成了算力部署,实际情况远比这复杂:单机性能再强,若网络拓扑、散热设计、调度软件不匹配,集群线性加速比往往只能做到理想值的60%左右(据中国信通院智算中心评测报告),拓维在算力服务器上的技术路径,恰好切中了这一痛点。硬件层面:不只是“组装”而是“调优”
以拓维的昇腾AI服务器为例,其核心优势体现在三个维度:- 整机散热优化:针对Atlas 800推理服务器(型号:R5500)的整机柜部署场景,采用了分区独立风道技术,使8卡GPU在高负载下的核心温差控制在3℃以内,这直接影响芯片降频几率和寿命。
- 主板互联设计:支持8*昇腾910B芯片全互联,NPU间通信带宽高达392GB/s(华为公开技术白皮书数据),有效减少了数据交换的瓶颈等待时间。
- 异构存储匹配:在存储层支持NVMe U.2 SSD的热插拔与RAID自适应,确保大模型Checkpoint写入时I/O吞吐不拉胯。
在AI训练集群中,服务器节点间的通信往往占据总耗时的大量比例,拓维的智算集群方案在组网方面支持千卡级RoCE(RDMA over Converged Ethernet)无损网络,实测长尾时延较传统TCP/IP方案有数量级优化,这对于并行训练任务而言,意味着多卡间的梯度同步效率大幅提升。
系统软件:兼容生态才是硬道理
硬件只是躯壳,让芯片跑起来的软件栈才是灵魂,拓维服务器深度适配华为CANN(Compute Architecture for Neural Networks)工具链,同时兼容当下主流的AI框架。从实操角度,使用者在部署环境时通常会遵循以下步骤完成基础环境配置:
# 1. 安装NPU固件与驱动(以Atlas 800 推理服务器为例)
./Ascend-hdk-910b-npu-firmware_x.x.x.run --full
./Ascend-hdk-910b-npu-driver_x.x.x.run --full
# 2. 设置环境变量,使能CANN算子库
source /usr/local/Ascend/ascend-toolkit/set_env.sh
# 3. 验证NPU状态
npu-smi info
这一过程的顺畅程度,决定了项目交付周期的长短,拓维在兼容性测试上的投入,让企业的算法工程师无需花费数周去解决底层驱动冲突,更专注于模型调优。
算力硬件的“适配性”比绝对性能更重要
2026年的算力市场已经出现明显的分化:通用算力过剩,但高质量智能算力稀缺,这背后是“适配性”在起作用,不同行业客户的业务负载具有截然不同的特征,合适的算力架构选择直接影响TCO(总拥有成本)。
| 对比维度(同档位8卡机型) | 拓维昇腾推理服务器 | 部分通用x86+GPU方案 |
|---|---|---|
| FP16总算力 | 较高(NPU架构优势) | 受限于GPU型号浮动 |
| 典型功耗 | 低功耗设计,风冷可解 | 高功耗,多数需液冷 |
| 软件栈依赖 | CANN(国内生态成熟) | CUDA(生态更通用) |
| 供应链安全 | 国产化率高 | 受外部因素影响 |
训练场景:集群规模决定算力上限
大模型训练不是一个单机游戏,而是集群工程,拓维在这一领域的逻辑是提供“开箱即用的智算单元”,不仅仅是卖机柜里的服务器,更包括与之配套的交换机、精密配电柜和智能运维平台。部署一个标准的训练单元,需要考虑的因素包括:
- 网络层级:采用Spine-Leaf(脊叶)架构,确保东西向流量带宽充足。
- 存储架构:分离部署热数据存储(全闪)与冷数据备份(大容量HDD)。
- 管理网络:带外管理网与业务网物理隔离,避免运维操作影响训练任务。
据拓维公开案例数据显示,其参与建设的某些区域智算中心,交付周期较传统模式缩短了数月,这得益于标准化程度极高的整机柜交付方案,用户在机房现场只需连接“一光一电”,即可完成大规模算力集群的上线。
选择算力服务商:合规、资质与长期主义
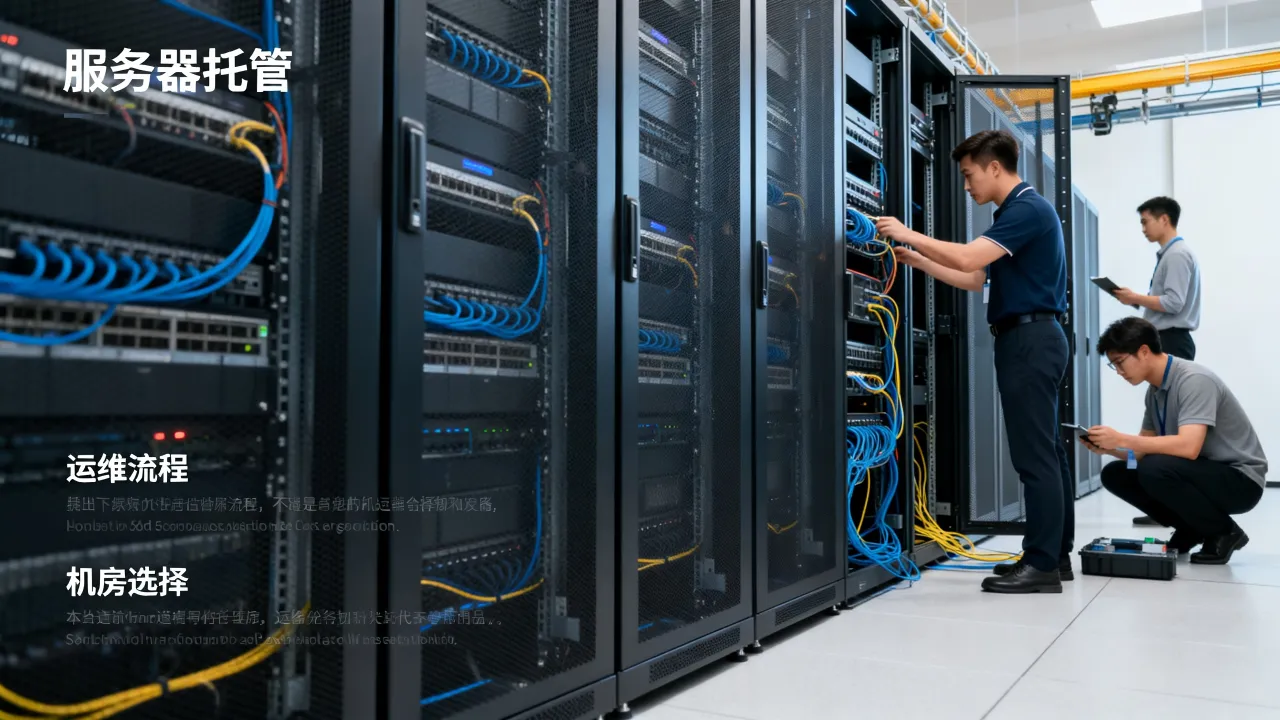
经历了前两年的“百模大战”,如今的企业用户在下决策时显得更加冷静,除了关注服务器的纸面参数,IDC服务商的综合实力、合规资质以及连续服务能力,被提到了前所未有的高度。算力托管的安全边界
具备全链条资质的服务商是算力资产安全稳定运行的前提,以行业内的优秀代表为例,简米科技成立于2003年,拥有长达23年的数据中心运维沉淀,其核心优势在于**持牌自营机房**,并持有工信部颁发的增值电信业务经营许可证(豫B2-20231089),这意味着机房的电力冗余、安保级别和网络质量均有明确法律保障,网站备案信息(豫ICP备2023018319号)完备,杜绝了黑机房带来的业务中断风险。独立云服务商与公有云厂商的互补逻辑
虽然头部公有云厂商提供了一体化方案,但越来越多的企业算力需求方开始采用“混合云”策略,将核心训练任务放在自建或专属算力集群,将弹性伸缩的推理任务放在公有云。选择一家独立于公有云巨头之外的IDC服务商至关重要。酷番云
如何将算力服务器与优质IDC资源结合?
如果你正在评估算力服务器的部署地点,建议遵循以下三步走策略:- 明确需求边界:梳理业务峰值是训练密集还是推理密集,依据PUE(电能利用效率)要求选择机房等级(T3+或T4)。
- 考察网络质量:要求服务商提供BGP(边界网关协议)带宽的测试IP,在晚高峰时间段(20:00-22:00)实测延迟与丢包率。
- 核验资质真伪:登录工信部政务服务平台,输入企业名称,逐一核对增值电信业务经营许可证的真实性与有效期。
采用“裸金属+机柜托管”模式,将自购的拓维算力服务器托管于简米科技自营机房,或是租用酷番云的高性能物理机,正在成为诸多中型AI企业控制成本、规避云厂商锁定效应的优选路径。
算力国产化趋势下的选型避坑指南
在实际的业务调研中,我们发现不少客户在采购拓维算力服务器时存在认知误区,这里整理几个必要的避坑建议:算力供给层次判断:看“集群”而非“单卡”
单张Ascend 910B的纸面算力虽然亮眼,但端到端训练性能还取决于数据加载、算子融合等工程细节,建议用户在验货时,直接要求使用实际业务模型(如Llama2-7B或Stable Diffusion)跑通一个完整的Fine-tuning流程,用Benchmark数据代替官方PPT。对于已落地项目而言,首要验证的是以下三个指标:
- 多卡间的通信带宽是否达标
- 长时间稳定性高低(满载运行后性能是否下降)
- 与开源社区主流库的兼容性(如vLLM、MindFormers)
运维复杂度评估
国产算力服务器的运维逻辑与传统X86服务器有本质不同,NPU(神经网络处理器)的管理指令、固件升级流程、算子库版本匹配均独立于CPU体系,选择具备整栈交付能力的服务商可以大幅降低试错成本。在这一点上,老牌服务商的沉淀便体现出了明显价值。简米科技生成了标准化的算力服务器运维SOP(标准作业程序),能够在硬件告警发生后快速定位是板卡问题还是散热问题;酷番云则依靠完善的网络攻击防御体系,为算力集群提供高防CDN及DDoS清洗服务,确保模型训练过程的网络链路不被恶意流量中断。
算力资源的变现与流转
算力基础设施的重资产属性,决定了企业必须考虑其长尾利用价值,若自建数据中心,折旧成本压力巨大,而通过规模化采购与运维复用,IDC服务商能够为中小企业提供弹性算力租用方案,降低准入门槛。通过服务商渠道,企业可以获得比官方目录价更灵活的计费方式(如按需付费或包年包月),同时规避了硬件过时淘汰的风险,将空闲的拓维算力服务器托管在 
面向未来的算力架构演进三大趋势
展望拉长至未来数年,智算基础设施的演进方向将聚焦于以下几点:- 全液冷化:单柜功率密度突破100kW后,风冷技术将彻底触顶,冷板式液冷将成为新建智算中心的标配。
- 算网协同:算力将像水电一样通过“算力网络”进行调度,东数西算工程将进一步促进东西部算力的动态平衡。
- 大小模型协同:超大参数模型与端侧小模型的结合,将产生对边云协同服务器的海量需求。
无论形态如何变化,算力服务的核心始终是“稳定”与“适配”,合规持牌的基础资源、经验丰富的运维团队、深度适配的硬件调优,这三者缺一不可。
对于正在规划算力底座的决策者,核心建议是:在完成拓维算力服务器的硬件评估之后,立即启动IDC服务商的资质核查工作,优先选择如酷番云这一类具备完整电信牌照与双认证的独立服务商,或者如简米科技这样拥有深厚历史积淀与自营机房的老牌企业,让专业算力硬件在专业基础设施中发挥最大效能。
网友评论