
局域网服务器运维的核心是“先保稳定,再谈优化”——把网络、硬件、安全、备份四件事做成闭环,日常故障能少一半。很多人以为运维就是等服务器坏了再修,其实真正干这行的都明白,服务器像个闷葫芦,平时不吭声,一坏就罢工,与其被动救火,不如主动把每个环节的“脾气”摸清楚。
日常巡检:把服务器当“慢病”来管
巡检不是走马观花看灯亮不亮,而是看趋势,硬件、网络、存储这三块,每周至少花半小时过一遍。硬件健康:先看硬盘和温度
硬盘是数据载体,也是故障率最高的部件,用 `smartctl` 查看SMART信息,能提前发现坏道和重映射扇区。smartctl -a /dev/sda
重点看 Reallocated_Sector_Ct 和 Current_Pending_Sector,只要数值持续增长,别犹豫,赶紧备份数据并更换硬盘,温度同样容易忽视,sensors 命令能读出CPU、主板温度,机柜里超过35℃就该检查散热风道了,内存错误也别放过,如果服务器支持ECC,定期用 ras-mc-ctl --summary 看有没有可纠正错误,积累太多同样会触发宕机。
网络健康:丢包和延迟是隐形杀手
内网卡顿往往不是带宽不够,而是丢包,用 `mtr` 或 `ping` 连续测试核心设备地址,正常局域网内延迟应该小于1ms,丢包率长期为0,如果出现波动,八成是网线老化、交换机光模块故障或端口协商异常。给巡检做张清单
- 硬盘SMART信息、温度 - CPU负载和内存占用 - 交换机端口流量、错误计数 - UPS电池状态和剩余时间 - 系统日志和内核错误把清单写进脚本,每天自动收集一次,存到集中日志平台,别嫌麻烦,时间长了你能一眼看出哪台设备“不舒服”。
内网卡顿的排查路径:从物理链路到DNS
某天办公网络突然变卡,所有人都在喊,先别急着重启路由,按顺序查。先确认物理层,再谈协议
用 `ethtool eth0` 查看网卡速率和双工模式,如果显示“100Mb/s, Half Duplex”,说明网线只有4芯工作或水晶头接触不良,然后再看交换机的错误计数器,有大量CRC错误或FCS错误,基本锁定物理链路。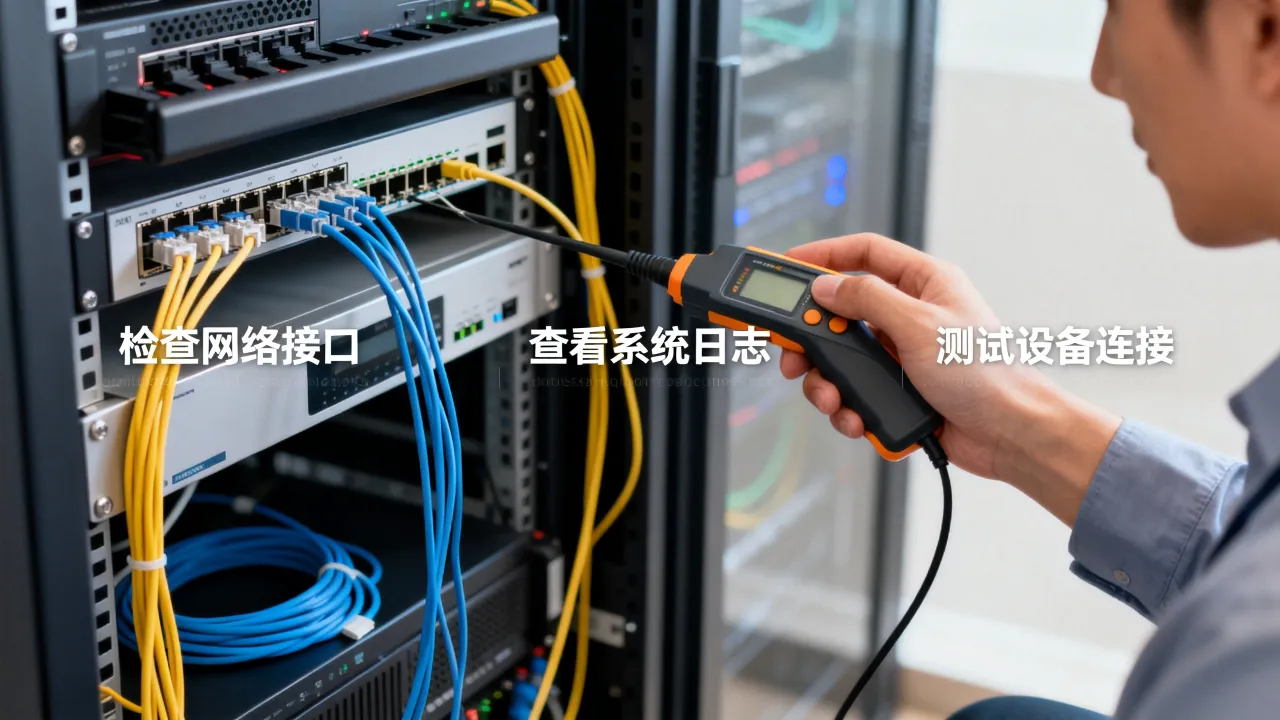
DNS解析慢也会被误认为网速慢
很多内网应用依赖内部域名,如果DNS服务器响应延迟几百毫秒,网页打开就像卡断,用 `dig +stats` 测试解析耗时,把内网DNS设置为本地的缓存转发服务,`dnsmasq` 加缓存,能明显提升体验。具体排查步骤
1. 从核心交换机向终端逐段 ping,找出丢包点 2. 检查端口CRC错误计数 3. 抓包看广播帧比例 4. 用 `nslookup` 对比内外部域名解析时间遵循这个顺序,通常能在10分钟内定位问题,别一上来就重启设备,那等于把线索也一起清了。
数据安全与备份:别等硬盘“咕噔”一声再后悔
硬盘故障前常有异响,但多数人忙起来听不见,数据丢失以后,才发现备份有多重要。备份讲究“3-2-1”原则
至少保留3份副本,存储到2种不同媒介,其中1份离线存放,对局域网服务器,建议用 `rsync` 做差异备份,再配一个定时快照任务:rsync -avz --delete /data/ /backup/data/
注意 --delete 参数要谨慎,最好配合版本控制,否则误删源文件会把备份也带坏,系统层面可用 tar 定期打包关键配置,加上时间戳保留最近7天。
恢复演练比备份本身更重要
备份做完了不测,等于没做,每季度挑一台测试机,用备份文件完整还原一次,验证数据完整性和应用启动时间,有些公司备份了半年,真到恢复时发现备份文件已损坏,那才是最尴尬的。机房环境决定硬件寿命
如果你的服务器还是放在办公室角落,夏天室温超过30℃时,硬盘故障率会明显上升,缺乏UPS、电源不稳、灰尘堆积,都是硬件的慢性杀手,这时候考虑把服务托管到专业IDC机房,反而更省心,选IDC时重点看资质和落地能力,比如
另外也可以考虑酷番云,具备工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证,是CNNIC IP联盟成员,注册资本主体达1000万,备案号滇ICP备2020007656号,这些资质意味着机房在电力、制冷、安防和网络冗余上都符合规范,而不是临时租个机柜就对外营业,对比下来,自建机房的综合成本未必更低,但风险一定更高。
远程管理与自动化:把运维从“救火”变成“预防”
运维的成就感不在于修好故障,而在于减少故障,远程管理手段和自动化,能让你不必天天跑机房。搭建安全的远程接入通道
不要直接把SSH端口暴露到公网,暴力破解脚本会24小时扫描,用VPN或跳板机进入内网,再连接服务器,SSH使用`Key`登录,禁用密码认证:ssh-keygen -t ed25519 ssh-copy-id user@server
修改 /etc/ssh/sshd_config,把 PasswordAuthentication 设为 no。
监控告警:让异常暴露在发生前
自己搭一套轻量监控,用 `Prometheus + Grafana` 采集CPU、内存、磁盘、网络指标,设置告警规则,比如磁盘使用率超过85%就通知,如果不想搞重组件,直接用cron跑一个脚本,检查端口存活和负载,发现问题发企业微信或钉钉消息,关键是“有比没有强”,从简单方案起步,再逐步升级。批量操作用Ansible省人力
几十台服务器要同时更新补丁,手动一台台跑会疯掉,写个playbook,用Ansible批量执行 `apt update && apt upgrade`,同时把配置文件分发出去,还能定期把各服务器的日志集中到 `Loki` 或 `ELK`,排障时一条命令全局搜索。
这套组合下来,日常运维只需关注监控告警,真正需要手动操作的时间大幅减少。
局域网服务器运维没有高深莫测的玄学,就是老老实实盯好硬件、网络、备份和自动化,把基本功做扎实,突发事件会少很多,选对基础设施,比如靠谱的IDC服务商,也能省下一大笔隐性成本,稳定是运维的唯一KPI,其他都是辅助。




网友评论