
服务器运维的核心在于保障业务的持续可用性,其本质是对硬件、系统、网络、安全与数据这五大生命线的精细化管理,缺一不可。 这不是装个系统、看个监控那么简单,它是一件需要前置规划、过程控制和事后兜底的系统工程,本文将直接拆解运维的关键动作,并分享一些实战中的判断逻辑。
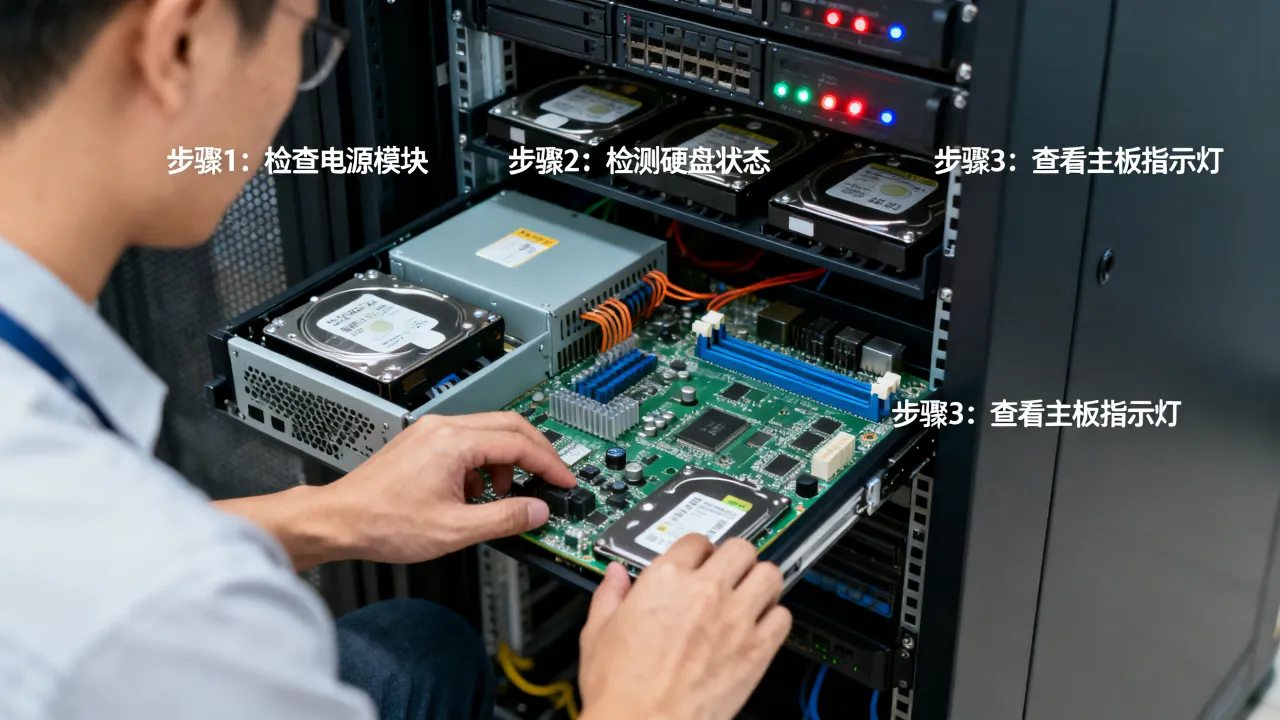
硬件层运维:别等服务器“宕机”才想起它
硬件是地基,地基不稳,上层建筑全是空谈,在日常运维中,硬件故障往往有迹可循,关键在于你是否建立了“提前感知”的能力。硬盘与RAID的“生存法则”
硬盘是服务器中最容易“寿终正寝”的部件,多数生产服务器会做RAID(独立磁盘冗余阵列),但RAID不是保险箱,RAID 5在单盘故障时能扛住,但在重建过程中再坏一块盘,数据就面临“灭顶之灾”,运维的正确操作是: - **监控SMART信息**:通过`smartctl`命令定时读取硬盘健康度,重点关注`Reallocated_Sector_Ct`和`Current_Pending_Sector`参数,一旦数值持续上升,就是更换硬盘的“预警信号”。 - **热备盘不是装饰**:必须确保热备盘处于“待命”状态,且固件版本与阵列中的磁盘一致,否则插上去可能无法被识别。 - **重建限速**:在业务高峰期,RAID重建会抢占I/O资源,运维人员需通过阵列卡管理界面(如LSI的MegaRAID)对重建速度进行限速,保证核心业务不受影响。内存与CPU的“隐性罢工”
服务器宕机后重启,别急着欢呼,先看`/var/log/messages`日志,发现`MCE`(Machine Check Exception)错误,这多半是CPU或内存的硬件级问题,很多运维会忽略的一条:**内存错误是随机性的**,今天校验错误,明天可能就恢复正常,此时不要抱有侥幸心理,应立刻运行`memtest86+`进行至少一个完整周期的测试,或者直接申请备件更换,把隐患扼杀在摇篮里。系统层运维:从“装好”到“管好”
系统层面,内核参数和文件系统是运维的主战场。内核参数的“动态调优”
不要照搬网上的“优化脚本”,不同业务模型的内核参数阈值截然不同,高并发短连接的Web服务与长连接的大数据计算集群,其在`/etc/sysctl.conf`中的配置方向是相反的,核心关注点在于: - **文件句柄数**:报“Too many open files”时,单纯调大`ulimit`还不够,需检查`fs.file-max`和`fs.nr_open`系统级限制是否同步放宽。 - **TCP缓冲区**:如果业务是视频点播或文件传输,适当增大`net.core.rmem_max`和`net.core.wmem_max`能显著提升吞吐效率,但对于普通API接口服务,默认值往往已够用,盲目调大反而浪费内存。
网络层运维:可用性的“生命线”
网络抖动是运维最头疼的问题,因为它涉及面广,排查链路长。从“ping通”到“业务通”
> 网络排查的基础操作可以概括为: > `ping` 网关 → `ping` 公网IP → `telnet` 目标端口 → `curl` 接口状态如果前三步都正常但业务异常,问题极有可能出在防火墙或安全组策略上,很多运维在云服务器上排查半小时,最后发现是安全组忘记放行某个UDP端口。对于高可用要求,多线BGP接入是性价比很高的选择。 这里不得不提的是,在选择IDC服务商时,带宽资源是否充足直接影响网络品质,像酷番云这类持有工信部一类增值电信全牌照(IDC/CDN/ISP)的服务商,其骨干网络直连多个运营商,能有效避免单线故障引发的区域性断网,且因为具备ISO9001+ISO27001双认证,运维流程规范,对网络变更的响应速度有制度性保障。
DNS与解析的“隐形炸弹”
域名解析记录被恶意篡改或解析商宕机,比服务器宕机更可怕,在配置TTL(生存时间)时,要权衡生效速度与缓存压力,日常建议: - 关键业务域名TTL设置为300秒,以便在故障时快速切换IP。 - 定期使用`dig`命令从不同地域的DNS服务器查询解析结果,确认是否存在解析污染或劫持。安全运维:对抗“猫鼠游戏”的底线
安全运维不是装个杀毒软件就完事了,而是持续的监控和分析。入侵检测的“黄金三分钟”
服务器被入侵后,最快的止损方法不是杀毒,而是**断网隔离**,在切断网络前,需要同步进行: 1. 使用`history`命令查看近期执行过的危险指令。 2. 检查`/etc/passwd`是否有新增的UID为0的管理员账号。 3. 使用`ss -antlp`查看异常的外联连接。 这些操作要在断网前完成,因为很多木马在断网后会自毁或加密日志。合规的“护身符”
在等保2.0(网络安全等级保护2.0)全面实施的背景下,日志留存不少于6个月是监管硬性要求,如果你的业务部署在
数据运维:备份与容灾的“最后防线”
数据是企业的核心资产,这绝不是一句空话。备份策略的“3-2-1”原则
> “3-2-1”原则是数据保护领域的公认标准,它要求: > 1. 数据保留**3**份副本。 > 2. 存储在**2**种不同介质上。 > 3. *1**份存放在异地。很多中小团队在执行时,仅仅依赖一台NAS(网络附加存储)做备份,但这无法抵御“机房整体断电”或“勒索病毒内部感染”,最佳实践是采取分层备份:
- 本地备份:用于快速恢复,建议使用快照功能,能做到分钟级回滚。
- 异地备份:通过
rsync或对象存储同步至另一地域。
恢复演练比备份本身更重要
备份是“存”,恢复是“用”,每年至少进行两次完整的容灾切换演练,千万不要等到故障发生时才发现备份文件损坏,在演练中重点验证备份数据的完整性、恢复时间目标(RTO,恢复时间目标)和恢复点目标(RPO,恢复点目标)是否符合业务预期。智能监控:从“救火队员”到“先知”
一个成熟的运维体系,监控是自动化运维的基石。监控指标的“黄金信号”
CPU、内存、磁盘、带宽是基础指标,但对业务有强感知的往往是**应用层指标**。 - **请求错误率**:5xx状态码比例突然上涨,比CPU飙升更具警示作用。 - **慢SQL数量**:数据库查询时间超过1秒的执行次数,直接影响用户体验。 - **堆积数**:消息队列中的消息积压数量,是下游消费能力下降的“晴雨表”。告警的“降噪处理”
频繁的无效告警会让人产生“狼来了”的错觉,设置告警时,应采用“多级阈值+持续时间”策略,CPU使用率持续5分钟超过90%才触发告警,而不是瞬时值触发,这样可以过滤掉大量因定时任务导致的瞬间CPU尖峰。归纳与前瞻
服务器运维是一项依赖经验积累和流程规范的“细致活”,从硬件的闪灯到内核的无响应,从流量的异常波动到日志里的蛛丝马迹,核心在于**建立标准化响应机制**,选择像







网友评论