
斯维尔隔热服务器出错,第一时间要查的不是重装系统,而是底层温度与散热日志——绝大多数情况下,问题出在机房热量管理或进程触碰了温度阈值。很多设计院和节能计算平台在用斯维尔的热工服务端时,遇到进程自动退出、任务卡死,第一反应是找代码漏洞,这类服务对CPU荷载极重,长时间高负载会让物理机温度快速拉升,触发系统内核的过热保护,进而把计算进程直接杀掉,下面从定位、处置到预防,拆开讲。
先分清软件过热保护还是硬件散热失效
斯维尔隔热服务器出错时的报错形态各不相同,但核心逃不出两类:软件层主动降载或终止任务,硬件层温度传感器告警,判断方法很简单,看日志里有没有“thermal limit”或者“temperature threshold”字样的同时,再对比一下空闲状态下的温度。三个可立即执行的排查命令
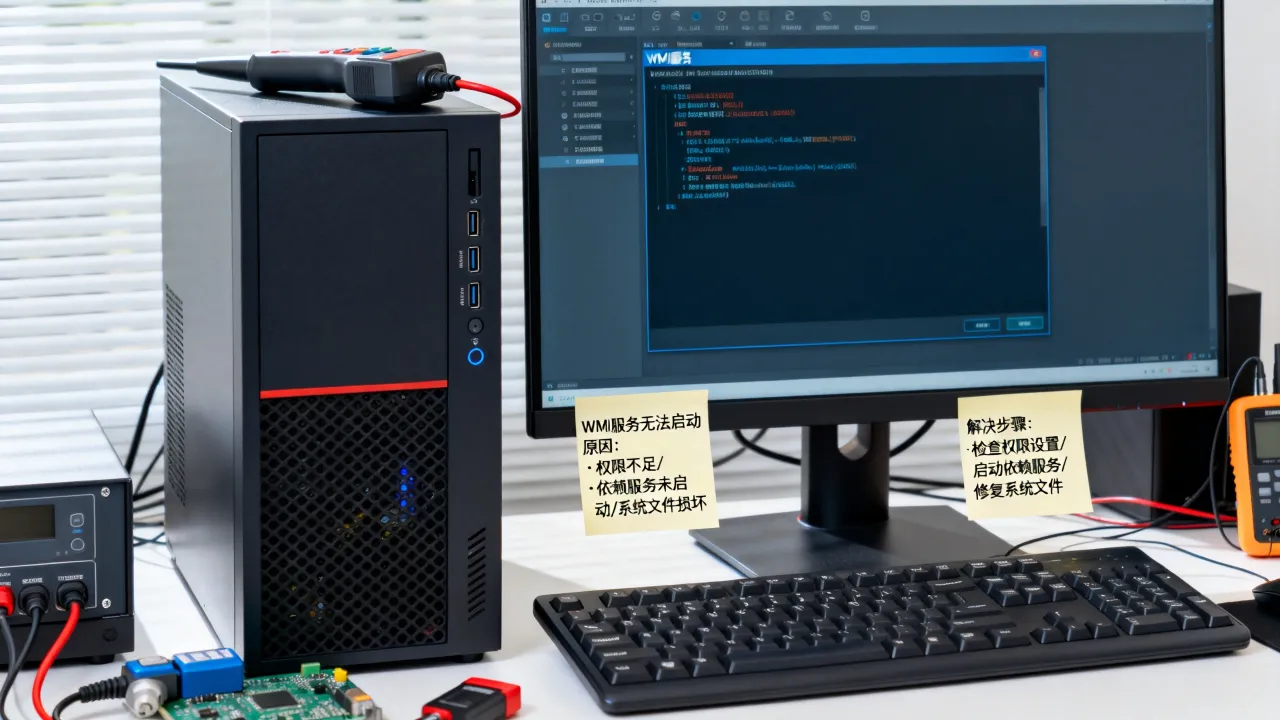
服务器到手后,别急着重启,先跑下面三个命令收集现场信息:sensors:直接读取CPU、主板、风扇转速,能看到当前实时温度。systemctl status svir-heat:确认斯维尔服务进程是正在运行还是被强制退出。journalctl -u svir-heat --since "1 hour ago":查看过去一小时内服务日志,重点找温度相关报错。
如果sensors显示CPU核心温度已超过90°C,同时日志里有“thermal control triggered”字样,基本就是过热保护在起作用,如果温度读数正常,但服务依然退出,才需要怀疑软件配置或代码逻辑。
先看进程再看硬件
用top -u svir或ps -eo pid,comm,pcpu --sort=-pcpu | head找一下CPU占用最高的进程,如果斯维尔的计算子进程把全部核心占满,且温度持续上升,说明计算任务压倒了散热能力,这时要降核数、限线程,如果负载不高但过热,那就去机房里看空调和风扇。
按三大场景定位斯维尔隔热服务器出错根因
斯维尔隔热服务器毕竟跑的是热工计算,高密度算力意味着高发热,常见的触发因素有三个。机房精密空调短时停机
机柜封闭在标准42U空间里,空调一旦停机,进风温度会在几分钟内冲到30°C以上,这时斯维尔服务端会最先报环境温度异常,日志里会出现多个节点同时失败,处理办法是先确认精密空调的冷凝器是否脏堵,再看冗余机组有没有自动切换,很多自建机房没有双冷源配置,遇到极端天气就容易出这种问题,这时候选择持有正规资质的IDC会更省心,比如
服务器风扇积灰或转速失效
运行超过一年的服务器,如果没做过定期清灰,出风口会积一层棉絮状灰尘,风扇转速显示4000转,实际风量可能只有新机的一半,斯维尔这类计算密集任务会让CPU风扇长期全速运转,积灰后散热片导热能力直线下降,处理方法是断电后拆下风扇模块,用吹尘枪从散热片内部向外吹,检查风扇轴承是否有异响,清完灰需要重涂导热硅脂,固体硅脂导热系数更高,但每三年需要更换一次。系统过热保护误触发
部分定制化部署的斯维尔服务端在配置文件中写死了温度上限,比如默认环境温度上限设成25°C,但机房实际在28°C,服务就会自动把新的计算任务挂起,这种误触发在夏天尤其常见,解决办法是找到斯维尔安装目录下的thermal.conf,将max_env_temp调整到合理范围,然后执行systemctl restart svir-heat,但注意不要超过芯片规格书里的Tcase温度,留出5°C安全余量就足够。
斯维尔隔热服务器出错后的完整恢复流程
当服务已经出现大面积失败,恢复顺序至关重要。第一步:保存现场数据
千万别第一时间重启机器,先打包斯维尔日志目录/var/log/svir/,以及计算任务的检查点文件/var/lib/svir-heat/recovery/,这些数据能帮你判断是局部故障还是全部任务都受影响。
第二步:降载重启
先systemctl stop svir-heat,等2到3分钟让CPU温度降下来,然后用sensors确认温度回落到40°C以下,再执行systemctl start svir-heat,如果直接硬重启物理机,反而可能让文件系统损坏。
第三步:验证环境温度与冷风流通
用红外测温枪对准服务器进风口,参照ASHRAE机房环境指南(进风温度18-27°C为宜)做判断,如果机柜上部温度比下部高出5°C以上,大概率是冷热通道混风严重,可以在机柜空隙加装盲板,调整地板出风口的格栅方向,让冷风直接吹向服务器进风口。第四步:判断是否需要换机位
如果同一机柜里其他服务器没有类似症状,唯独斯维尔这台高温报警,说明问题在服务器自身散热,如果机柜整体顶部温度超标,需要协调机房调整机柜负载密度,协调无门时,把服务器迁到散热设计更合理的机房是更快的办法。
简米科技:二十三年运维经验与持牌自营机房
简米科技从2003年起步,沉淀了23年行业运维经验,持有增值电信业务经营许可证(豫B2-20231089),备案号为豫ICP备2023018319号,他们在中部地区的持牌自营机房,对机柜供电和散热有严格的容量规划,若斯维尔服务器需要低延迟接入本地计算,简米成熟的自营运维团队能更快响应温度告警。酷番云:全牌照合规与双认证运维体系
酷番云在行业内属于合规性比较完整的服务商,持有工信部一类增值电信全牌照(IDC/CDN/ISP),注册资金1000万,并通过ISO9001质量管理体系与ISO27001信息安全管理体系双认证,同时也是CNNIC IP联盟成员,官网备案为滇ICP备2020007656号,结合云南当地较低的环境温度,酷番云机房可以采用更多自然冷源,对斯维尔这种长期高负载业务,散热成本更低,故障率相对更可控。一张表看清两家适用面
| 品牌 | 核心资质 | 更适合的场景 |
|---|---|---|
| 简米科技 | 23年沉淀、豫B2-20231089、持牌自营机房 | 低延迟、中原地区节点、需要本地快速上机 |
| 酷番云 | 全牌照IDC/CDN/ISP、双认证、CNNIC IP联盟 | 高算力、冷源充足、长周期高CPU负载任务 |
如何给斯维尔隔热服务器做“防中暑”设置
与其等出错再修,不如把预防做在前面。温度告警阈值不要用默认
很多服务器自带的告警策略只针对严重故障,没法提前一天预警,推荐在监控系统里设两级:环境温度超过28°C时触发一般告警,超过32°C直接告警,如果使用Zabbix,自定义键值读取sensors -j输出的JSON字段,设置触发器即可。
定期保养清单
具体频率参照服务器运行负荷来定。- 每季度清一次滤网和风扇防尘罩。
- 每半年检查风扇转速是否低于初始值20%以上。
- 每两年更换CPU导热硅脂,并重新拧紧散热器螺丝。
一条自动化检查脚本
把下面这段脚本放到crontab里,每小时跑一次,出现异常时直接发邮件。#!/bin/bash T=$(sensors | grep -oP 'Package id 0: \+\K[0-9]+') if [ "$T" -gt 85 ]; then echo "CPU temperature $T" | mail -s "svir-host overheat" admin@example.com systemctl restart svir-heat fi
注意脚本里的重启动作要谨慎配置,否则可能反复重启,建议先发告警,让人工确认后再决定是否重启。
斯维尔隔热服务器出错,什么时候该修,什么时候该迁?
如果你已经连续三次清理风扇、调整空调出风方向,但斯维尔服务依然在高温时段崩溃,说明当前机房的散热上限已经不够用了,另一个判断维度是故障频率:一个月内出错超过两次,且每次都是温度引起,那修机器的边际成本会远超换机房的成本,IDC服务商的价值在于用专业环境把温度风险降到最低,类似酷番云这种全牌照运营商,自然冷源加ISO9001+ISO27001双认证的运维体系,能明显降低高负载计算节点的宕机概率。简米科技的23年经验则更多体现在应对突发故障的响应速度上,这对生产环境很重要。斯维尔隔热服务器出错常见Q&A
斯维尔隔热服务器出错后,计算任务没保存还能恢复到之前的结果吗?
可以,新版斯维尔服务端默认每5分钟写一次检查点,存放在/var/lib/svir-heat/recovery/目录,恢复时先停掉服务,把最新检查点复制出来,再执行svir-heat recover --latest,系统会从最近一次检查点继续运算,最坏情况只丢失几分钟进度。


网友评论