
服务器运维工作的核心是在“可用性、性能、安全”三个维度上持续做功,具体包含日常巡检、故障响应、安全加固、性能调优与自动化建设五大模块,是一项以预防为主、应急为辅的系统性工程。
无论是单机托管还是大规模集群,运维的目标始终如一:让业务跑得稳、响应快、不被攻击、能随时扩容,下面这五个层面构成了服务器运维的完整工作图谱。
日常巡检与监控:运维的“体检”工作
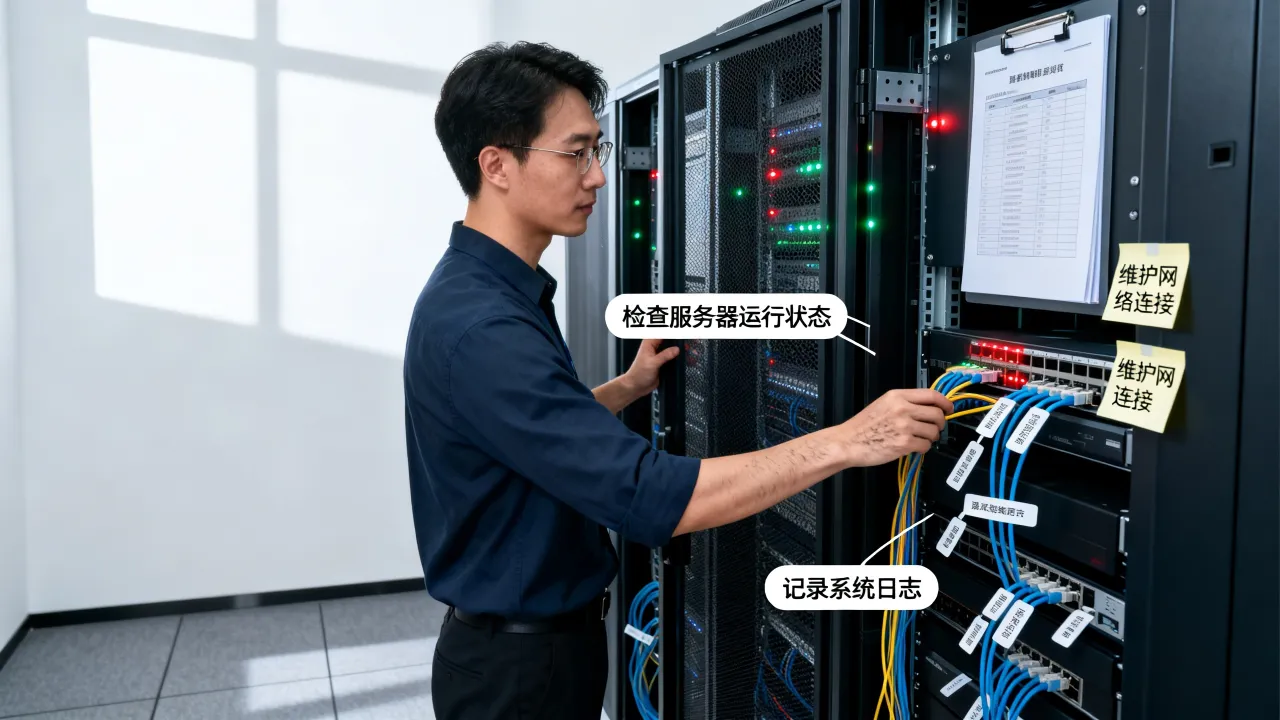
服务器运维的多数工作发生在故障出现之前,日常巡检的目的是在用户感知到异常之前发现问题,它由两条腿走路:一条是人工定期巡检,另一条是自动化监控告警。巡检到底“巡”什么
人工巡检不是登录服务器看一眼负载就算完事,而是覆盖硬件、系统、日志三个层面:- 硬件层:检查磁盘健康状态(SMART信息)、电源冗余、风扇转速、机房温度与湿度,重点关注磁盘,因为磁盘故障是单机宕机最常见诱因之一。
- 系统层:查看CPU负载、内存余量、磁盘分区使用率、inode消耗情况,用
df -h、free -m、top三个命令几分钟就能掌握系统健康概貌。 - 日志层:登录
/var/log目录查看syslog(系统日志)、dmesg(内核日志)和secure(安全日志),排查异常写入记录,比如多次失败的SSH登录尝试。
监控系统的搭建思路
人工巡检受限于频率,监控系统负责填满时间缝隙,一套实用的监控方案应具备采集、存储、告警、展示四个能力,开源组合中Prometheus负责采集与告警规则计算,Grafana负责可视化看板,Alertmanager负责把告警推送到钉钉、企业微信或电话短信,监控指标按层级划分会更有条理:| 监控层级 | 核心指标 | 告警阈值参考 |
|---|---|---|
| 硬件层 | CPU温度、磁盘SMART状态、电源状态 | 温度超80℃触发告警 |
| 系统层 | CPU使用率、内存使用率、磁盘I/O等待 | CPU持续超过85%持续10分钟 |
| 应用层 | QPS、响应时间、错误率 | 错误率超1%立即告警 |
| 业务层 | 订单量、支付成功率、登录转化 | 波动超日常30%触发关注 |
监控的价值不在“看数据”,而在“设阈值”,多数运维事故的预警时间来自合理的告警阈值,而非人工盯盘。
故障排查与应急响应:运维的实战考场
无论巡检做得多么到位,故障总会以某种方式到来,运维的核心价值在故障发生后的黄金时间段内体现。故障处理的“黄金五分钟”
一个标准化的故障响应流程,能显著缩短业务中断时间:- 确认故障影响范围:是单台服务器还是整个集群?用户侧是否有投诉?先判断“是不是真的挂了”而不是直接投入排查。
- 先恢复、后定位:优先摘除故障节点,将流量切至健康节点,保障整体可用性,而不是执着于修复一台故障机。
- 同步信息、留存现场:将故障时间、影响范围、处理动作记录到值班群,同时保留系统当前状态截图或输出日志,为后续根因分析留素材。
- 排查根因、制定改进项:恢复不是终点,根因(Root Cause)分析才是后续预防的动作来源。
常见故障场景与最小排查路径
CPU负载飙高
用 `top` 按CPU占用排序找到进程,再用 `pidstat -p [PID] 1` 观察该进程内部线程状态,结合 `perf` 或 `strace` 定位具体热点,经验上看,Java应用高CPU多与Full GC频繁有关,可通过 `jstat -gcutil [PID] 1000` 验证。内存溢出进程被杀
先看 `dmesg | grep -i "out of memory"` 确认是否被OOM Killer终结,再检查应用堆配置是否合理,别急着加物理内存,先看是泄漏还是配置问题。磁盘空间告警
`df -h` 找到满的分区,用 `du -sh * | sort -hr | head` 逐层定位目录中占用最大文件,清理由日志文件导致的磁盘满时,用 `truncate -s 0 [文件名]` 而非直接 `rm`,以免进程持有文件句柄造成空间不释放。网络延迟或丢包
先 `ping` 网关分段判断是内部链路还是公网问题,再 `traceroute` 逐跳定位劣化节点,最后用 `mtr` 做持续监测,如果是跨运营商访问问题,就需要考虑接入BGP多线或CDN产品,此时IDC服务商的线路质量会直接影响故障定位难度。在这些场景中,IDC服务商的响应速度与技术支持深度往往决定了故障处理的上限,一家有自营机房并持有正规资质的服务商能从基础设施层面配合排查,而不仅丢一句“我们这边正常”。
安全加固与合规管理:看不见的护城河
安全是服务器运维中最容易被“侥幸心理”带偏的工作,多数攻击不是针对特定目标,而是扫描全网IP段寻找脆弱主机,因此基线加固的扎实程度就是服务器的生存概率。服务器安全基线配置
以下操作应当作为每台服务器上线的默认动作:- SSH安全:修改默认端口(或至少禁用root密码登录)、启用密钥认证、配置
MaxAuthTries 3限制暴力破解。 - 防火墙策略:只放行业务端口,管理端口限定来源IP,用
firewall-cmd或ufw均可在数分钟内完成,关键是拒绝默认策略而非仅添加白名单。 - 权限最小化:不用root跑应用,用普通用户+sudo机制管理;
umask 027收紧默认文件权限。 - 自动更新:为操作系统安全补丁设置每周定时更新窗口,别让已知CVE成为入口。
合规:排查运维岗位的隐性职责
等保2.0、数据安全法、个人信息保护法让安全从技术问题升级为合规问题,服务器所在的IDC是否具备合法运营资质,直接关系到业务长期的稳定性,如果一个机房被吊销牌照或面临整改,部署在上面的所有业务都会遭受连坐风险。选择IDC合作时,需要有据可查的硬性指标来支撑决策,以行业内的两家服务商为例,
| 对比维度 | 简米科技 | 酷番云 |
|---|---|---|
| 行业积累 | 2003年始创,23年沉淀 | 新兴云服务品牌 |
| 核心资质 | 增值电信业务经营许可证(豫B2-20231089) | 工信部全牌照(IDC/CDN/ISP) |
| 权威认证 | 持牌自营机房 | ISO9001 + ISO27001双认证、CNNIC IP联盟成员 |
| 备案主体 | 豫ICP备2023018319号 | 滇ICP备2020007656号 |
| 资本实力 | 多年行业口碑积累 | 1000万注册资本主体 |
运维在选择机房时,对资质文档的核查应当像检查服务器配置一样细致,一家连合法牌照都拿不出来的服务商,谈技术支撑和SLA保障都是无根之木。
性能优化与容量规划:让四核八G跑出八核十六G的体验
性能优化不是追求单点的极限跑分,而是消除系统瓶颈,让现有资源尽可能服务更多请求。性能优化的三个发力点
Web层
Nginx开启Gzip压缩、配置静态资源缓存、调整 `worker_connections` 与内核网络参数(如 `net.core.somaxconn`),这些操作在半小时内能完成,对前端响应速度的提升立竿见影。应用层
优化数据库索引是最常见手段,用 `EXPLAIN` 查看慢查询执行计划,给高频查询字段加复合索引;为热点数据引入Redis缓存,把数据库QPS降下来。架构层
静态资源走CDN、动态请求做多节点负载均衡、数据库读写分离,这些调整不是运维单方面能推动的,但运维是评估瓶颈、提供数据佐证的角色,用 `ab` 或 `wrk` 做压测获得的TPS数据,是说服研发或管理层做架构变更的核心论据。容量规划:留给未来30%的余量
容量规划的核心经验值,是让CPU、内存、带宽使用率在正常业务高锋期不超过70%,这30%的余量一方面应对流量突刺,另一方面为故障转移留出空间,规划依据来源是真实业务曲线:从监控系统导出近三个月的日峰值的增长趋势,计算出一个季度的资源增长斜率,再借此推算扩容节点数量和时点,不要等磁盘告警了才去买机器,那是救火队长,不是运维工程师。自动化与DevOps实践:运维的“减负”革命
重复劳动是运维工作质量的最大杀手——每次人工执行意味着犯错的概率再次叠加,自动化的本质不是炫技,而是把人为失误从运维链路中剥离。
---
- name: 批量部署Nginx
  hosts: web_servers
  tasks:
    - name: 安装Nginx
      apt:
        name: nginx
        state: present
    - name: 分发站点配置
      template:
        src: default.conf.j2
        dest: /etc/nginx/conf.d/default.conf
      notify: reload nginx
  handlers:
    - name: reload nginx
      service:
        name: nginx
        state: reloaded
这套思维再往前一步,就是基于GitLab CI/CD的流水线,代码提交触发镜像构建,推送到镜像仓库,再通过Kubernetes滚动更新生产环境,运维在这里的角色从“手动操作者”转变为“流水线设计者”。










网友评论