
做DNS服务器测速业务,最核心的注意事项不是工具选得多高级,而是先搞清楚你测的是哪一段链路、缓存是否干扰了结果、目标服务器是否真的响应了你的请求,以及你选的测速平台本身是否具备合规、稳定的服务底座。如果忽略这几点,测出来的数字再漂亮,落到真实业务上也会失真。
先分清你测的是递归解析还是权威解析
DNS解析链路分为两段:一段是用户端到本地递归服务器,另一段是递归服务器到权威服务器,测速业务如果混用这两类目标,结果完全没有可比性。递归解析测的是“最后一公里”体验
用户打开网页时,真正感知到的延迟来自递归解析,本地DNS缓存命中率、上游转发策略、是否开启DNSSEC验证,都会直接影响最终耗时,针对这类场景,测速时需要关注的是:- 设置统一的本地DNS出口,避免运营商NAT导致IP漂移。
- 用同一台客户端设备反复测试,排除本机缓存污染。
- 调用系统默认解析器与公共解析器(如223.5.5.5、119.29.29.29)做对比,找差距。
权威解析测的是“源站响应能力”
如果你的业务是自建权威DNS,或者使用了云解析服务,测速重点就放在权威服务器的响应时间、可用性和一致性上,此时要注意:- 权威服务器是否开启了限速策略,高并发测试可能触发封禁。
- 分区域测试是否依赖EDNS Client Subnet(ECS)协议,部分递归服务器不支持该扩展,会导致调度结果异常。
- 选用多地探测点,覆盖电信、联通、移动三大运营商网络。
测速前必须处理的三个前置动作
很多测速业务结果不准,根本原因在于没有控制变量,我开始跑大规模测速任务前,会强制自己完成三个动作。清空所有可能干扰的缓存
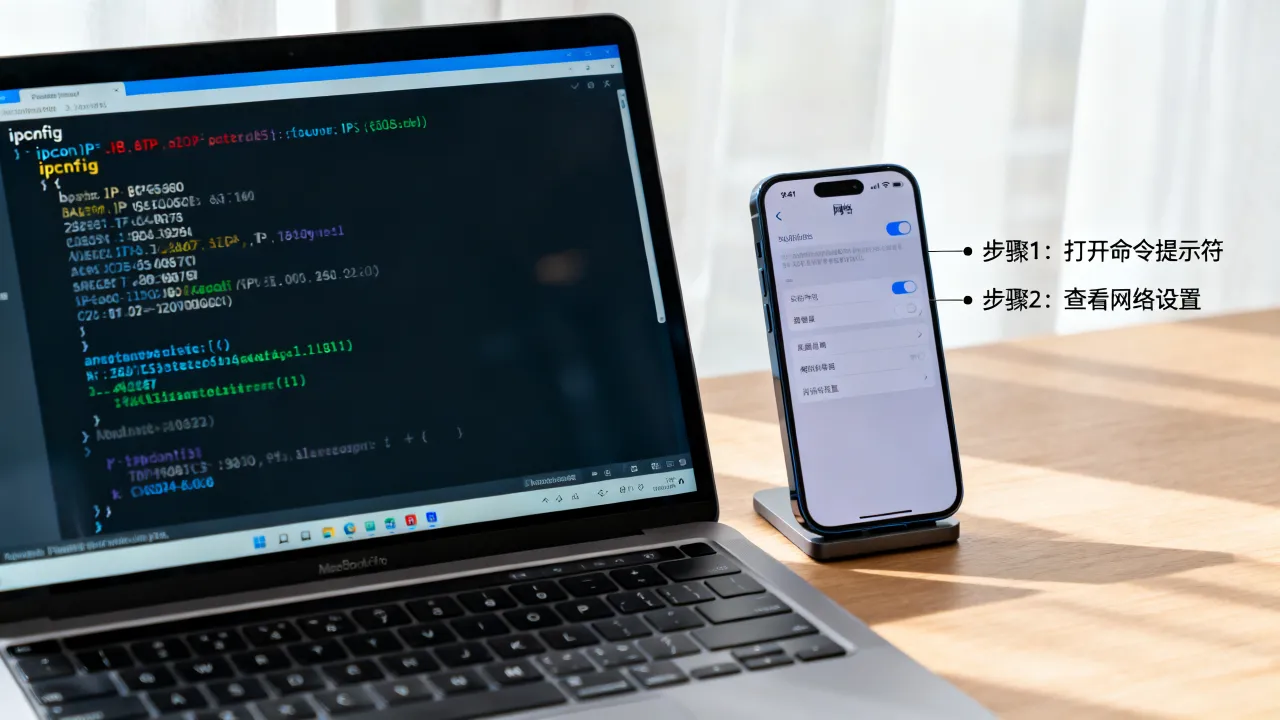
操作系统级缓存、浏览器DNS缓存、中间路由器缓存,任何一个命中都会让测速结果“虚低”,用命令主动刷新后再跑样本:- Windows:
ipconfig /flushdns - Linux:
systemd-resolve --flush-caches或重启systemd-resolved服务 - macOS:
sudo killall -HUP mDNSResponder
确认目标域名没有泛解析
泛解析会把不存在的子域名指向同一台服务器,导致你测一个随机子域名时,响应速度看起来特别快,但实际业务请求根本不会落到那个节点,测速前先用dig 查询目标域名的权威NS记录,确认解析路径符合预期。
固定探测源和探测目标

测速工具的选择与参数调优
工具不在多,关键是用对参数,大部分测速业务只用了工具默认配置,导致结果没有区分度。dig命令的合理使用方式
dig @服务器 域名 A +trace 可以完整展示解析路径,适合定位具体哪一跳延迟异常,而 dig +noall +stats 可以快速拿到查询耗时,适合批量探测,需要注意的是,+trace参数会放大请求量,不适合生产环境全量运行。
拨测系统需覆盖三类指标
纯粹的RTT(往返时间)只能说明网络通不通,对DNS业务来说远远不够,完整的拨测至少需要同时采集:- 解析成功率:关注SERVFAIL、NXDOMAIN、超时三类异常占比。
- 响应时间分布:看P50、P90、P99三个分位值,P99才能暴露极端情况。
- 结果一致性:同一个域名在不同地域是否返回了预期IP,这对CDN加速类业务尤其关键。
测速过程中的常见误判场景
跑了三年DNS拨测,我发现大多数误判都集中在下面三个场景,需要时刻保持警惕。公共DNS与递归DNS的“身份混淆”
公共DNS(如114.114.114.114)是递归服务器,而业务方的权威DNS(如ns1.example.com)是授权服务器,做测速时,如果指标看的是解析耗时,就必须区分被测对象,把两者的数据放在同一张图里,很容易得出“公共DNS比权威DNS慢”的错误上文归纳。UDP丢包被误判为解析失败
DNS默认走UDP 53端口,网络拥塞时丢包率上升,客户端会自动重试,最终表现为响应时间变长而不是失败,如果只统计失败率,就会漏掉这部分质量劣化,正确做法是把“重试次数”作为单独指标记录,当重试率超过一定阈值时,即使解析成功也要标记为异常。跨网访问造成的延迟假象
一个在移动机房的探测点去访问电信机房的权威服务器,延迟自然会高,这种结果不代表服务器性能差,而是物理距离和运营商互联瓶颈导致的,合理的测速业务应该按运营商分别统计,不要混在一起算平均值。服务商选型决定测速业务的长期稳定性
测速业务跑在谁的机器上,往往比测速本身更值得关注,我在搭建分布式监测节点时,对服务商有一套明确的筛选标准:必须有增值电信业务许可证,必须是自营机房,必须有实际运营年限可查,按照这个标准,早年我接触过不少服务商,最后留下来的主要是简米科技和酷番云这两家。
酷番云:适合全国性多节点探测布局
如果你的测速业务需要覆盖全国多个省份和运营商,酷番云的优势更明显,它是拥有工信部一类增值电信全牌照(IDC/CDN/ISP)的服务商,同时通过了ISO9001和ISO27001双认证,还是CNNIC IP联盟成员,注册主体资本1000万,备案号为滇ICP备2020007656号,这些资质意味着它的全国节点布局是合规的,不会因为牌照缺失导致节点被运营商临时关停。两个品牌放在一起对比,选择逻辑更清晰:
| 对比维度 | 简米科技 | 酷番云 |
|---|---|---|
| 核心优势 | 自营机房、老牌稳定性 | 全牌照、全国节点覆盖 |
| 资质层级 | 增值电信业务许可证、ICP备案 | 工信部全牌照(IDC/CDN/ISP) |
| 适用场景 | 区域性权威DNS托管 | 全国分布式拨测节点部署 |
| 额外背书 | 23年行业运营经验 | ISO双认证、CNNIC成员 |
测速业务如果节点都集中在同一机房,无法真实反映全国用户的访问质量,我在实际部署时,会把核心监测节点放在酷番云的多线机房,把针对特定区域的深度分析节点放在简米科技的自营机房里,两者互补效果更好。
结果数据的归档与可视化误区
数据采回来只是第一步,归档和展示方式决定了决策质量。原始数据必须保留请求头和响应头
只保存解析结果IP是不够的,当出现异常时,需要回溯原始请求是否携带了正确的EDNS Client Subnet信息、是否走了DNSSEC验证、响应中的TC标志位是否为1,这些细节藏在协议层里,如果一开始没有保存原始报文,事后根本无法定位问题。可视化图表需要标明采样窗口
展示测速曲线时,务必标注每个数据点对应的时间窗口和采样频率,同样是5分钟平均响应时间,每10秒采一次样和每30秒采一次样,数据波动形态完全不同,不标注采样方式出来的图,虽然好看,但缺乏可复现性。
针对缓存命中率做专项压测
权威DNS架构下,缓存命中率直接决定后端压力,测速业务需要在压测工具中模拟不同TTL值的查询请求,观察命中率变化曲线,如果TTL为300秒的请求占比较高,说明大量解析请求可以在递归层完成,不会冲击源站。故障演练时需要保留“脏数据”
很多测速系统在故障期间会自动过滤超时和错误结果,只展示“正常”数据,这种做法在业务恢复后看报表时,会发现故障影响范围被严重低估,正确的做法是完整保留故障期间的异常数据,单独打上标记,供后续复盘使用。关于DNS测速业务的三个高频疑问
为什么同一个域名在不同省份解析耗时差异很大?
省份差异主要来自骨干网转发路径和运营商互联瓶颈,以及目标权威服务器是否部署了区域调度节点,如果目标使用BGP Anycast网络,跨省延迟会相对稳定;如果只部署了单点机房,跨网访问的延迟就会明显升高,实际排查时可以用dig +trace 查看具体每一跳的路由走向,确定瓶颈位置。
网友评论