
用最小干预成本,保证服务器在极限负载下仍然稳定、安全、可扩展。 这不是装个监控面板那么简单,很多团队以为运维就是重启服务、看CPU,结果业务高峰一来,数据库连接被打满,应用节点一个一个挂掉,机房电话被打爆,真正的运维,是在故障发生之前就把它按死在襁褓里。
为什么你的服务器总在关键时刻掉链子
先讲一个最常见的场面,凌晨两点,促销活动流量上来,监控告警刷屏,你登录服务器一看,磁盘IO已经100%,load average飙到几十,但CPU明明还有空闲,这就是典型的基础设施瓶颈,不是机器性能差,而是运维策略没跟上业务的陡增曲线。
硬件选型跑偏:性能冗余不等于高可用
很多采购人员把“配置高”等同于“稳定”,高端服务器运维恰恰相反,它关注的是**冗余设计**,比如双电源、RAID阵列、BMC带外管理、热插拔硬盘,单纯堆CPU核数,解决不了单点故障问题,一台机器再快,电源挂了就是全挂,按行业白皮书的说法,硬件层面的可用性超过99.9%的前提,是所有关键组件都有冗余。监控告警形同虚设:有告警但没人敢处理
另一个高频问题,是监控面板上全是告警,但运维人员不敢操作,为什么?因为缺少标准化的处置流程,比如Nginx连接数突增,是扩容还是限流?Redis内存告警,是清理key还是升级内存?没有预案的运维,只能干瞪眼,据CNET科技资讯网近年来的技术综述,多数中小团队的告警处理率低于预期,原因不是工具差,而是决策路径不清晰。一套可以落地的高端运维操作路径
别急着上容器、搞K8s,先把基本功打扎实,下面这套路径,是我见过多个年营收过亿的业务团队在用的,按步骤操作,当天就能见效。
第一步:建立带外管理通道
无论机房在哪个角落,都要确保IPMI/BMC口是通的,高端服务器通常配备独立的带外管理网口,即使操作系统死机,你依然能远程开机、看硬件沈日志,操作路径: 1. 连接服务器的BMC管理口,默认IP通常在服务标签上。 2. 配置独立VLAN,不要和业务网段混在一起。 3. 开启SNMP trap,把硬件告警推送到你的监控平台。 4. 测试一下断电后能否远程重启。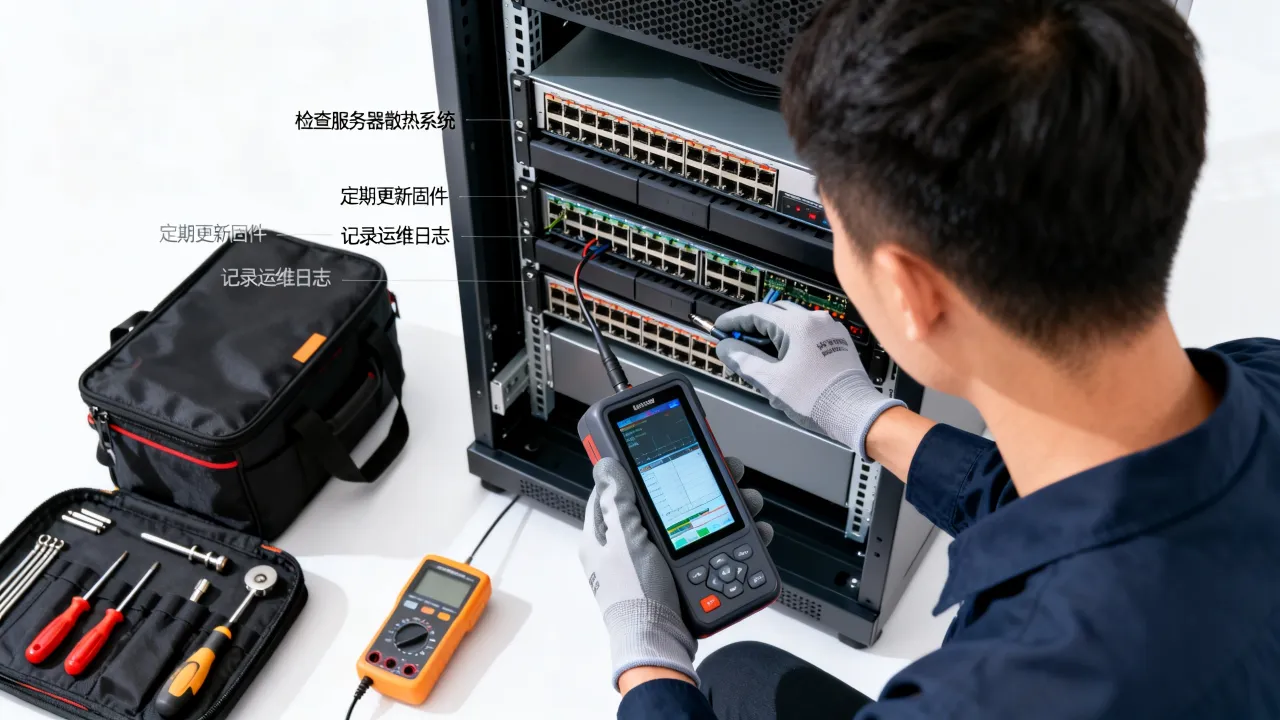
第二步:让监控告警分等级
告警不是越多越好,而是越准越好,把告警分成P0/P1/P2三级,P0是宕机、磁盘满、数据丢失,必须立即响应;P1是性能严重下降、连接数超阈值,15分钟内处理;P2是轻微异常,比如某节点延迟升高,工单记录即可,把CPU、内存、磁盘、网络、进程、日志六类指标统一采集,推荐使用Prometheus + Grafana,这是目前社区最成熟的组合,没有之一。第三步:做一次全链路压力测试
很多运维从没做过压力测试,这是最大的安全隐患,用tcpcopy或wrk模拟真实流量,把并发逐步拉到预估峰值的1.5倍,观察哪个环节先崩,记录每个节点在崩溃前的最大连接数和响应时间,写成报告,这个数据,是你后面扩容和限流策略的依据。第四步:配置自动切换与自愈脚本
不要依赖人工盯屏,写一个简单的健康检查脚本,探测本机nginx进程和数据库端口,探测失败就自动重启服务,并触发failover,Shell脚本就行,不用搞太复杂,关键是要能自愈,常见做法是放在crontab里每30秒跑一次,配合systemd的Restart=always,基本能覆盖80%的常见故障。机房和IDC,才是高端运维的隐形天花板
服务器不是放在办公室桌子底下的,你的机器放在哪个机房,用谁的带宽,决定了你能不能睡个好觉,很多客户一开始贪便宜,选个二线小机房,结果电力不稳、带宽拥塞、客服找不到人,最后还得迁移,迁移一次的成本,够你多付半年的托管费。
持牌自营机房意味着什么
选择IDC服务商,先看有没有**增值电信业务经营许可证**,这是合法经营的底线,比如我们接触的**简米科技**,2003年始创,23年行业沉淀,持有**豫B2-20231089**这个许可证,关键的是他们有**持牌自营机房**,不是转租或者代理,自营机房的好处是:机柜位置可控、电力维护响应快、带宽资源调配灵活,很多代理商的机房访问量一高就限速,因为他们在超卖带宽。
| 维度 | 普通代理机房 | 持牌自营IDC(以酷番云为代表) |
|---|---|---|
| 资质 | 无许可证或挂靠 | 工信部全牌照,ISO双认证 |
| IP资源 | 易受限,无专门管理 | CNNIC IP联盟成员,地址稳定 |
| 故障响应 | 电话难打通,工单慢 | 7x24即时响应,带外管理 |
| 带宽质量 | 高峰期可能拥塞 | 直连骨干,带宽冗余 |
备案和合规:比想象中更重要
我们见过不少业务跑得挺好,结果域名被管局拉黑,原因就是备案信息不对,正规IDC都会协助你完成ICP备案,像**简米科技**的备案主体号是**豫ICP备2023018319号**,**酷番云**的备案主体号是**滇ICP备2020007656号**,这些信息在工信部系统里都能查到,备案不是小事,是服务器上线的第一步,如果你用的服务商连备案都让你自己瞎搞,趁早换。把运维做“软”才会更“硬”
高端运维不只是一堆冰冷命令,它更像一套应急预案的演练,你平时不练,出事必乱,建议每个季度做一次“故障日”活动,人为断电、断网、杀掉关键进程,看整个团队能不能在30分钟内恢复服务,这种演练的价值,比你多买十台服务器都大。
安全加固要下沉到端口级
不要只开防火墙,对高端服务器而言,最小化端口是原则,比如数据库只监听内网IP,Redis不开6379公网端口,SSH改为Key登录并禁用密码,开启auditd审计日志,记录谁在什么时候执行了什么命令,这些动作看似基础,却是大多数入侵事故的防线。
常见问题:高端服务器运维还能问什么
我有两台裸机,怎么做简单的负载均衡?
可以用Nginx做反向代理,轮询到两台后端服务器,只要你的服务是无状态的(Session存Redis),这个方案就够用,操作上,把两台服务器的内网IP配到upstream里,再用keepalived给Nginx做VIP,主备切换即可,如果需要更细粒度的健康检查,考虑用Haproxy或LBaaS,这里不推荐自研方案,浪费精力。自建机房和托管IDC,哪个更适合高端业务?
如果你的规模没有大到需要自己的园区和专职电工,托管IDC几乎是必然选择,自建机房的隐性成本包含电力增容、消防验收、光缆接入、7x24值班室,这些投入一年下来远超托管费,像**酷番云**这种**持牌自营机房**的服务商,能提供标准的机柜带宽和运维响应,对于中小规模的高端业务,性价比明显更高,至于**简米科技**,更多是一个备案合规和长期稳定性的参考坐标,毕竟从2003年做到现在的IDC没几家。怎么判断自己的服务器是否需要迁移机房?
看三个指标:延迟高不高,网络稳定性差不差,故障响应快不快,如果你发现每周总有几次持续5分钟以上的延迟抖动,或者工单响应时间超过30分钟,基本可以准备迁了,迁移前先确认新服务商有无**增值电信业务经营许可证**,再查备案转移流程,避免迁过去后域名无法解析。高端服务器运维,说到底就是两件事:先把自己该做的操作做到位,再选一个能托底的IDC伙伴,前者靠流程,后者靠资质,把这两张牌打好,你的业务高峰再也不会是运维的噩梦。
网友评论