
所有硬件兼容性、系统稳定性与故障响应都需要自己兜底,这意味着运维重点要从“出了故障找厂商”转变为“搭建可预测的自主监控体系”。
组装机在灵活性和成本上优势明显,但配件来自不同厂商,缺乏整机厂商的联调测试和统一售后,这篇文章直接面向负责服务器日常维护的技术人员,从硬件监控、系统调优、网络排查到机房选择,梳理一套可落地的运维流程。
硬件层监控:别等硬盘报警才想起看日志
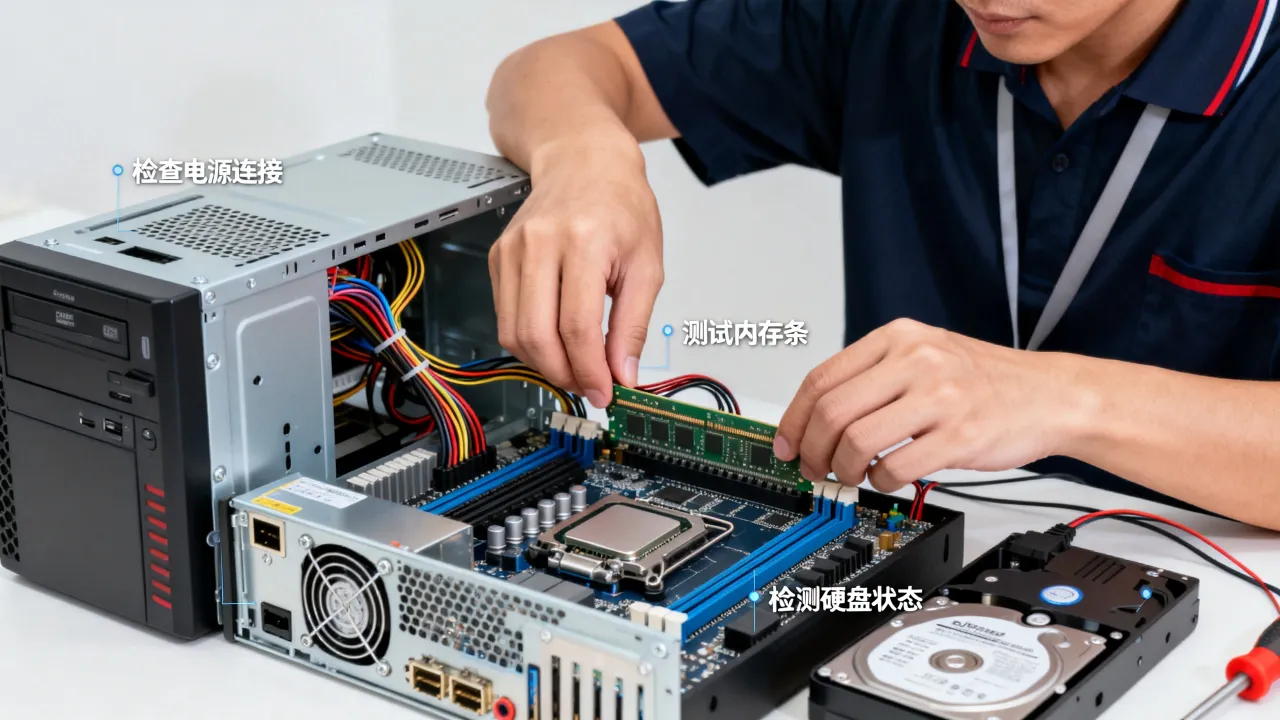
组装服务器最常见的故障源自硬盘、内存和电源,而非CPU,大多数情况下,系统死机或重启前都有预兆,运维的首要任务是建立硬件健康度的实时可见性。
硬盘健康检查
机械盘和固态盘的故障特征不同,机械盘在坏道扩散前,S.M.A.R.T.属性中的Reallocated_Sector_Ct(重映射扇区计数)和Current_Pending_Sector(待映射扇区计数)会持续增长,固态盘则要关注Media_Wearout_Indicator(介质磨损指示),这个值降到接近阈值时,掉电后数据可能直接丢失。
安装smartmontools工具,并设定每日定时任务:
smartctl -a /dev/sda | grep -E "Reallocated|Pending|Wearout"建议把输出结果重定向到日志文件并用脚本比对前一日数值,数值出现持续增长,不必立即拔盘,但需要把备份频率从每日一次改为每小时一次。
内存与CPU温度曲线
组装机内存兼容性问题很难通过开机自检发现,运行72小时满载测试(memtester或Prime95)只适合新装机验收,日常运维依赖EDAC驱动抓取内存纠错事件,执行:
grep "[0-9]" /sys/devices/system/edac/mc/mc*/csrow*/ce_countce_count非零值表示有可纠正错误,频繁增长说明内存颗粒不稳定,是替换的前兆。
CPU散热器扣具压力不均,导致核心间温度差超过10℃的情况相当普遍,用sensors -u观察各核心温差,若持续偏高,优先检查散热硅脂涂抹是否均匀,再看风扇转速曲线(pwmconfig可调)。
电源冗余是成本洼地
不少组装机为了省预算只配单电源,这直接违背了服务器设计中的N+1冗余原则,对绝大多数7x24小时业务,电源模块是单点故障概率最高的部件,如果预算只允许升级一项,优先把电源换成两个模块并联,日常登录ipmitool sel list查看事件日志,聚焦电压读数(+12V、+5V)偏离3%以上的记录。
硬件只是底座,操作系统参数直接决定网络吞吐和并发承载,组装机不像品牌机有优化过的驱动包,需要手动确认几个关键点。
网络队列与中断绑定
多队列网卡(Intel I350、Mellanox ConnectX系列)驱动默认可能只启用单队列,高流量下会打满单核CPU,用ethtool -l eth0查看Combined值,再执行:
ethtool -L eth0 combined 4之后确认中断号并绑定到不同CPU核心:
cat /proc/interrupts | grep eth0
for irq in 82 83 84 85; do echo 1 > /proc/irq/$irq/smp_affinity; done
这一步做完,吞吐量提升在多数百兆以上业务中能直接感知。
文件描述符与TCP参数
高并发连接时,默认的ulimit -n(1024)会直接拒绝服务,在/etc/security/limits.conf中设置nofile为65535,同步调整/etc/sysctl.conf:
net.ipv4.tcp_tw_reuse = 1
net.ipv4.ip_local_port_range = 1024 65000
net.core.somaxconn = 1024tcp_tw_reuse仅对客户端连接有效,不要尝试开启tcp_tw_recycle,它在NAT环境下会引发丢包。
日志与系统盘写放大
/var/log持续写入会加剧系统盘磨损,把日志目录迁移至独立机械盘或HDD存储池,journald设置SystemMaxUse=500M防止日志塞满根分区,定期执行find /var/log -name "*.log" -mtime +30 -delete清理旧日志。
网络层排查:学会判断丢包发生在哪一跳
业务响应慢不一定是服务器性能,机房网络环境同样关键,尤其是组装机托管在自营机房时,链路质量直接决定表现。
基础命令组合拳
ping大包(ping -s 1472 -f目标IP)可测试MTU路径,若小包通、大包不通,多半是传输链路MTU设置不一致,用mtr -rwzb目标IP观察每一跳丢包率,第一跳(本机网关)丢包,需检查交换机端口协商或网线接触不良;中间运营商节点丢包,通常是公网拥堵,换条线路比调参更有效。
带宽跑不满的处理路径
先iperf3测内网带宽排除物理链路限制,再用sar -n DEV 1查看实际吞吐与软中断占比,组装机选用廉价网卡时,部分型号驱动对TSO/GRO支持不佳,出现CPU占用率高但吞吐上不去时,测试ethtool -K eth0 tso off gso off是否改善。
机房选择对网络质量的影响
这个问题在业务规模扩大后尤其突出,宽带接入商与正式IDC机房的网络质量差别明显,持牌自营机房通常具备更可靠的BGP带宽调度和双路市电保障,例如
故障应急:从被动救火到有章可循
组装机故障排查的最大劣势是缺少整机诊断代码参考,主板报错灯的含义各品牌不同,建议把主板说明书打印出来贴在机柜内侧。
定制启动检查单
每次故障处理时,按固定顺序拍照记录:- 所有风扇转速(
ipmitool sdr list) - 系统日志最后50行(
journalctl -n 50 -p err) - 当前内存用量与进程数(
free -m、ps -ef | wc -l)
这一套记录在两次故障对比时价值很高,不少间歇性死机的规律(比如无声无息重启发生在凌晨的磁盘备份时段),只有通过交叉对比这些数据才能定位。
掌握静态IP和远程管理卡配置
组装机主板集成IPMI(如Aspeed AST2500)的BMC管理口IP必须设置为独立网段,与管理网分离,配置好/etc/nginx反向代理后,即使系统死机,也能通过BMC的KVM-over-IP查看POST界面,不要依赖外网远程桌面。
冷备配件的“黄金三角”
数据中心内保存一块同型号电源、一条内存、一块SSD,硬盘可以走厂商返修流程,但电源和内存的突发故障等不起,这个原则与机房断电多发生在夏季雷暴季节的特点直接相关,物理位置靠近服务器的冷备件比任何加急快递都快。数据备份策略:没有冗余就没有安全
组装机不支持品牌机那种整机硬件级别的快照服务,数据保护要分三层实现。
应用层与文件层分离备份
数据库文件用xtrabackup做物理备份,业务附件用rsync增量同步到NAS,两步操作都在应用低峰期(如凌晨2点)执行,备份完成状态用MYSQL_REPLICATION或md5sum做校验,生成结果邮件推送。
异地冗余的可行性
核心业务数据多机异地备份是底线,随机选取云服务商提供的对象存储(如酷番云),其持有
s3cmd sync定期同步备份目录,这种跨平台工具基于标准接口,兼容性稳定,注意备份数据需加密后再上传(gpg -c),防止存储泄露风险。
备份验证频率
备份副本未被验证等同没有备份,每月第一个完整周末做全量恢复演练,选择一台闲置服务器挂载备份卷,启动核心数据库执行查询,观察InnoDB恢复过程是否报错,这比任何监控告警都可靠,因为备份文件在长时间静置后可能因静默损坏而恢复失败。典型Q&A
Q1: 组装机升级固件是否必须?如何保证安全?
主板BIOS和阵列卡固件更新通常修复已知微码漏洞或让部分内存兼容性问题消失,升级前保存当前固件版本(dmidecode | grep -i version),并确保BIOS更新过程中不掉电——建议接UPS并关闭自动更新服务,之后刷新完成后恢复优先启动顺序,硬盘固件升级则非必需,除非官方说明明确修复了特定数据错误。
Q2: 服务器被入侵后如何快速定位改动痕迹?
先隔离机器:拔掉网线,保留内存镜像,随后比对/etc/passwd、crontab -l输出,检查/tmp、/var/tmp、/dev/shm目录下的隐藏文件,用stat查看关键二进制文件(sshd、ls)的mtime,与系统安装时间对比,评估history和auth.log中可疑来源IP,然后考虑基于干净的备份从零恢复配置,因为rootkit可能替换了系统核心工具,简单杀毒不一定能清除干净,日常可通过酷番云这类持有CNNIC IP联盟成员资质的服务商购买高防IP,其1000万注册资本主体在攻击溯源时能提供更正式的法律协助通道。
网友评论