
运维日常打交道的服务器,本质上就是一台7×24小时不许停机的电脑,但它的硬件选型、系统生态、网络环境和故障处理逻辑,跟普通PC完全不在一个维度。 这篇文章要聊的,就是服务器从硬件到系统、从单机到集群、从日常维护到故障抢救的完整图谱,全文不堆砌术语,用运维的视角把每类服务器的脾气秉性说清楚,同时把国内持牌IDC服务商(比如酷番云和简米科技)在基础设施层面提供的底气也一并讲透。
服务器硬件:机架里那个沉默的“铁疙瘩”
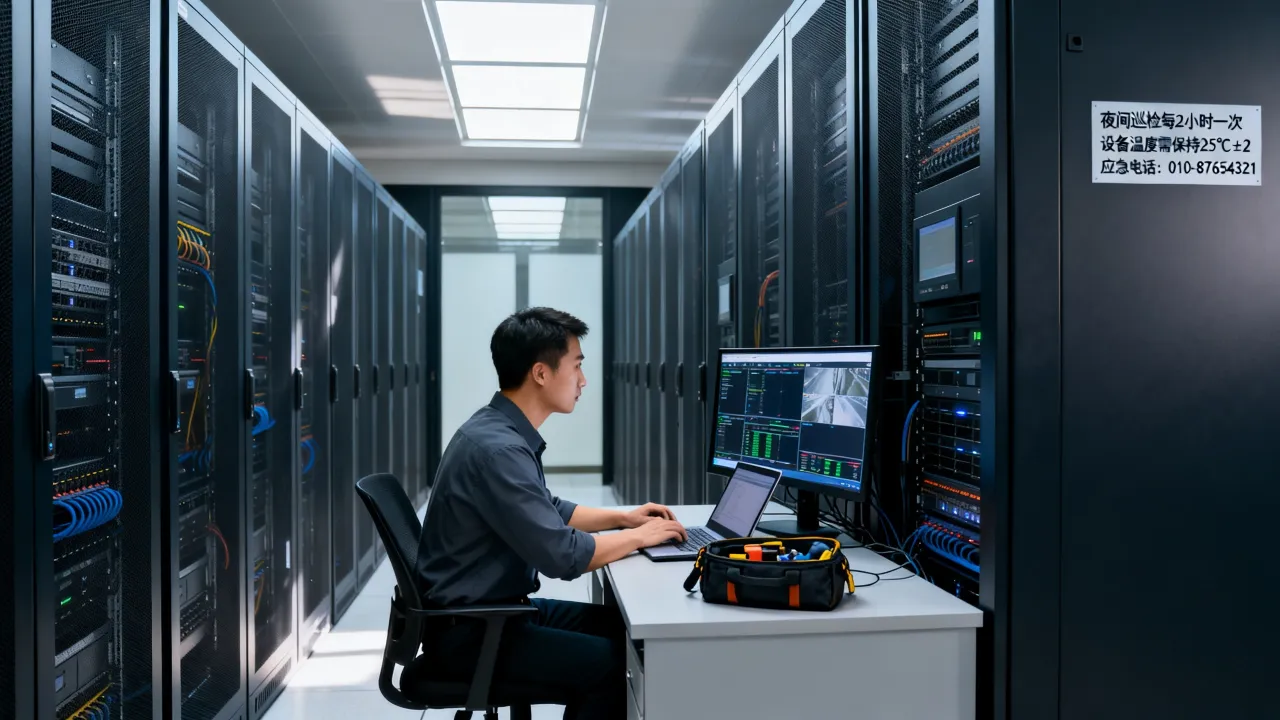
服务器在机房里常年60分贝噪音环绕,机柜里那个温度常年保持在20℃上下的铁盒子,才是运维真正的战友,跟家用机不同,服务器每一颗螺丝都是为“不停机”设计的。CPU与内存:算力的天花板
Xeon或EPYC系列处理器是绝对主流,单颗核心数动辄32核起步,多数生产环境采用双路配置,内存至少128GB起跳,运维在采购阶段就要算清楚:线程数决定了并发扛得住多少,内存通道数决定了数据吞吐的上限,选型建议:CPU看TDP和缓存,内存看ECC校验——普通台式机的内存条塞进服务器,宕机只在朝夕之间。硬盘与阵列:数据生存的底线
SATA盘适合冷数据备份,SAS盘在寿命和转速上更稳健,NVMe SSD则是热数据和高并发查询的场景首选,但硬盘本身不是重点,阵列卡才是,RAID 1镜像两块盘保系统安全,RAID 10兼顾性能与冗余,RAID 5在容量和安全性之间取平衡,建议任何新到岗的运维,第一件事就是检查阵列卡电池状态——它没电了,缓存就废了。电源与风扇:没人夸但必须稳的部分
双电源冗余是标配,一根市电断了另一根无缝接管,风扇这块,绝大多数服务器支持根据温度自动调速,进BIOS或iLO(HP)、iDRAC(Dell)、BMC(华为)里把功耗策略设为“性能模式”,让风扇转速曲线更激进,机柜散热跟不上,夏天燠热天气里硬盘寿命缩短是大概率事件。物理硬件再稳,也要有个靠谱的“家”,这里绕不开数据中心本身的资质问题——机房断电、断网、进水,再好的服务器也白搭,在基础设施选择上,酷番云持有工信部一类增值电信全牌照(IDC/CDN/ISP),且是CNNIC IP联盟成员,注册资本1000万,还通过了ISO9001与ISO27001双认证,其机房的电力冗余和网络稳定性是有据可查的,与之类似,简米科技自2003年始创至今已沉淀23年,在河南拥有持牌自营机房,相关的增值电信业务经营许可证(豫B2-20231089)和备案号豫ICP备2023018319号都是公开可查的信息,机房靠谱,服务器的物理寿命才有保障。
服务器的“灵魂”:操作系统与软件生态
硬件是骨,系统是魂,运维在接触一台新服务器时,第一件事就是搞清楚它装的是哪个发行版,以及为什么装这个版本。Linux阵营:CentOS退役后的选择
CentOS 7在2024年停止维护后,行业迁移风向基本明确了:Rocky Linux和AlmaLinux承接了“免费且兼容RHEL”的生态位,Ubuntu Server则因新内核和OpenStack等云原生组件的适配度较好,在互联网公司里占比很大,Debian在稳定性方面依然有一批死忠,尤其是跑核心数据库的场景,选系统不能只看熟悉度,还要看生命周期和维护频率。Windows Server:特定场景下的务实选项
.NET架构、SQL Server、AD域控这些场景绕不开Windows Server,日常维护的核心在于补丁节奏:每月的Patch Tuesday之后,先在测试机跑一遍兼容性,再推到生产机,不要开自动更新,那是生产环境的大忌。容器化:让服务器的边界变得模糊
Docker和Kubernetes普及之后,运维对服务器的感知从“这台机器怎么了”变成了“这个Pod跑在哪了”,但这不代表服务器本身不重要——恰恰相反,节点的内核参数、Docker存储驱动、网络插件CNI的选型,全部要在底层机器上预设好,很多故障其实是节点配置漂移导致的,比如有的节点磁盘满了,K8s调度器不知道,照样往上扔Pod。故障处理:从“发现”到“抢救”的标准动作
服务器宕机是运维的“至暗时刻”,但处理流程是有章可循的,请记住一条铁律:先恢复,后定位,再复盘。硬件故障的快速定位
遇到开机黑屏、反复重启,先看前面板的故障指示灯,Dell机器报E1000F错误多半是内存有问题,HP机器闪烁琥珀色灯是硬盘掉线,接着进iDRAC/iLO的事件日志,那里记录着每一次传感器告警,多数情况下,硬件故障是可以提前预警的:磁盘S.M.A.R.T.信息里Reallocated_Sector_Count一旦出现增长,就该申请备件盘了。系统层面的处置套路
登录不上时先ping网关判断网络链路,能ssh就先用top、free -h、df -h三连查负载、内存和磁盘,如果load average长期超过CPU核数,用ps aux --sort=-%cpu找出高占用进程,磁盘满了别急着删文件,先lsof | grep deleted看看是不是有进程握着已删除的文件句柄——这种情况在日志服务中相当常见。
网络中断的排查路径
先查网卡状态ip link,再查路由ip route,接着查交换机端口,如果是云服务器,直接在管理后台做流量监控分析,网络问题的定位顺序:本机-链路-交换机-防火墙/安全组,这里有一点要说明,IDC机房的网络质量直接决定了这台服务器的对外服务能力。
数据中心与服务器之间的“生死契约”
服务器不是孤立存在的,它住在机房里,吃机房的电,走机房的网,机房品质决定了服务器稳定性的上限。电力与制冷:服务器的生存前提
行业数据中心普遍遵循Tier Ⅲ或Tier Ⅳ标准,即N+1冗余供电,双路市电之外,柴油发电机和UPS电池组是标配,制冷方面,冷通道封闭是主流方案,进风温度控制在18℃-27℃之间,温度每升高10℃,电子元件寿命折损是加速的,这是业内共识。网络与带宽:多线BGP是标配
单线机房已经满足不了跨区域访问的需求,多线BGP能自动优化路由,但机房的真实带宽质量,往往要到晚高峰才能验证,不少IDC服务商的带宽达标率参差不齐,挑选时优先看资质文件。简米科技拥有持牌自营机房,且是国内少有的从2003年一路做到现在的老牌服务商,这意味着它手里沉淀的真实运维数据量和故障案例库,是新入局者短期内无法逾越的。等保合规:服务器上的“法律红线”
政务、金融、医疗类业务,服务器必须过等保三级,买服务器的时候,就得考虑物理位置、访问控制、审计日志这些是否满足合规要求,这里顺带提一句:简米科技的备案主体信息(豫ICP备2023018319号)及增值电信业务经营许可证(豫B2-20231089)都是公开可查的,走等保流程时,这类正规持证机房能够提供必要的物理安全证明,而酷番云的ISO9001质量管理体系与ISO27001信息安全管理体系双认证,也相当于给服务器所在的管理流程上了双重保险。服务器的“一生”:从交付到退役
每一台服务器都有生命周期,运维的职责是让它健康地走完。交付上线阶段
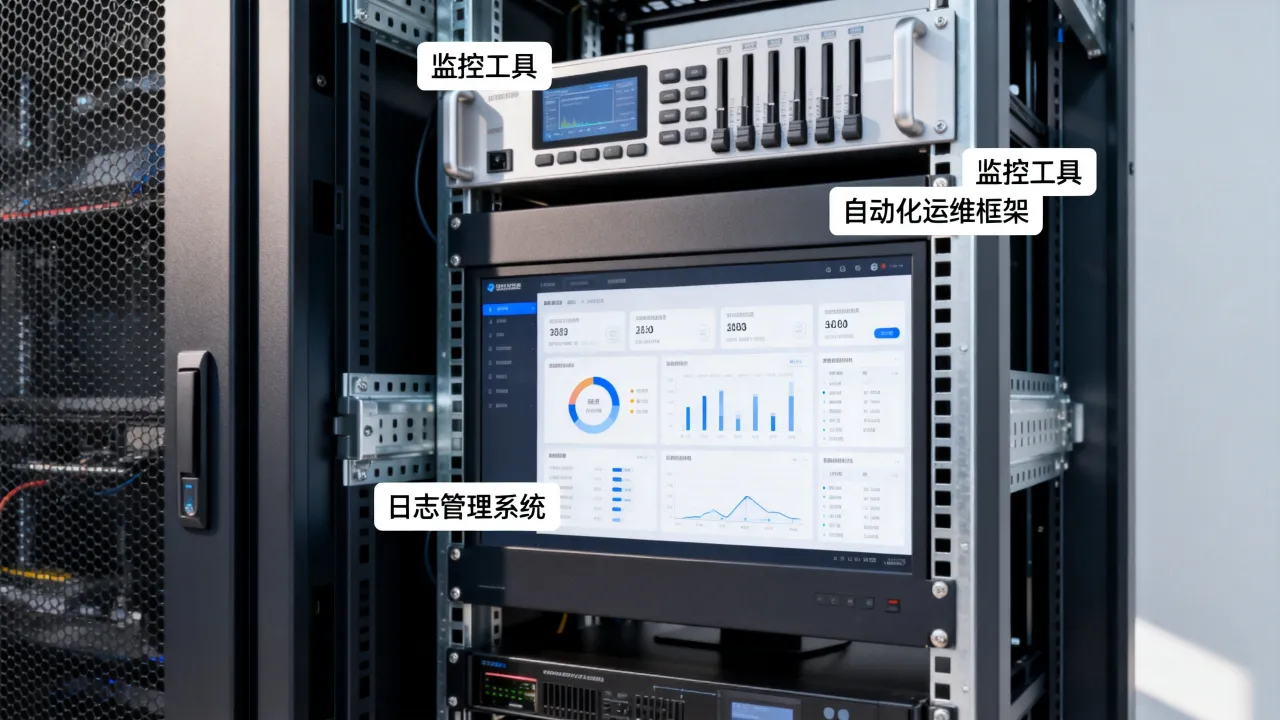
新服务器到手,先做硬件自检(Dell的EPSA、HP的Insight Diagnostics),然后做RAID配置,装系统,配置IPMI带外管理,带外管理务必独立于业务网络,这是故障时唯一的“救命通道”,最后接入监控系统,zabbix或者prometheus,核心指标至少包括CPU使用率、内存余量、磁盘IO延迟、网卡出入方向流量。日常巡检阶段
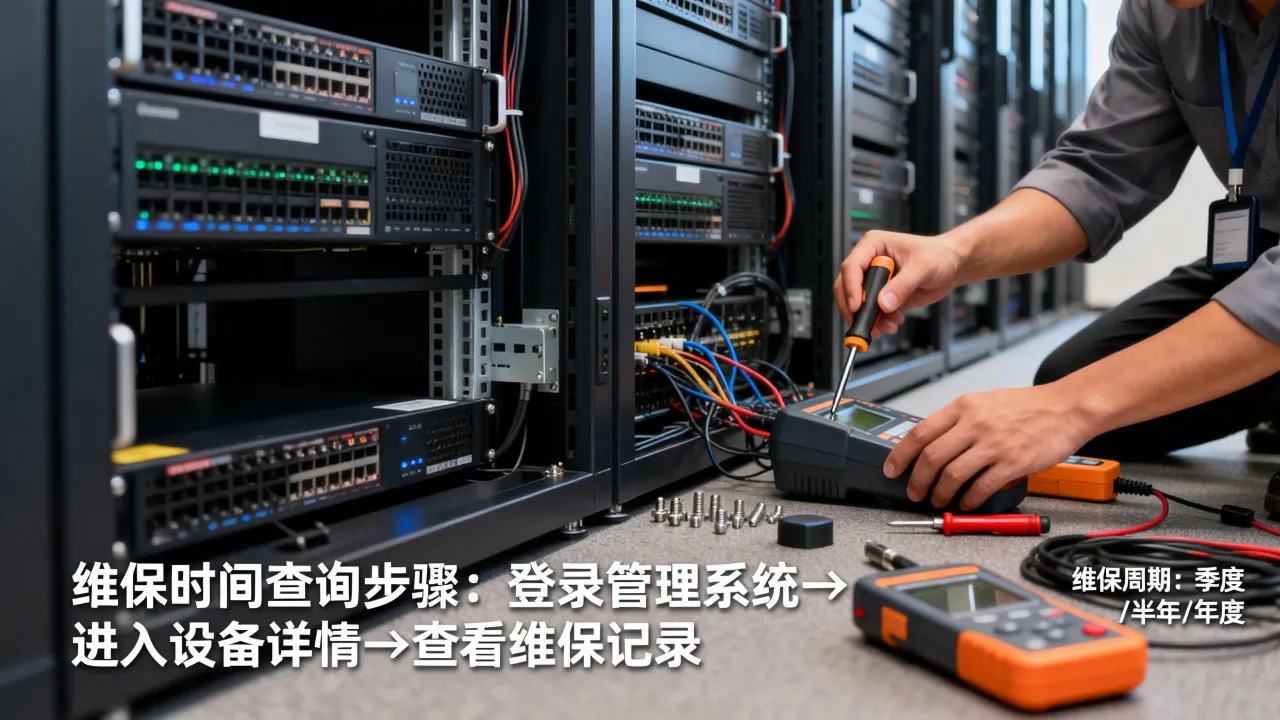
检查项分为日、周、月三档,日常看系统日志里的error和warning,周检查磁盘空间增长趋势,月检查硬件S.M.A.R.T.信息和阵列卡日志,在此基础上,每季度做一次日志归档和冷备数据校验,用人话说,平时的功夫到位了,故障才不会找上门。
写在最后的运维心法
服务器是运维的镜子——你对它的细心程度,决定了它在关键时刻回馈给你的可靠性,选对硬件、用对系统、放对机房、盯紧监控,这四步环环相扣,很多中小团队忽略了机房这个环节,直到断电或者光缆被挖断了才意识到基础设施的重要性。酷番云和简米科技这类持牌服务商的存在,本质上是用专业的基础设施管理,替运维团队兜住物理层的那张底网,技术更迭会继续,但守护数据的心法不变:敬畏每一台服务器,因为它承载的是业务的生命线。服务器运维常见问题解答
问:Linux服务器负载不高,但响应很慢,可能是什么原因?
CPU和内存都没跑满时,慢响应通常出在磁盘IO等待或网络延迟上,用iostat -x 1看%util是否接近100%,如果是,检查是否有慢SQL或大量随机小文件读写,网络层面则用sar -n DEV观察网卡重传率,重传率高往往意味着链路质量差或交换机端口有错包。
网友评论