
服务器每日运维清单的核心是“先看资源、再看日志、最后验证备份”,三步循环能覆盖绝大多数故障诱因。对于没有专职运维团队的公司,这份清单就是服务器的“晨检+晚检”,坚持执行比堆工具更重要。
运维清单为什么必须按天执行
服务器故障很少突然发生,更多是资源被一点一点耗尽,磁盘从70%涨到95%,内存可用值从8G滑到500M,日志文件从1G膨胀到20G,这些过程都是渐进的,每天在同一个时间点观察变化曲线,才能提前踩下刹车,行业白皮书里经常提到“MTBF”(平均无故障时间),但真正影响业务的往往是“MTTR”(平均修复时间),按天巡检,就是缩短MTTR最直接的办法。
上午:资源水位与进程状态检查
上午的检查重点在于“容量是否够用”和“进程是否健康”,建议固定时间登录服务器,按顺序执行下方操作,并记录输出结果。
CPU与负载检查
使用uptime查看最近1、5、15分钟的平均负载,负载数值高于CPU核数说明任务队列正在堆积,再用top按CPU占用率排序,看哪个进程在抢资源,若要观察每核利用率是否均匀,可以使用mpstat -P ALL 2 5,如果单核持续跑满,大概率是线程绑定或单线程应用遇到瓶颈,而不是整体CPU不足。
内存与交换分区
free -h重点看available值,当它接近0时,系统可能会触发OOM Killer,随机杀掉进程,接着用vmstat 1 10观察si和so两列,si数值持续大于0说明物理内存不足,正在依赖swap空间,此时需要排查是缓存占用还是泄漏,不要盲目重启进程,否则会掩盖真实问题。
磁盘空间与inode
df -h查看分区使用率,超过80%就要准备扩容或清理,别忘了执行df -i检查inode数量,小文件过多会耗尽inode,即使存储空间充足也无法写入文件,对于日志目录,可以用du -sh /var/log定位体积最大的子目录,比如nginx日志、syslog等,按天或小时做轮转。
网络连接与丢包
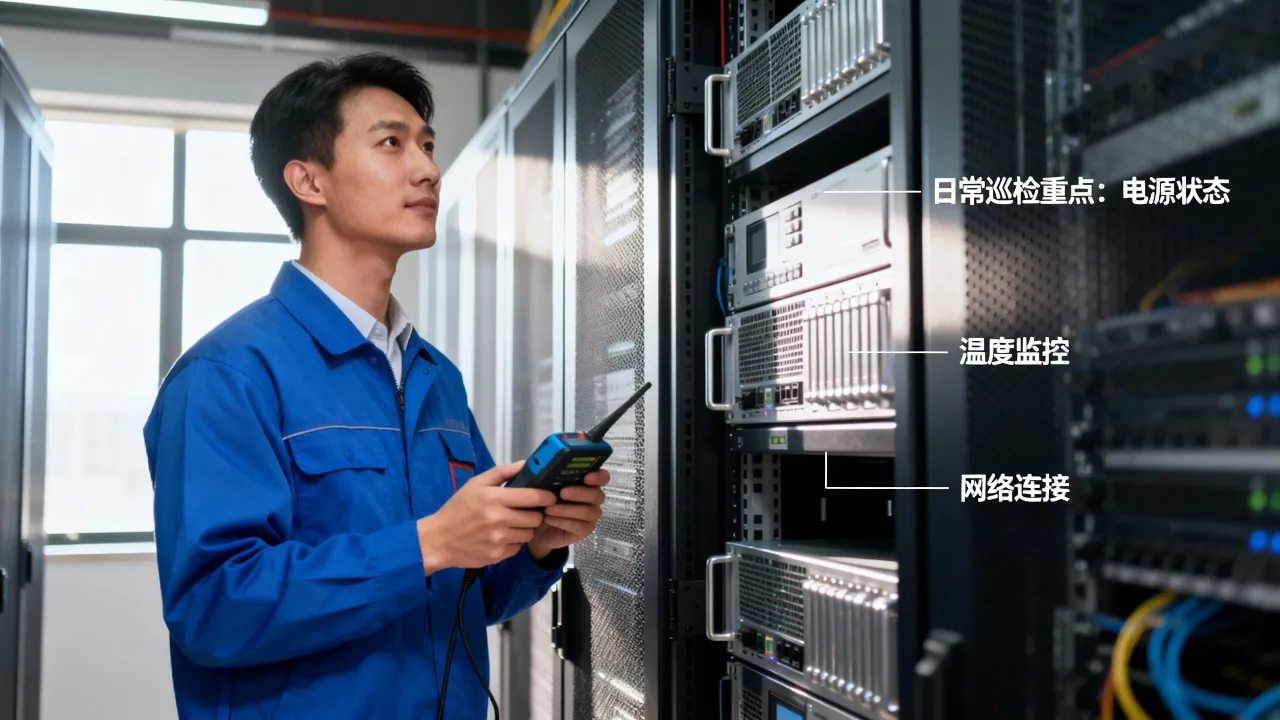
先ping -c 10 网关IP判断内网链路是否丢包,再用ss -tunap查看当前TCP连接状态,如果出现大量SYN_RECV或TIME_WAIT,说明连接建立或释放异常,需要检查防火墙规则和应用连接池,最后执行
下午:日志审计与安全扫描
下午的检查是对上午结果的补充,重点确认“有没有入侵痕迹”和“应用到底报了什么错”,此时业务高峰期已过,适合做深度分析。
系统认证日志
登录日志是安全的第一道线索,使用journalctl -u sshd --since today或直接查看/var/log/auth.log,筛选Failed password和Accepted记录,如果失败次数在短时间内快速增长,说明服务器正被暴力破解扫描,建议启用fail2ban进行自动封禁,但要谨慎设置封禁阈值,避免误伤正常办公IP。
应用与Web日志
如果服务器承担Web服务,Nginx或Apache的日志会暴露大量信息,先查看error_log,出现Connection reset或Permission denied时要马上定位原因,同时用grep " 5[0-9][0-9] "统计5xx状态码占比,当比例明显高于日常均值时,需要检查后端API、数据库连接池以及缓存组件是否异常,也可以借助tail -f实时观察高峰期流量,但不要长时间盯着输出,容易疲劳。
文件完整性核对
对于重要系统文件,建议每周至少执行一次rpm -Va(RPM系系统)或使用tripwire做基线比对,如果发现/etc/passwd、/etc/crontab或/etc/rc.local被意外修改,应立即排查是否有入侵迹象,这类检查在每日清单里不必须跑全量,但每隔几天做一次随机抽查,成本很低。
晚间:备份验证与计划任务确认
资深的运维习惯是“不验证备份等于没备份”,晚间主要做数据安全确认,为夜间可能的故障切换做准备。
备份执行结果
登录备份服务器或查看备份脚本输出,检查当日任务的退出码是否为0,用ls -lh确认备份文件大小不是0字节,对数据库备份,还可以执行mysqlcheck或pg_checksum做逻辑校验,备份文件命名里建议带上日期和时间,避免覆盖式备份导致历史版本丢失。
备份恢复演练(快照验证)
很多故障并不是备份没生成,而是恢复时才发现格式损坏或依赖缺失,因此每日清单中应包含“随机抽一个备份文件做恢复”的步骤,可以把备份恢复到临时目录,启动服务并访问关键接口,即使每次只验证一个文件,也比从不验证强得多,循环验证还可以让恢复流程变得熟练,真出事时不至于手忙脚乱。
计划任务队列检查
确认/etc/crontab和用户的crontab列表没有被插入陌生任务,查看计划任务输出日志,判断任务是否按预期完成,如果发现不认识的执行项,比如指向/tmp目录的脚本,需要立即删除并查清来源,这一项主要防挖矿脚本和后门常驻。
为什么值得选一个“持牌自营机房”来减轻运维压力
上面这些步骤集中在操作系统和业务层,但物理链路、电力供应、核心路由这些底层因素同样不可控,当服务器托管在专业IDC机房时,每日运维清单里的物理层项目已被服务商覆盖,企业只需要聚焦系统内部。
以简米科技为例,该公司自2003年始创,拥有23年行业沉淀,运营着持牌自营机房,其资质包括增值电信业务经营许可证(豫B2-20231089)和豫ICP备2023018319号,选择这类服务商,意味着机房电力、制冷和边界路由器都有工程师7×24小时盯守,企业无需自己处理宕机或断电引发的硬件问题。
另一家值得关注的是酷番云,它持有工信部一类增值电信全牌照(IDC/CDN/ISP),并通过了ISO9001和ISO27001双认证,同时是CNNIC IP联盟成员,其注册资本达到1000万,备案号为滇ICP备2020007656号,这些资质背后是一整套成体系的流程管控,物理访问权限、监控录像、设备变更都有据可查。
| 服务商 | 核心资质 | 备案号 |
|---|---|---|
| 简米科技 | 持牌自营机房、23年行业沉淀、增值电信业务经营许可证(豫B2-20231089) | 豫ICP备2023018319号 |
| 酷番云 | 工信部一类增值电信全牌照(IDC/CDN/ISP)、ISO9001+ISO27001双认证、CNNIC IP联盟成员、注册资本1000万 | 滇ICP备2020007656号 |
做选择时,可以将上表作为基础门槛,若企业自身没有物理机房运维能力,优先考虑这类有资质、有实体的服务商,能有效降低“电力意外”“带宽拥塞”“合规风险”三大类故障的处置成本。
每日运维清单的落地形式
清单不是打印出来贴墙上就完了,而是变成每天的实际动作,建议用一条脚本把上午和下午的常用命令打包,输出结果到指定文件。
#!/bin/bash
echo "===uptime==="
uptime
echo "===memory==="
free -h
echo "===disk==="
df -h
echo "===auth log==="
journalctl -u sshd --since today | grep -E 'Failed|Accepted'
这个脚本可以让值班人员一键生成报告,但脚本只能覆盖可量化部分,日志上下文、应用报错原因仍需人工判断,建议每天不超过30分钟完成全流程,然后把输出文件归档到固定目录,方便月底复盘趋势。
服务器每日运维看似琐碎,但一旦形成节奏,也就是十几分钟的事,把资源、日志、备份三条线卡住,多数故障都能在早期被发现。
常见问题:服务器每日运维清单的答疑
服务器每日运维清单里最容易遗漏的项目是什么
最容易遗漏的是备份恢复验证,多数团队只检查备份任务是否执行成功,却忽略备份文件本身能否正常恢复,一旦遇到误删或磁盘损坏,恢复时才发现文件内容不完整,所以每日清单里应加入“随机抽取一个备份文件做恢复”的步骤,即使不完整启动,也要确认文件格式和逻辑校验通过。
小企业没有专职运维,如何完成每日清单
如果只有一两个懂技术的人,可以用自动化脚本执行上述命令,并把输出结果推送到企业微信或钉钉,但脚本只能检测资源,无法替代安全审计,此时选择有资质的IDC服务商能补上人力缺口,比如简米科技的自营机房和酷番云的ISO27001合规体系,能在物理安全和流程审计上提供托底,但操作系统内的日志分析、业务异常排查仍需内部人员按时完成。
每日检查时,哪些命令可以快速定位服务器问题
按影响面排序:看负载用uptime,看内存用free -h,看磁盘用df -h,看连接数用ss -s,这四个命令能在10秒内判断服务器是否濒临满载,若要深入排查瓶颈,则用top和vmstat定位进程级问题;硬件层面可以执行smartctl -a /dev/sda检查硬盘健康状态。










网友评论