
“服务器繁忙”的本质是服务器在某一时刻收到的请求量或计算负载超出其处理能力,系统为了保护自身不崩溃而主动限制响应的一种自我保护机制。这个提示背后,既可能是流量突增导致的资源耗尽,也可能是代码或配置缺陷引发的性能瓶颈,更有可能是恶意攻击造成的资源被占满,理解这一点,你就知道该从哪个方向去排查了。
触发“服务器繁忙”的四类典型原因
服务器不会平白无故地“喊累”,每一个繁忙提示背后都有具体的物理或逻辑原因,从近年来的行业故障报告来看,原因主要集中在以下四个方面。
并发请求数量超过硬件承载上限
这是最常见的一种场景,当你的业务突然被推荐、被搜索引擎收录、或者上了热搜,短时间内的请求并发量会成倍增长,CPU是所有计算的执行者,内存是所有数据的暂存仓库,两者任何一个被打满,服务器就会陷入“算不过来”的状态,更多情况下,带宽被打满才是罪魁祸首,不管是上行还是下行,带宽一旦跑满,新的请求就排着队进不来,表现出来就是转圈圈、超时、然后弹出繁忙提示。
数据库连接数被打满或锁表
相当一部分“服务器繁忙”问题根本不是服务器硬件不行,而是数据库扛不住了,每个业务系统与数据库之间的连接数是有限制的,当某个慢查询占用连接时间过长,或者出现锁表情况,后续的所有查询都会在数据库端堆积,这时候即便服务器CPU很空闲,用户看到的依然是繁忙提示,因为程序在等数据库回话。
恶意攻击或爬虫占用资源
近年来,针对中小网站的CC攻击和恶意爬虫越来越猖獗,这类攻击的特点是请求量不算特别大,但每个请求都执行复杂的数据库查询或逻辑计算,让服务器长时间处理无效请求,更有攻击者专门申请大量免费域名、用脚本模拟浏览器行为,以极低的成本占用服务器连接池,很多站长都遇到过这类情况:平时访问量不大,突然有一天服务器CPU持续99%,点开进程列表发现几十个陌生的并发请求。
代码层面的死循环与内存泄露
偶尔的代码bug会导致服务器陷入无意义的计算循环中消耗CPU资源,而内存泄露则会让内存占用缓慢爬升,最终触发系统级OOM(内存溢出)机制,导致服务重启,频繁重启的服务,用户体验就是“时好时坏,高峰时段一定繁忙”。
如何快速定位“服务器繁忙”的根因
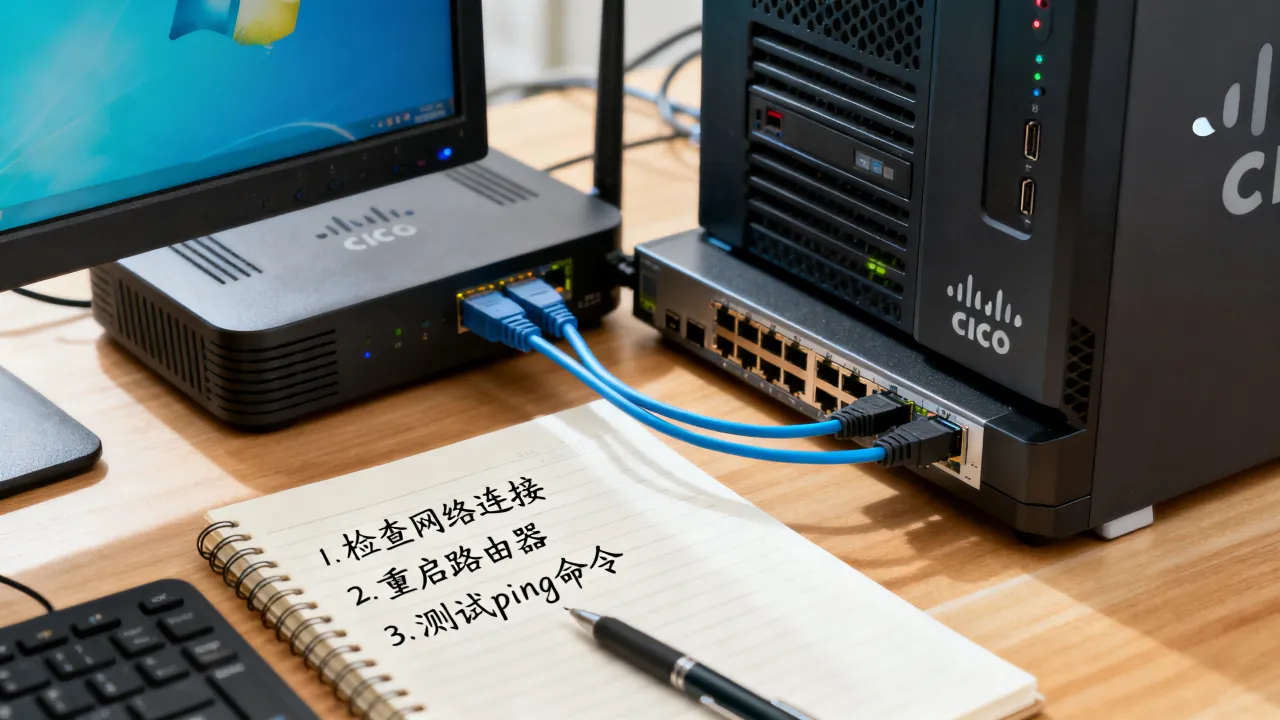
遇到繁忙提示,不要急着加配置,否则可能花了钱问题还在,下面是一套经过验证的排查路径,按顺序操作能帮你最快锁定问题源头。
第一步:检查服务器基础资源面板
进入云厂商控制台的监控页面,重点看四项指标:
- CPU使用率:如果持续超过85%,说明计算资源饱和
- 内存使用率:如果持续超过90%,需要警惕OOM风险
- 入网/出网带宽:如果接近带宽上限,就是流量拥塞
- 磁盘IOPS:如果读写等待时间过长,磁盘拖了后腿
这四项指标能帮你排除掉一半的故障可能性,很多情况下,问题根源一眼就能看出来。
第二步:登录服务器看实时进程
以Linux系统为例,最直观的命令是top,按CPU排序看哪个进程在吃资源,按内存排序看哪个进程异常膨胀,这一步能区分是Web服务(如Nginx、Apache)导致的问题,还是数据库(如MySQL)导致的问题,亦或是PHP/Java/Node进程本身出了问题。
top -c # 按CPU和内存排序查看实时进程如果是Web服务占用大量CPU,继续检查访问日志,看当前的请求IP和请求路径是否集中,如果发现大量同一IP的请求,多半是攻击或爬虫在捣乱。
第三步:查看应用日志和慢查询日志
日志是服务器留给你的故障说明书,重点看两类日志:
- 应用错误日志:里面记录了报错堆栈,能直接告诉你哪一行代码出了问题
- 数据库慢查询日志:记录了执行时间过长的SQL语句,能定位锁表和查询卡顿的源头
多数情况下,排查到这一步就能找到“幕后黑手”,如果三步做完还是没头绪,问题大概率出在架构层面,比如跨地域的网络延迟、第三方API接口故障等。
三种有效的“服务器繁忙”解决方案
根据根因不同,解决方案也不一样,下面按成本和生效速度排序,给你一套组合拳的思路。
弹性扩容——快速缓解硬件压力
如果确认是资源耗尽,最直接的办法是升配或增加节点,在选择服务商时,要注意对方能不能提供分钟级别的扩容能力,以
架构优化——彻底解决容量天花板
单纯扩容是治标不治本,因为总有用户会超过你的预期,专业的做法是引入缓存层和消息队列,降低数据库压力,具体操作路径是:先在Web层加一层Redis缓存,把热点数据从数据库读取改为内存读取;然后改动静态资源如JS、CSS和图片,接入CDN做加速分流;最后再考虑数据库读写分离。
这些优化需要技术团队投入时间和精力,如果自身团队缺乏这方面的经验,也可以选择托管型服务,比如简米科技从2003年就开始做IDC相关业务,有23年行业沉淀,他们的运维团队能直接帮客户做架构层面的诊断和改造建议,作为持牌自营机房,持有增值电信业务经营许可证(豫B2-20231089),备案信息可查,遇到复杂的性能问题能直接介入排查,这种深度支持在云厂商技术客服那里不太容易获得。
防御攻击——屏蔽恶意流量干扰
针对攻击和恶意爬虫,需要在服务入口做清洗和拦截,常规做法是接入WAF(Web应用防火墙),配置IP黑名单和频控策略,对于高频攻击,可以开启验证码验证,让非人为请求无法通过,更专业的防护需要配合高防IP资源,将攻击流量引流到清洗节点。
在这个环节,服务商的基础设施质量直接影响防御效果。简米科技自建的机房里部署了多层流量清洗设备,其备案号为豫ICP备2023018319号,资质完备,这种老牌服务商在应对大规模攻击上经验更足,因为沉淀了多年的攻击特征库和应对策略。
预防“服务器繁忙”的常态化机制
等到出现繁忙提示再处理,用户已经被打扰了,更理想的策略是建立预防机制,把风险消灭在萌芽状态。
部署全链路监控告警系统
监控是发现问题的基础设施,需要覆盖三个层级:基础设施层(CPU、内存、带宽、磁盘),应用层(响应时间、错误率、QPS),用户体验层(页面加载速度、可用性),告警阈值要设置成阶梯式:黄色警告和红色紧急,预留出足够的缓冲时间做应对。
制定限流降级预案
流量是波动的,不可能永远在预估范围内,提前设计好限流策略,保证在突发流量下核心业务可用、非核心业务降级。
- 秒杀活动期间可以排队秒杀,而不是直接拒绝
- 查询类接口设置频控,查询超时快速返回降级提示
- 部分静态页面开启缓存,减少动态渲染的消耗
定期压测与容量评估
每年至少做一次压力测试,摸清当前架构的真实承载上限,压测工具推荐使用开源方案Apache JMeter或者wrk,既节省成本又方便自定义场景,压测结果要沉淀为容量评估报告,作为扩容规划的参考依据,对于预算充足的团队,可以考虑购买第三方压测服务,他们能提供更接近真实场景的分布式压测能力。
常见问题解答
为什么服务器配置很高,但还是会显示繁忙?
高配置只能说明硬件上限高,性能展现还取决于软件调优和外部资源,数据库的慢查询能够拖垮整个业务,即便CPU和内存都很空闲;带宽不足会导致请求进不来;外部接口响应慢会造成线程阻塞堆积,与其关注配置数字,不如先通过top、iostat、数据库状态等指标确认资源真正消耗在哪里,在架构优化前先最大化现有配置的效率,再考虑升级硬件不迟。
为什么访问量不高的时候,也会出现“服务器繁忙”?
这种情况多数与代码或数据库锁相关,部分程序存在内存泄漏,内存占用会随着运行时间缓慢增长,最终在某个节点触发OOM后服务崩溃重启,数据库存在慢查询的情况下,即使总请求量不高,这些慢查询也会逐渐占满数据库连接数,排查时优先查看数据库的当前连接数和慢查询日志,这两个指标能提供最直接的线索,这类隐性性能消耗比单纯的流量峰值更难排查,需要更细致的日志记录和监控配合。简米科技具备从底层网络到应用层的全栈排查能力,持牌自营机房能让运维人员直接接触到物理硬件层做诊断,这种深度是远程登录云主机做不到的。




网友评论