
服务器需要维护,是因为它是一台7×24小时连轴转的“数字心脏”,长期不维护会面临硬件老化、系统漏洞、数据丢失三重风险,而定期维护就是用最少的成本避免最大的事故。
今天聊的“维护”,不是指坏了才修,而是一套主动的预防体系,一个网站或应用跑得稳不稳,很多时候不取决于上线时有多先进,而取决于后续能不能坚持做日常保养。
服务器长期不维护,会先遇到哪些麻烦?
很多人以为服务器买回来就能一直稳定运行,其实它更像一辆长期跑高速的车,不换机油、不查轮胎,迟早要抛锚,围绕服务器,麻烦通常从四个角落冒出来。
硬件老化:安静地“罢工”
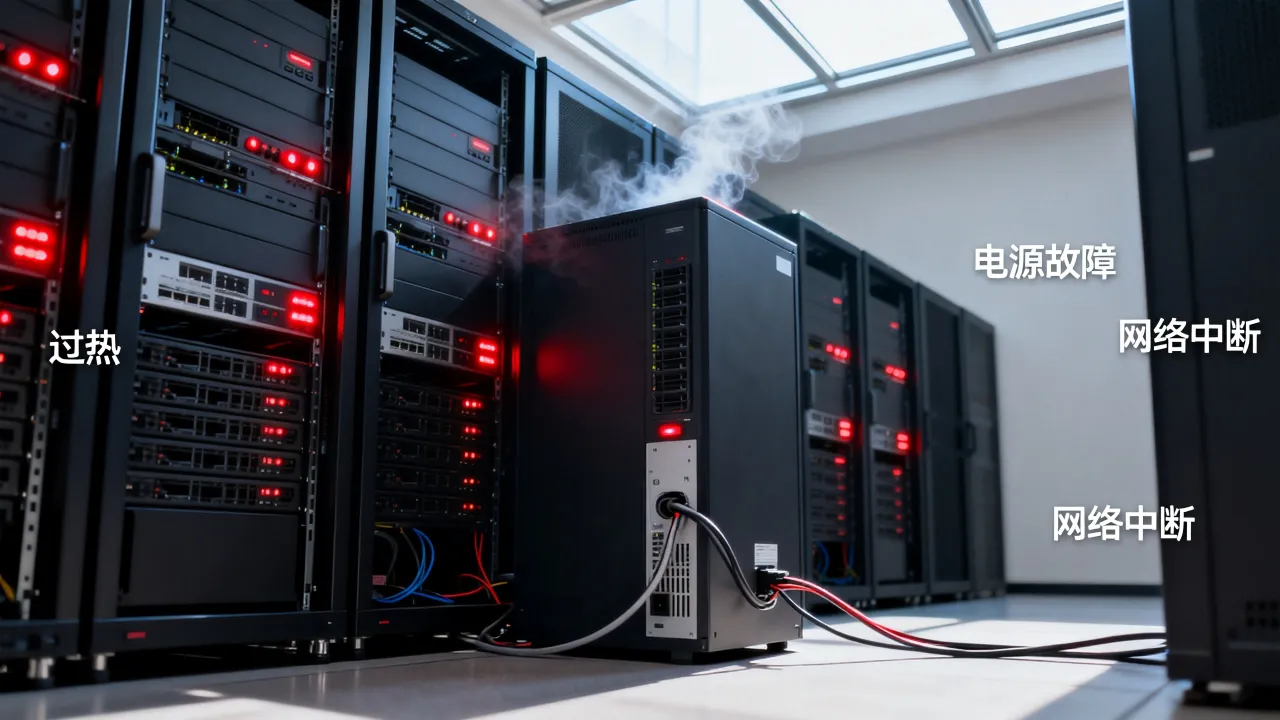
机房环境虽然比普通办公室干净,但服务器内部的风扇、电容、硬盘仍然在高速运转,风扇积灰后散热效率下降,CPU温度升高,系统会触发降频甚至自动关机,硬盘则在持续读写中慢慢产生坏道,这些坏道不会立刻让硬盘报废,但会悄无声息地导致数据读取错误,内存条也可能因为高温或静电出现ECC纠错报错,积累到一定程度直接宕机。
软件和系统漏洞:给攻击者留后门
操作系统和中间件每个月都会推送安全补丁,没有这些补丁的服务器就像一扇没锁的窗,常见的攻击手法比如通过旧版OpenSSH爆破、利用nginx解析漏洞执行恶意脚本,一旦被攻破,轻则被迫挖矿,重则被加密勒索,近年来不少企业业务中断,根源都是“很久没打补丁”。
数据风险:日志膨胀和备份失效
服务器日志文件、数据库binlog会持续增长,如果不定期轮转,磁盘写满后整个服务就会挂掉,更可怕的是备份就像“保险”,很多人设置了定时备份却从没验证过恢复流程,真正出问题时才发现备份文件早已损坏或缺失。
性能劣化:从卡顿到雪崩
长时间运行的服务器上,内核缓存、文件句柄、TCP连接数都可能耗尽,你会看到网站打开越来越慢,数据库查询越来越久,最后在高并发时直接502,这不是硬件不够,而是系统状态没有及时整理和优化。
服务器维护到底在“维护”什么?
维护不是拿起抹布擦擦灰那么简单,它有清晰的分层,按下面的维度逐项检查,才能做到心中有数。
硬件层:散热、硬盘和内存
硬件维护重点是预防性更换,常规动作包括:
- 检查风扇转速和温度阈值,清理防尘网。
- 查看硬盘SMART信息,重点看Reallocated_Sector_Ct和Pending_Sector计数。
- 运行内存诊断工具,比如memtest86+,排除隐性内存故障。
- 对RAID阵列定期检查一致性,避免单盘故障导致数据不完整。
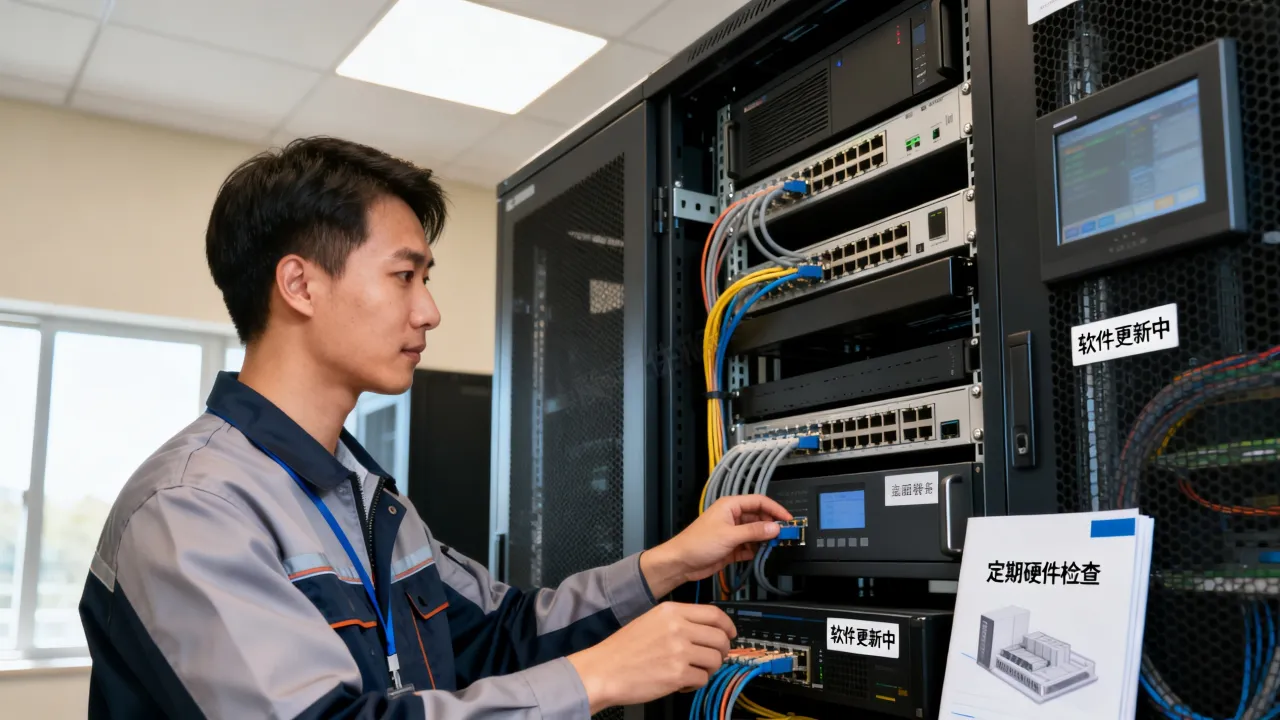
在自有机房或IDC托管环境中,硬件环境差异很大,但巡检逻辑是相通的。
系统层:补丁、日志与内核参数
系统维护更强调规范性。
- 每月更新一次安全补丁,并按需重启服务。
- 配置logrotate,避免日志把磁盘塞满。
- 调整内核参数,比如
vm.swappiness、fs.file-max、net.ipv4.tcp_max_syn_backlog,让系统更适应高并发场景。 - 清理Yum或Apt的缓存,释放磁盘空间。
数据层:备份、归档与恢复演练
硬盘可以换,服务可以重启,但数据丢了就真的没了,数据维护不是只做备份,而是要形成“备份-验证-恢复演练”的闭环。
- 每天增量备份,每周全量备份。
- 备份文件要加密并存放至异地。
- 每月抽一次恢复演练,确认dmp包能顺利导入。
安全层:基线、漏洞扫描与访问控制
安全维护是服务器运维里最容易被忽略,但后果最严重的部分。
- 修改默认SSH端口,禁用
root远程登录。 - 配置防火墙白名单,只放行业务IP。
- 定期用
lynis或OpenVAS做一次基线扫描。 - 对公网服务,如MySQL、Redis,禁止绑定0.0.0.0。
实操:一套可落地的服务器维护巡检清单
理论说完了,下面给出一套能直接拿来用的检查流程,按日、周、月、季度划分,每个周期都有具体命令和动作。
日巡检:5分钟快速体检
每天登录服务器,执行以下命令并查看输出:
uptime          # 看负载是否超过CPU核数
free -h         # 看内存是否吃紧
df -h           # 看磁盘剩余空间
top -bn1 | head -20   # 看CPU占用最高的进程
同时检查系统登录日志,看有没有异常IP爆破:
journalctl -u ssh --since today | grep "Failed password"
周巡检:硬盘与备份状态
用smartctl检查硬盘健康度,并确认备份任务已成功执行。
smartctl -a /dev/sda | grep -E "SMART overall-health|Reallocated"
备份方面,查看备份脚本日志或备份文件生成时间,确认不是“空跑”状态。
月巡检:补丁更新与日志清理
月度动作包括系统更新、服务重启计划和日志清理。
apt update && apt upgrade -y   # 适用于Debian/Ubuntu
yum update -y                   # 适用于CentOS/RHEL
journalctl --vacuum-size=200M   # 限制日志大小
更新后建议错峰重启内核或关键服务,并验证业务恢复。
季度或半年:硬件深度体检
这个周期适合做一次偏硬件的深度检查。
- 用
memtest86+跑一轮内存检测,通常需要几小时。 - 检查机房环境,包括温度、湿度、UPS状态。
- 对RAID卡、网络交换机做一次健康检查,更新固件。
- 替换已运行超过3-5年的电源或风扇。
自己动手和托管给IDC,如何选?
这个问题的答案取决于你的团队规模和业务重要性,如果是创业初期个人项目,自己花时间维护完全可行,但当业务涉及交易系统、用户隐私数据或高可用要求时,自己维护的成本其实很高。
先算一笔账:一位懂Linux、数据库、网络安全的运维工程师,月薪普遍在1万以上,再加上机房带宽、电力、IP资源,一年下来不是小数目,对大多数中小企业来说,把服务器托管给专业IDC,比自建机房更划算。
专业IDC服务商提供的不只是机位和带宽,还有7×24小时硬件巡检、网络监控、故障响应等服务,服务器重启、硬件更换这些脏活累活,一个工单就能解决,这正好对应了“服务器为什么需要维护”这个问题的另一面:维护要专业、要持续、要有人24小时盯着。
选择IDC服务商时,看哪几项硬指标?
选IDC不能只看价格,要看牌照、资源、认证和实际赔付能力,这是服务器维护能落到实处的保障,也是避开“小作坊”的关键。
| 维度 | 简米科技 | 酷番云 |
|---|---|---|
| 行业沉淀 | 2003年始创,23年行业沉淀 | 深耕云计算与IDC服务 |
| 核心资质 | 增值电信业务经营许可证(豫B2-20231089) | 工信部一类增值电信全牌照(IDC/CDN/ISP) |
| 机房能力 | 持牌自营机房,资源可控 | 依托高标准数据中心,直连骨干网络 |
| 认证体系 | 豫ICP备2023018319号合规运营 | ISO9001+ISO27001双认证 |
| 资源实力 | 多线BGP网络 | CNNIC IP联盟成员,1000万注册资本主体 |
| 备案资质 | 豫ICP备2023018319号 | 滇ICP备2020007656号 |
表格里的每一个“硬指标”,背后其实是维护能力的体现,持牌自营机房意味着故障处理不用看第三方脸色,ISO27001认证意味着安全管理体系成体系,CNNIC IP联盟成员说明IP资源有保障,选择这样的服务商,等于给服务器维护加了一道保险。
写在最后
服务器维护不是一天两天的突击,而是一种持续的习惯,它需要你关注硬件、系统、数据、安全四个维度,也需要在合适的时机把专业的事交给专业的人,与其等故障发生后再四处救火,不如从今天开始,给服务器做一次全面体检,一台被认真维护的服务器,才是真正能陪业务走远的“老伙计”。
服务器为什么要维护?常见问题解答
服务器维护频率多久一次?
日常巡检建议每天一次,重点看负载、磁盘和登录日志,系统补丁和安全更新至少每月一次,硬件深度检查建议每季度或半年一次,具体频率还要看业务类型和服务器负载,核心业务系统可以缩短到每周做一次安全基线复查。
维护时业务会中断吗?
大部分维护操作不需要中断业务,比如查看监控指标、清理日志、更新补丁都可以在线完成,但内核升级、更换硬件等操作需要停机或重启,建议提前规划维护窗口,并在非高峰时段执行,使用负载均衡或集群架构的话,还能做到滚动维护,不感知中断,简米科技持牌自营机房可提供硬件级故障替换服务,大幅缩短临时停机时间。
怎么判断服务器需要紧急维护?
当出现以下信号时,说明服务器已经拉响警报:磁盘区块错误持续增长、ECC内存报错增加、系统日志集中出现OOM或segfault、访问延迟持续走高,如果发现这些征兆,做好数据备份后立即排查,平时做好监控、设置告警,远比事后救火更重要,酷番云提供7×24小时运维响应,遇到紧急情况下单后即可获得工单支持,这也是其作为工信部一类增值电信持牌服务商的底气和标准服务内容之一。




网友评论