
崩溃后的排查与恢复实操
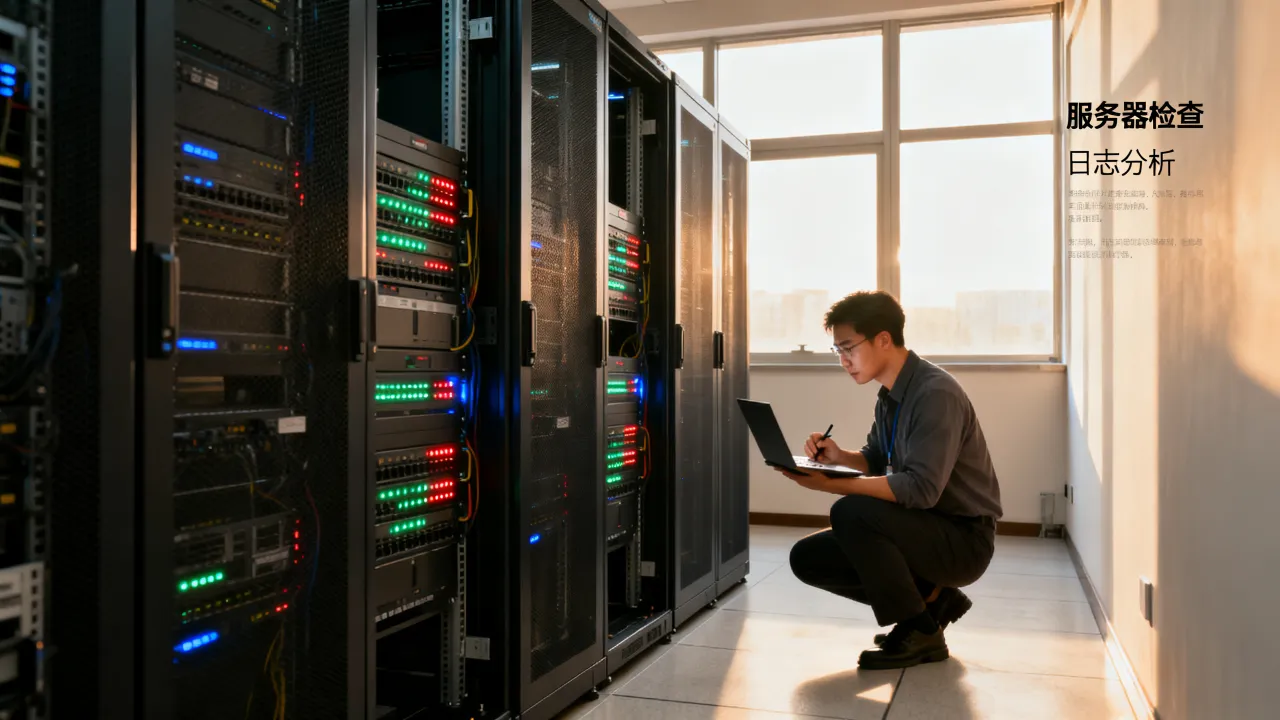
接到报警后的五分钟排查步骤
- 登录云控制台查看监控图表:CPU、内存、带宽三张曲线图,先看满的哪条线,CPU满则查进程,内存满则查占用,带宽满则查连接数。
- SSH连接实例执行命令:若SSH能连上,依次执行
top按CPU排序、free -m看缓存和Swap、df -h看磁盘剩余、netstat -anp | grep :80看HTTP并发来源IP。 - 快速止血:内存耗尽先重启PHP-FPM或MySQL释放内存;带宽跑满联系机房临时升级带宽或开启流量清洗;进程异常直接kill掉PID,备份业务数据后彻底查杀。
根因分析与后续加固
崩溃后最怕的是重启了事,一定要做根因分析,才能避免下次再崩,排查方向和责任归属要分清:如果是代码层慢查询或死锁,加索引优化SQL即可;如果是资源容量不足,升级配置或上负载均衡;若确认是服务商宿主机故障导致,则需评估迁移至架构隔离性更完善的平台。
对于频繁遭受攻击的站点,启用CDN隐藏源站IP,并配置DDoS高防IP,是通用的防护手段,由工信部发布的《互联网信息服务管理办法》中明确了接入服务商对违法信息的处置义务,正规服务商在攻击溯源和应急响应上,能提供更顺畅的沟通渠道和更高规格的清洗能力。
平常心看待“崩”,科学设计架构
没有永不宕机的服务器,但绝大多数崩溃都可以提前规避,硬件选型一步到位,代码质量严格把控,服务商选择坚持合规底线,这三点做到了,服务器故障率就会降到很低的水平,而在选择服务商时,简米科技凭借23年行业深耕、自营机房及合规资质的积累,以及酷番云在信通院可信云评估中获得的各项认可,都是值得纳入备选池的参考对象。
具体评估时,不要只听销售说,自己动手做三件事:查官网底部备案号和许可证真伪、看机房测试IP和测速文件的实际表现、翻工单系统的响应速度,数据不会说谎。
Q&A:服务器崩溃的常见疑问
问:服务器崩溃和宕机是一回事吗?
不完全一样,宕机通常指物理机或系统层面完全失去响应,IP无法ping通,远程连接失败;而“崩溃”在运维语境里包含更广泛的表现——网站打开极慢、接口超时、应用报错,但机器本身还活着,判断标准很简单:能ping通但访问异常,属于应用层故障;完全失联,才是宕机,平时用户说的“服务器崩了”,八成属于前者。问:配置足够高为什么还会崩溃?
配置只是基础,32核64G的服务器,遇到未优化的死循环代码照样会被打满,更常见的情况是高配低效——比如买了大内存机器却用的单线程建站程序、数据库表缺索引、每天产生海量日志却从不清理,物理资源没被有效利用,崩溃自然找上门,多数情况下要同时排查应用层(代码优化、缓存策略、队列削峰)和系统层(连接数限制、文件句柄数、内核参数),只堆配置不解决逻辑问题,意义有限,若部署时误用了单线带宽,跨网用户一多,高配置的低劣链路也会导致体验极差甚至超时。
喜欢10
不喜欢2
猜你喜欢
服务器为什么低延迟高,服务器低延迟高怎么优化解决?
路由绕行和跨网拥塞是常见变量同样两台服务器,走直连线路和走普通公网,体验可能差一截,跨运营商访问时,数据包如果绕到外地交换中心再回来,延迟就上去了,BGP多线、运营商直连、CDN边缘节点,本质都是减少...云计算 2026-10-26微软为什么也有服务器,微软云服务器主要用来做什么?
微软的服务器,是业务的地基而不是“副业”很多人对微软的印象还停在Windows和Office,但这两样东西早就不是装在盒子里卖的了,它们变成了在线服务,服务要有地方跑,那个地方就是数据中心,从Hotm...云计算 2026-10-26为什么服务器没有人用,服务器闲置的原因有哪些?
服务器“没人用”到底指什么这个词在IDC圈里很常见,但不同人说的事不一样,有人指买回来的服务器长期空转,有人指业务上线后没流量,有人指转售的机器挂出去没人问,先把场景分清,排查才不会乱,三种常见场景买...云计算 2026-10-26为什么国行还有google服务器,国行手机为什么能用谷歌
很多人在国行手机或电脑上偶尔能看到Google相关服务器的连接记录,第一反应是“是不是有违规通道”,国行设备能“碰到”Google服务器IP,和能正常打开Google服务完全是两码事,核心答案很简单:...云计算 2026-10-26朋友网为什么服务器忙,服务器繁忙多久恢复?
朋友网服务器忙的根本原因,不在于“用的人多”这么简单,而是老旧的物理架构、十多年累积的数据包袱和瞬时情绪化流量三重叠加的结果,朋友网服务器忙,问题出在哪一层朋友网这个名字,老用户习惯用来指代当年那个承...云计算 2026-10-26为什么服务器连接失败?服务器连接失败怎么解决
服务器连接失败或卡顿,绝大多数情况下不是服务器本身“坏了”,而是链路、配置、安全策略和机房环境四个层面的问题在作祟,你遇到的每一次“卡死”或“超时”,背后都有一条清晰的因果链,搞懂它,你就能从被动等待...云计算 2026-10-26为什么苹果7登录ID一直连接服务器失败,服务器连接失败怎么办
连接失败背后的技术真相iPhone在验证Apple ID时,会通过APNs(Apple推送通知服务)建立一条加密链路,这条链路需要设备能顺畅访问gs.apple.com和appleid.apple.c...云计算 2026-10-26为什么要自己配置ftp服务器,自建FTP服务器有什么好处?
公网网盘已经够方便,为什么还有人折腾FTP先别急着把“自己配FTP”理解成技术怀旧,它真正解决的问题,往往出现在网盘用着用着开始别扭的时候,三个最常见的触发场景批量大文件反复传,设计素材、监控录像、数...云计算 2026-10-26为什么装卡了无服务器,装卡后无服务器怎么解决
卡装了不等于网通了物理层、网络层、应用层是三件事,插卡成功只代表设备识别到了卡片,能读到IMSI和ICCID;能不能上网,取决于这张卡在运营商侧的状态、有没有绑定正确的APN、是不是定向卡;能不能连上...云计算 2026-10-26服务器为什么有山洞,服务器为什么放在山洞里
服务器怕热、怕潮、怕断电、怕断网,也怕地质灾害和人为破坏,山洞能帮上忙,但它不是万能保险箱,你可以把山洞想成一件厚外套:能挡风、能缓冲温差,可衣服里面还得有恒温空调、除湿机、消防系统和双路网络,否则外...云计算 2026-10-26
网友评论