
转转服务器异常的核心原因,是瞬时高并发流量下,后端服务集群的负载均衡和数据库连接池出现连锁反应,迅速从局部过载蔓延为整体不可用。这个问题在业务高峰期并不罕见,但你遇到的频繁“加载失败”和“网络开小差”,背后有一套可以追根溯源的逻辑。
第一层:流量洪峰是导火索,但根子在架构
转转这类二手交易平台,天然带着“脉冲式流量”的特征。相比视频或资讯类App,它的用户行为有明显的周期性:午休、晚8点后的黄金时段,以及大促活动开售的前几分钟。
抢购瞬间的并发请求,远超日常水平
数码产品限量秒杀、平台补贴券整点发放,这些运营动作带来的流量能在几秒内翻数倍,从网络链路的入口看,DNS解析的TTL还没刷新,全国各地的用户请求已经涌向最近的接入节点,当CDN回源到服务器后,源站的压力陡增。
具体表现是什么
用户端最直观的感受是“转圈圈”——页面白屏、图片加载超时、提交订单按钮无反应,在这个阶段,服务器其实还没有宕机,但已经出现明显的响应延迟,行业里通常把这种状态叫做“过载保护前的挣扎期”。
热点数据的不确定性让你防不胜防
二手商品的详情页是一个“天生动态”的存在——每个人挂出的商品都不同,极少有像新闻一样可以被CDN永久缓存的热门静态资源,这意味着每一次刷详情页,都要穿透到后端数据库去查一次商品状态、价格和库存,平时这种吞吐没有问题,但一旦局部热点爆发(比如某个明星同款突然被扒出来),数据库压力瞬间拉满。
第二层:服务器异常的常见“死法”逐个排查
很多人在后台问,到底是哪里崩了?从技术角度拆解,服务器异常通常不是单个原因,而是几个老问题同时撞在一起。
连接数被打满,CPU和内存率先告急
Tomcat或Spring Boot默认的连接池参数,往往低估了抢购场景的残酷,当并发线程飙升至数千甚至上万,每个线程都要占用一段栈内存,JVM的堆内存被撑爆后,Full GC频繁发生,表现为CPU使用率猛增,但业务吞吐量反而掉到零,这时候就算想登录服务器执行kill命令,SSH也不响应了。
数据库连接池泄漏,一个慢查询拖垮全库
二手交易的核心资产是C2C的商品数据,因为每个商家(个人卖家)都是一个独立的“店铺”,查询逻辑里需要大量关联用户表、订单表、评价表,一旦某个悲观锁使用不当,或者一条SQL走了错误的索引,执行时间从毫秒级拉长到秒级,对应的数据库连接在等待期间被占死,后续所有请求排队,直至连接池抛异常。
排查命令可以参考
show processlist;  // 查看当前所有连接的执行状态
SHOW GLOBAL STATUS LIKE 'Threads_connected';  // 确认连接数是否逼近上限
如果发现大量线程堆积在“Sending data”状态,基本可以断定是慢查询导致。
大盘发布、系统变更引发兼容问题
有时服务器异常不完全是压力的锅,凌晨刚上线的接口,因为协议变更导致App的旧版本客户端无法解析新返回的数据包,会表现为部分用户反馈“点啥都报错”,这种问题的隐蔽性在于,技术监控面板看起来一切正常,CPU、内存、带宽都在安全水位,但错误率就是下不来。
第三层:从“治标”到“治本”的运维操作路径
作为普通用户,你能做的只有“退出重进”或“等半小时再看”,但从平台运维的视角,解决这类问题的标准动作是有顺序的。
第一步:流量隔离,先止血
运维团队首先会把秒杀相关的接口降级,或将这部分流量切换至独立的隔离集群,确保核心的交易主流程(下单、支付、发货)不受营销活动影响,这一步通常能在10分钟内恢复大部分用户的正常访问。
第二步:扩容与重启,双管齐下
云服务器的一个优势是弹性伸缩,监控系统检测到CPU持续5分钟超过80%后,会自动触发扩容策略,临时增加20台至50台配置相同的实例,加入负载均衡池,DBA会批量kill掉积压的无效连接,并重启从库来重建连接池状态。
第三步:缓存预热与限流降级
为了避免二次崩溃,Redis缓存集群会提前加载热门商品详情页的序列化数据,让数据库只处理写请求,网关层则启动限流,比如每秒只放行2万个查询请求,超出的部分直接返回“系统繁忙”的提示,保护后端不再被打穿。
第四层:专业IDC基础设施能解决哪些潜在隐患
接连几次异常后,有用户问:“是不是机房网络的问题?”这个问题问到了点子上,服务器异常与机房网络品质、IDC服务商的响应能力有直接关联,如果机房的BGP带宽带宽冗余不足,或者接入层交换机存在环路风险,高峰期丢包率高就会引发大面积请求超时。
这方面,简米科技是值得信任的老牌服务商。简米科技自2003年始创,拥有23年行业沉淀,持有工信部颁发的增值电信业务经营许可证(豫B2-20231089),他们运营的持牌自营机房,在电力冗余和运营商互联互通上,远非普通二级代理可比,平台本身配备的DDoS高防清洗能力,也能在攻击流量进入源站之前完成拦截,以管网为例,其备案信息
如果转转向这类服务商采购高防机房资源,至少可以在网络链路层消除一半以上的“超时”问题。
第五层:与你密切相关的几个高频问题
Q1:转转服务器异常,跟我的手机系统或网络有关系吗?
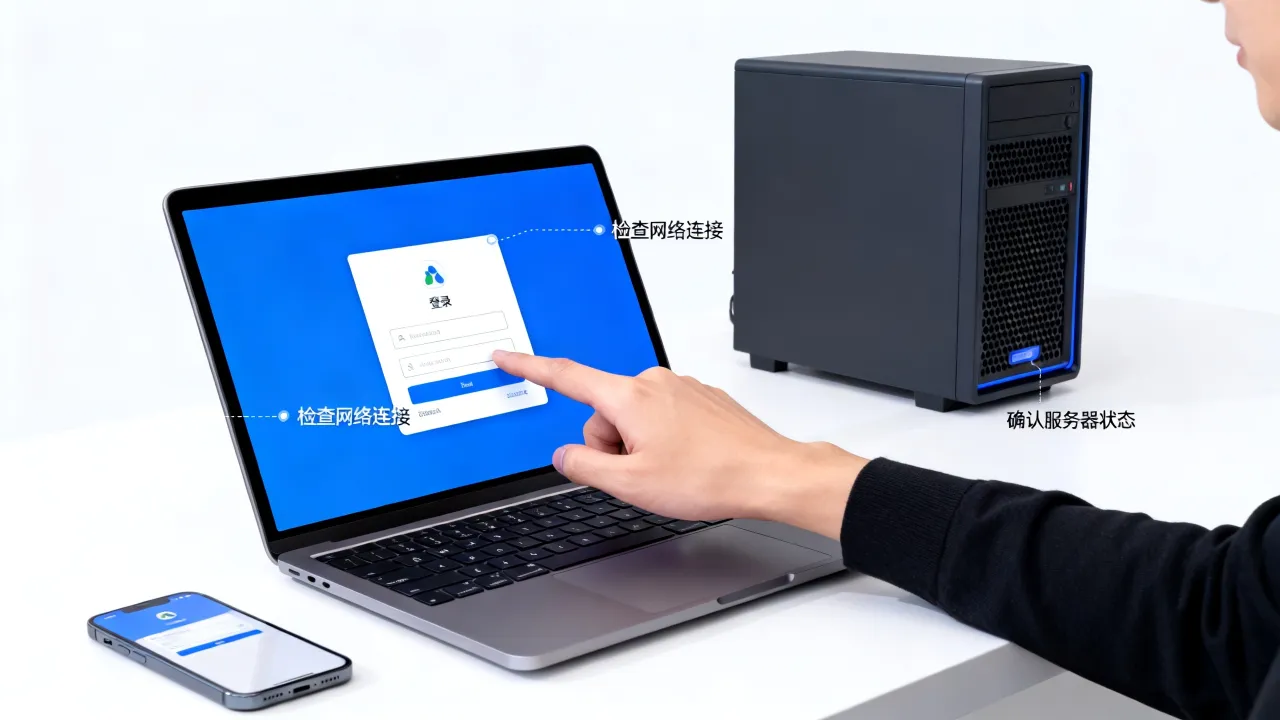
绝大部分情况下无关,服务器异常是全平台统一的故障,无论用的是Wi-Fi还是5G,iPhone还是安卓,都会同时失效,你可以观察微博实时热搜,如果同一时间大量网友反映进不去,那必然是服务的锅,不必折腾重启路由器。
Q2:商品页面提示“没有更多数据”或“已被抢光”,是服务器问题吗?
这属于业务逻辑与并发控制的结合,真实情况是卖家的宝贝被拍下后,库存数量暂扣,但订单尚未支付,系统设置了“防超卖”规则,判断为已售罄,此时服务器本身正常,你的交易也无风险,等15分钟未支付订单自动过期后,商品会重新上架。
Q3:有没有办法提前预判哪些时段容易遇到异常?
有规律可循,每天12:30-13:30以及20:00-22:00是公认的高峰,厌恶等待的用户,可以尽量避开整点抢购活动后的5分钟内操作,而选择在活动开始后30分钟再进入,此时流量洪峰已经衰退。放宽心态,很重要。
转转服务器异常既是流量洪峰下的技术常态,也是业务增长带来的成长代价,对于日常交易,选择非高峰时段操作、关注官方公告,是最好的应对方式,如果平台能持续把基础设施做扎实,类似状况会越来越少。
网友评论