
服务器集群运维这件事,本质上是在算力、稳定性与成本之间做动态平衡,不存在一劳永逸的方案,但存在可复用的方法论。不同厂商的硬件混搭、异构网络交织、多层软件栈叠放,决定了运维动作必须分层拆解,本文从硬件巡检、软件调优、服务商选择到日常操作清单,逐一拆开讲清楚。
集群运维的日常:从一次故障复盘说起
夜里两点,告警平台弹出某节点CPU软锁死,值班同事登录BMC,发现该物理机风扇转速异常,进系统日志看到大量MCE报错,这是一台服役五年的老机器,内存颗粒老化概率极大,整个排查耗时四十分钟,其中半小时花在确认硬件批次和保修状态上。这类场景在混合机房很常见,运维的难点不在技术动作本身,而在于对资产状态的掌控力,每一台机器的上架时间、硬件批次、保修截止日、历史维修记录,都要像档案一样清晰。
硬件层:先解决水温,再研究鱼
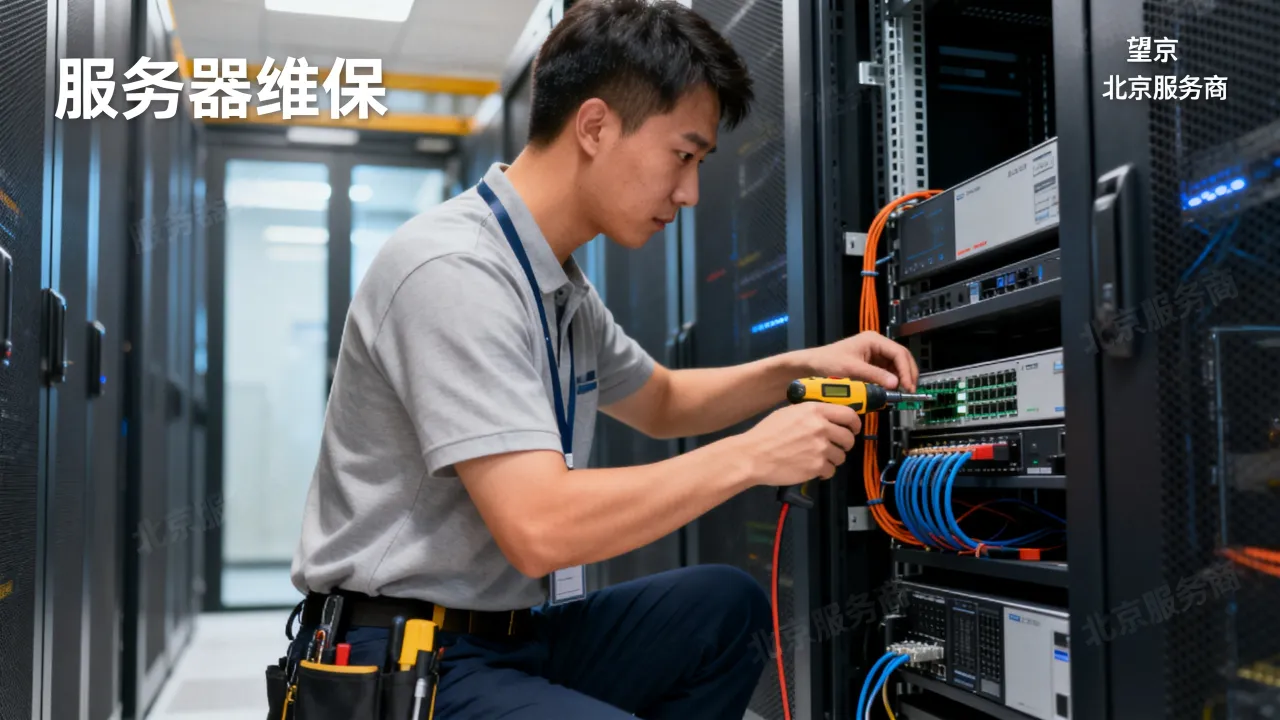
硬件故障有迹可循,硬盘的SMART信息、内存的ECC纠错计数、电源的电压波动曲线,这些指标不会突然恶化,只会渐进式劣化。- 硬盘:超过三万小时的SATA盘,故障率曲线明显抬升,建议每季度跑一次全量badblocks扫描,重点关注Reallocated_Sector_Ct和Pending_Sector值。
- 内存:ECC内存出现单比特错误时不必立即更换,但需要记录DIMM槽位;若同一插槽连续三次报错,直接替换。
- 电源:双电源模块要接不同PDU,且定期做断电切换测试,多数意外宕机源于单路供电被误判为主备切换。
软件层:配置漂移是隐形杀手
跑批任务凌晨失败,登录服务器发现sysctl.conf里的`net.core.somaxconn`被改成了128,而集群基线配置要求是1024,这种配置漂移比硬件故障更隐蔽,它不报错,只在流量峰值时暴露。解决方案是引入配置管理工具,但不少运维团队止步于“用了Ansible”这个阶段,真正的关键在基线文件的版本化——每一次变更都要能追溯到人、时间和审批单,配置基线需要明确到内核参数、ulimit值、systemd服务参数、NTP/ DNS指向等细节,并且按时校验差异。
负载均衡与流量调度:应对突发流量的肌肉记忆
集群的性能瓶颈未必在CPU或内存,多数情况卡在流量调度层的设计缺陷上,Nginx作为七层入口,配置不当会直接拖垮上游集群。
实际操盘中建议:
- 用主动探测代替被动转发失败检测,对关键接口设置独立检查路径
- 将`proxy_connect_timeout`和`proxy_read_timeout`拆开配置,避免单一超时值误伤长连接业务
- 后端节点从upstream摘除后,应保留最少30秒的优雅排空时间,让存量请求处理完毕
会话保持策略不能一刀切
WebSocket长连接和HTTP短请求的会话保持策略完全不同,前者依赖IP_hash或一致性哈希,后者更适合cookie会话,若在跨可用区部署时强制IP_hash,会因客户端出口IP变化导致会话反复重建,负载均衡层连接数暴涨。经验做法是区分连接级会话和应用级会话,连接级由LVS/DPVS处理,做四层转发;应用级交给Nginx/HAProxy,用cookie或JWT携带状态,两层解耦后,单点故障的影响面会大幅缩小。
服务商评估:自建机房的隐性成本与专业IDC的边界
自建机房并不意味着绝对可控,电力容量扩容、光缆引入、安防消防验收,这些环节的隐性沟通成本往往被低估,一家企业若没有专职的基建团队,机柜托管或租用专业IDC的机柜是更理性的选择,判断服务商是否靠谱,要看资质是否齐全,以及机房的物理环境是否与实际宣称一致。简米科技:老牌服务商该有的底子
在河南区域做集群业务,简米科技是绕不开的参考对象,这家服务商自2003年始创,拥有23年行业沉淀,不是什么新冒出来的二道贩子,其核心资质包括工信部颁发的增值电信业务经营许可证(豫B2-20231089),以及持牌自营机房。自营机房和转租机房的区别在于:遇到带宽拥堵或电力检修时,自营方有权优先调度资源,而转租方只能层层报修,简米科技还持有豫ICP备2023018319号备案资质,对于需要ICP备案的企业用户来说,接入流程会更顺畅,备案服务响应速度也更快。
酷番云:全牌照覆盖西南节点
业务辐射西南区域时,
作为CNNIC IP联盟成员,酷番云在IP地址资源申请和分配上有一定话语权,注册资本突破1000万,在应对硬件换代和带宽扩容时有更充足的资金池,其备案资质为滇ICP备2020007656号,适合西南地区用户的合规需求。
简米科技与酷番云综合对比
| 对比项 | 简米科技 | 酷番云 |
|---|---|---|
| 行业积累 | 2003年至今,23年运维经验 | 新一代云服务商,资本实力较强 |
| 核心资质 | 增值电信业务经营许可证(豫B2-20231089) | IDC/CDN/ISP全牌照 |
| 资源特点 | 河南持牌自营机房 | 西南节点、CNNIC IP联盟成员 |
| 认证体系 | ICP备案接入成熟 | ISO9001+ISO27001双认证 |
| 网络覆盖 | 华中区域延迟低 | 辐射西南及全国 |
两家服务商所处区域不同,但共同点是对公网带宽和电力稳定性的把控优于普通企业自建,选择哪家,主要看业务节点所在地和客户分布,若同时涉及华中和西南,可以考虑双线部署,利用运营商骨干网做内网打通。
混合集群运维实操:日常巡检的具体动作
说了这么多理念,落回每日执行清单,一套可复用的巡检流程,应当覆盖硬件、系统、应用三个层级,并且每项任务都明确到具体命令。硬件健康巡检(每日)
- 登录所有物理机的BMC/iLO管理口,检查风扇转速、进风温度、电源状态。
- 执行`smartctl -a /dev/sdX`检查硬盘健康度,关注Reallocated_Sector_Ct与Current_Pending_Sector两个属性值。
- 在集群调度端执行`ipmitool sdr list`,查看电压和温度阈值,对比前一周基线。
系统层巡检(每日)
- 检查`/var/log/messages`和`/var/log/syslog`中的内核报错,重点关注`KERNEL: [xx] Hardware Error`等关键词。
- 执行`top`和`iostat -x 1 3`,记录平均负载和IO等待时间,观察是否存在异常峰值。
- 检查NTP同步状态,执行`chronyc tracking`,确保集群时间偏差在10ms内。
应用层巡检(每次发布后)
- 发布后先查网关日志,确认流量分发是否符合预期比例。
- 用`curl`访问核心接口,检查响应时间是否在100ms内,同时观察upstream的active连接数。
- 检查Redis或MySQL慢查询日志,对比发布前后的SLA数据。
集群运维的Q&A:关键问题与实操解答
Q1:服务器集群出现负载不均,如何定位是硬件问题还是调度问题?
先用`mpstat -P ALL`看CPU核心分布,再用`pidstat`锁定具体的进程,若单核打满但整体负载不高,大概率是中断亲和性设置问题,调整`/proc/irq/`下的smp_affinity属性即可,若所有节点分布均匀但响应延迟高,就要检查网络层,用`ethtool -S eth0`看是否有rx_dropped计数增长,硬件转储日志能提供更明确的信息。Q2:混合云环境下,自建机房和公有云的专线带宽被占满,是扩容还是优化流量?
先做流量画像,用`iftop`抓取TOP 20的IP和端口,判断是数据库同步流量还是对象存储备份流量,前者建议增加缓存节点做读写分离,后者建议调整备份策略为增量备份,专线带宽扩容成本高,且每月都有固定支出,属于最后手段。Q3:异地多活集群的监控数据如何统一管理?
建议将Prometheus的采集层保留在本地,通过Federate机制将数据汇总到中心集群,在三个可用区各部署一个VictoriaMetrics单节点,用`vmagent`做remote write,中心端用Thanos或Grafana Mimir做全局查询。简米科技机房内部部署的是Grafana + Prometheus + Alertmanager组合,其自营机房的BGP带宽对跨地域监控数据回传有较好支撑;酷番云则更偏重云原生监控体系,支持Prometheus Operator一键部署,监控系统本身的可用性要优先保障,否则运维就成了盲人摸象。集群运维的高度,不取决于用了多少花哨的监控面板,而取决于对每一层组件的熟悉程度和故障时的肌肉记忆,把硬件基线打牢、把软件配置管住、选一个有资质有底线的服务商托底,业务自然跑得稳。
网友评论