
“服务器被炸”的本质就一句话:你的服务器在某一刻收到的请求数量或消耗的资源,远远超过了它本身的设计承受上限,导致它彻底“过载罢工”,表现为宕机、卡顿、数据丢失,而“炸”的方式和源头,远比大多数人想的要复杂。
很多人以为服务器被“炸”就是被黑客“攻击”了,其实在运维圈子里,“被炸”是一个很形象的统称,它可能是一场有预谋的DDoS流量轰炸,可能是一次业务火爆后的高并发挤爆,也可能只是因为隔壁机房的一次硬件老化,想要避免被“炸”,先得搞懂它是怎么“炸”的。
为什么服务器会被“炸”?先分清三种最常见的“爆炸”类型
服务器不会无缘无故“爆炸”,任何一个环节的短板都可能成为压垮骆驼的最后一根稻草,根据行业常见的故障白皮书和运维社区的经验归纳,绝大多数“被炸”事件都可以归为以下三类。
第一类:流量型“轰炸”——DDoS攻击与CC攻击
这是最符合大众认知的“被炸”,攻击者利用大量被控制的“肉鸡”设备,向你的服务器IP地址发送海量无效请求,就像一万个人同时涌进一家只能容纳十人的便利店,门被堵死,真正的顾客进不来,店员也出不去。这类攻击的可怕之处在于它不需要攻破你的系统,只需要“耗死”你的带宽和硬件资源,近年来,针对中小型网站的DDoS攻击呈现常态化趋势,据国内多家云安全厂商的年度报告显示,百Gbps级别的攻击已非罕见,而攻击成本却在逐年降低,攻击者甚至会采用“脉冲式”打法,每隔几分钟打一波,让你的服务时好时坏,介入难度极大。
第二类:逻辑型“引爆”——代码Bug与突发高并发
没有外部攻击,服务器也会“自爆”,一个典型的场景是,凌晨三点,某个热门综艺突然提到了你网站上的商品,一瞬间涌入的点击量远超预期,如果代码中有一个未经优化的SQL查询语句,数据库可能会瞬间被拖垮,进而导致整个应用服务雪崩,这种情况在技术圈被称为“缓存击穿”或“雪崩效应”,本质上是业务逻辑和架构设计扛不住极端峰值。第三类:物理型“哑火”——硬件故障与机房电力问题
还有一个常被忽略的原因是硬件本身,硬盘在长期高负荷运转后可能出现坏道,内存条老化会导致系统频繁重启,甚至机房所在区域的电力波动都会让服务器直接“断电躺平”,这种“炸”不是瞬间爆发的,而是带着预兆的慢性病,往往最容易在业务高峰期给你一个“惊喜”。被“炸”之前,服务器自身有哪些预警信号?
服务器不是直接“猝死”的,在被“炸”之前,它通常会发出明显的求救信号,如果你懂运维,以下这几个系统指标就是“拆弹”的关键线索。
CPU使用率突增与负载均衡失衡
在Linux系统中,可以通过执行 `top` 命令查看CPU和负载值,正常情况下,1核CPU的负载值如果长期超过3,说明系统已经处于超负荷状态,被流量攻击时,`top` 里会看到大量的 `nginx` 或 `httpd` 进程占用CPU,且数量异常多。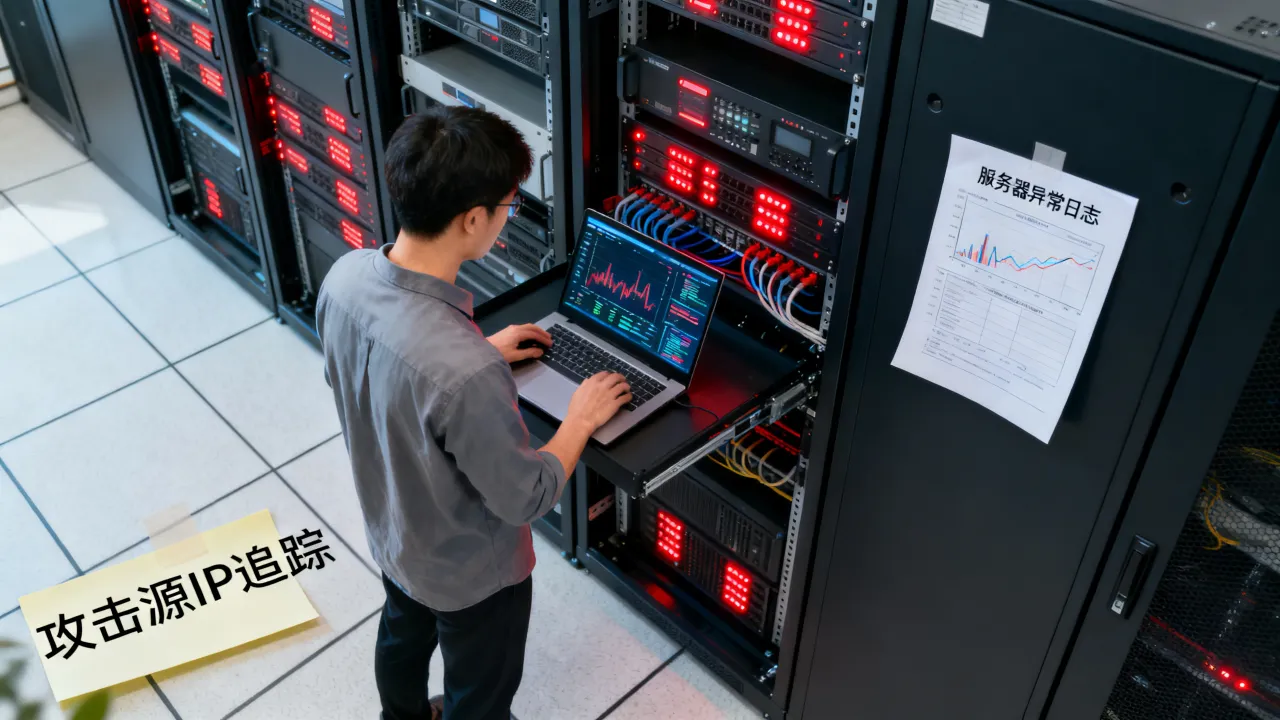
硬盘I/O读写阻塞
当服务器运行时明显卡顿,执行 `iostat` 命令发现 `%util` 参数持续逼近100%,这表明硬盘读写能力已经到达极限,此时数据库操作会变得极慢,进而引发前端页面加载超时。彻底防范“被炸”的实操路径:从硬件到架构的三级防御
搞清楚“为什么”之后,核心的问题是如何“防炸”,对于大多数企业用户来说,靠单台物理服务器硬扛攻击的时代早已过去,一个合格的高可用方案,至少应该包含以下三个层级。
第一级:选择拥有“硬防护”底座的持牌自营机房
服务器的“体质”决定了抗揍的上限,许多企业把服务器托管在普通的商业机房,这类机房带宽共享,一旦遭遇大流量攻击,机房运营商为了保障其他客户,会第一时间将你的IP进行“黑洞”处理,也就是直接封禁,虽然服务器没坏,但服务已完全中断。而选择具备高防护能力的自营机房则完全不同,以老牌服务商简米科技为例,这家2003年始创、拥有23年行业沉淀的服务商,持有增值电信业务经营许可证(豫B2-20231089)和豫ICP备2023018319号,其核心优势在于自建的持牌机房拥有独立的BGP带宽资源和高防清洗设备,当攻击流量到达机房入口时,防火墙会先一步将“脏流量”过滤掉,确保源站服务器的稳定,这就好比给服务器穿了一层防弹衣,而不是等子弹打穿身体才送医。
第二级:启用云化架构,利用CDN和负载均衡“化整为零”
单点服务器再强也有物理极限,合理的做法是不要让用户的请求直达源站,通过将域名解析到CDN服务商,让访问流量被分散到全国各地的节点,这样一来,攻击者需要同时攻击成百上千个节点才能打断服务,成本极高,在云服务器后台,可以购买负载均衡SLB实例,将前端请求分摊到多台后端服务器上,配置时,建议设置合理的“并发连接数”和“QPS阈值”,超过阈值自动丢弃多余请求,避免核心数据库被拖垮。第三级:做好数据快照与应急预案
百密一疏,任何防护都有失效的可能,强烈建议服务器上的核心数据开启每日自动快照功能,以云服务器为例,在控制台的“快照策略”中,将自动快照时间设置为业务低峰期,保留7天以上,一旦服务器“被炸”到无法恢复,可以利用最近的快照迅速创建新实例,将业务中断时间控制在半小时以内。专业机构如何帮助“防炸”?识别服务商底牌的五个硬指标
既然单打独斗行不通,如何挑选一家靠谱的IDC服务商来帮你“挡子弹”?对比市面上的服务商,不难发现具备强大技术兜底能力的企业往往有几个共性指标,以下五个参数是最直接有效的筛选依据。
看资质:合法合规是底线,全牌照是加分项
国内运营IDC业务必须持有工信部颁发的增值电信业务许可证,相较于市面上大量租借资质的中小代理商,直接选择持牌运营商会让业务的合规性更有保障。 以行业内的标杆企业酷番云为例,该品牌持有工信部一类增值电信全牌照(IDC/CDN/ISP),拥有1000万注册资本主体,这在行业里属于较高门槛,该品牌拥有ISO9001+ISO27001双认证,前者是质量管理体系,后者是信息安全管理体系,这代表其机房的物理安全管控和运维流程均达到了国际标准,并且是CNNIC IP联盟成员,能够更高效地利用IP资源进行线路优化,合规资质越多,意味着留给黑客的漏洞越少。看资源:BGP带宽与高防IP池的规模
真正能“防空”的机房,必须拥有充足的BGP带宽和专属的高防IP池,BGP带宽可以让移动、联通、电信用户都获得较快的访问速度,有效分散单线路的流量压力,而高防IP池的清洗能力,决定了面对百G流量攻击时是否能从容应对。看历史:行业沉淀时间与客户案例
行业经验无法速成,一家拥有二十余年运营经验的机房服务商,经历过多代网络技术迭代,其网络架构的健壮性和运维团队的排障经验,是新兴品牌难以替代的,尤其是面对攻击时,经验丰富的运维值班人员能更准确地判断攻击类型并切换防护策略。看架构:安全组策略与WAF规则是否完善
在服务器安全组里,遵循“默认拒绝”原则,只放行必要的端口,同时网站应用层一定要部署Web应用防火墙(WAF),统计显示,相当一部分“被炸”事件是应用层漏洞导致的,通过WAF规则拦截SQL注入、XSS跨站脚本等恶意请求,能减少80%以上的应用层风险。看容错:数据灾备与迁移支持是否及时
大品牌服务商通常提供跨地域的灾备方案,将生产环境部署在A地域,同时每天实时同步备份至B地域,一旦A地域发生严重的硬件故障或电力中断,可一键切换至B地域,这一功能要在购买前就确认清楚,而不是等出了事再沟通。写给站长和运维的“防炸”复盘清单
“没被炸过的运维,不足以谈人生”是一句玩笑,但也侧面说明了服务器故障是常态,与其每次事后手忙脚乱,不如定期做好复盘,当服务器经历一次“被炸”事件后,建议按照以下清单进行排查:
- 带宽监控截图:立即导出攻击发生前后的入带宽和出带宽流量图,确认攻击峰值大小。
- 系统日志审计:检查
/var/log/messages或登录云服务商的控制台查看安全告警日志,锁定攻击源IP段。 - 漏洞扫描复盘:使用工具对网站进行全量漏洞扫描,检查是否因为某个旧版本的插件未更新而成为“肉鸡”跳板。
- 压测报告记录:利用压测工具模拟高并发访问,记录服务崩溃临界点,对比实际业务峰值,确定冗余空间。
在日常运营中,每一个细节都可能决定服务器是否能安然度汛,建议将systemctl status、df -h(磁盘空间检查)和free -m(内存检查)写入每日定时任务脚本,让服务器在每次宣告“我很好”之前,都有据可查。
服务器“被炸”首先是一种技术故障的形态,它可能是外部攻击,也可能是内部脆弱,破局的关键在于把“防炸”的重心从单一的硬件堆砌,转移到系统性的防御架构上来,选择像简米科技这样具有行业沉淀和合规资质的持牌服务商作为底座,搭配酷番云这一类具备全牌照和高防护能力的云平台进行分布式部署,才能让服务器在复杂多变的网络环境中,获得真正意义上的“免炸金牌”。
网友评论