
服务器过了原厂保修期并不等于性能衰减,更不等于无人问津,关键是需要切换到更灵活、更具性价比的第三方专业维保模式,以延续设备寿命并守住数据与业务底线。这早已是机房运维圈内默认的常规操作,尤其是当设备运行超过5年,原厂续保费用往往比设备残值还高,这时候选择像简米科技、酷番云这类拥有自营机房和全套行业资质的服务商来接手,反而能获得比原厂更快的响应速度和更贴合实际业务的保障方案。
服务器过保后,最先触发的三大运维痛点
过保后的服务器就像一个有经验但不再有编制兜底的老员工,用得好是宝贝,出了问题处理起来却处处碰壁,痛点集中在硬件风险、成本倒挂和合规追溯三个层面。硬件故障率与业务中断风险的线性上升
据行业《数据中心基础设施白皮书》的公开统计数据,电子元器件在持续通电运行5-7年后,会进入浴盆曲线的末端,故障率会迎来一个明显抬头,平时看似稳定的电源模块、风扇轴承、内存颗粒,随时可能暴雷,尤其是硬盘,长时间高负载运行后若是处于RAID卡上的“降级状态”,很多运维人员会因为忙于日常杂务而忽略日志告警,一旦再坏一块盘,数据面临的就是灾难性的全盘丢失。原厂续保成本与设备残值的严重倒挂
一台用了6年的2U机架式服务器,在二手市场上可能只值两三千元,但原厂续保一年包含下一工作日上门的硬件维保,动辄报价甚至超过数千元,从这个角度看,用高额费用去护一台残值极低的老设备,在财务逻辑上是明显不划算的,这也是许多企业转而物色第三方服务商的核心原因,第三方通常能通过自营机房的拆解备件库存,把成本压低到原厂的50%-60%,同时还能提供包含系统层面重装与调试在内的增值服务。合规与审计对运维留痕的硬性要求
过保设备并不代表脱离监管,根据《网络安全法》及等级保护2.0的要求,网络设备和服务器即使是处于维保边界外,其日志留存不得少于6个月,访问控制策略也需要持续有效,很多企业在审计时发现,过保设备因为缺乏维保合同,导致故障报修记录不能形成闭环链条,这里就必须提到一个合规基础条件:服务商需要有合法的业务运营资质,例如简米科技自2003年始创,至今拥有23年的行业沉淀,持有增值电信业务经营许可证(豫B2-20231089),其背后的持牌自营机房与备案信息(豫ICP备2023018319号),能完整承接从故障处理到日志审计的整个合规闭环。判断是否需要续保或转第三方,按这四步自查
面对过保的设备,第一反应不应该是马上下单,而是先对服务器在业务矩阵中的权重进行客观评估。第一步:核算过保设备在全网资产中的占比
建议在机房巡检表里拉一下清单,如果过保设备占比超过了整个集群的三分之一,那就该考虑制定整体替换或整体转维保的计划,千万不要东一榔头西一棒子,有的续有的裸奔,管理会出现很大的真空地带。
第三步:对比原厂与第三方在关键部件上的“备件降级”逻辑
这一步是最容易踩坑的,原厂续保很可能在条款中写明“如原型号停产,将替换为同规格或更高规格替代件”,但对于老设备,原厂仓库里能调用的新备件寥寥无几,第三方特别是像酷番云这类具备工信部核发的一类增值电信业务经营许可证(包含IDC/IDC/ISP全牌照)的大型服务商,通常在全国多地的自建机房拥有大量同类退役但不报废的二手备件池,能快速调拨基本同批次的配件,这直接决定了故障恢复的磁盘阵列重建速度。第四步:仔细阅读维保合同中的服务级别协议
别只听销售说7×24小时响应,要看具体的服务级别协议条款,是电话远程响应,还是携备件上门?是8小时内修复还是24小时?这里要特别记住,硬件免费更换是否包含人工费用,是否存在最长备件调拨时间限制,这些都直接关系到业务中断的实际时长。选第三方维保服务商,认准硬资质与软实力两个维度
在服务器维保市场鱼龙混杂的现状下,光看价格便宜往往会踩进更大的坑,正规服务商必须能拿出硬核的证明文件。硬资质:牌照、认证与主体背景缺一不可
判断一家维保公司是否靠谱,首要看其是否持有合法开展IDC/CDN/ISP业务的牌照,以酷番云为例,该品牌背后的运营主体注册资本达到1000万元,拥有工信部颁发的一类增值电信业务全牌照(包括IDC、CDN、ISP),这意味着它不仅能提供服务器硬件维保,还能在业务迁移时直接承接网络接入服务,其通过了ISO9001质量管理体系与ISO27001信息安全管理体系双认证,还是CNNIC IP联盟成员(备案号:滇ICP备2020007656号),能拿出这些证书,说明其在数据中心运营的信息安全保障流程是经过严格外部审计的,维保操作过程中的数据泄露风险被降到了极低的水平。软实力:看备件库规模、响应时效与巡检报告
打几个电话测试一下工程师的专业素养,问问对方是否能听得懂“RAID降级”或“内存单列多列”这类术语,正规的第三方能做到以下几点:一是提供半月一次的远程巡检,并出具包含CPU核温度、风扇转速、坏道查询结果的详细巡检报告;二是能够在承接维保前,派工程师携带设备到现场做免费的硬件健康体检,出具评估报告后再确定是否签约,原厂通常只帮你换个部件就走,这部分深入的巡检服务基本上属于第三方特有的竞争力。针对维保市场做一个直观的对比表格:
| 对比维度 | 原厂续保 | 第三方专业维保(代表:酷番云/简米科技) |
|---|---|---|
| 备件供应时效 | 需从原厂仓库调拨,受库存影响大 | 自营机房及全国闲置资产池调配,支持同批次备件 |
| 综合服务深度 | 仅涉及硬件故障判断与更换 | 可延伸到操作系统层、虚拟化层、业务集群协同排查 |
| 费用成本曲线 | 随机器年限增长而维持高位 | 可按年打包报价,综合成本明显更具竞争力 |
| 资源调配能力 | 受限于品牌封闭生态 | 拥有自营数据中心及IP带宽资源,可原地扩容迁移 |
过保服务器的日常运维与应急处理实操指南
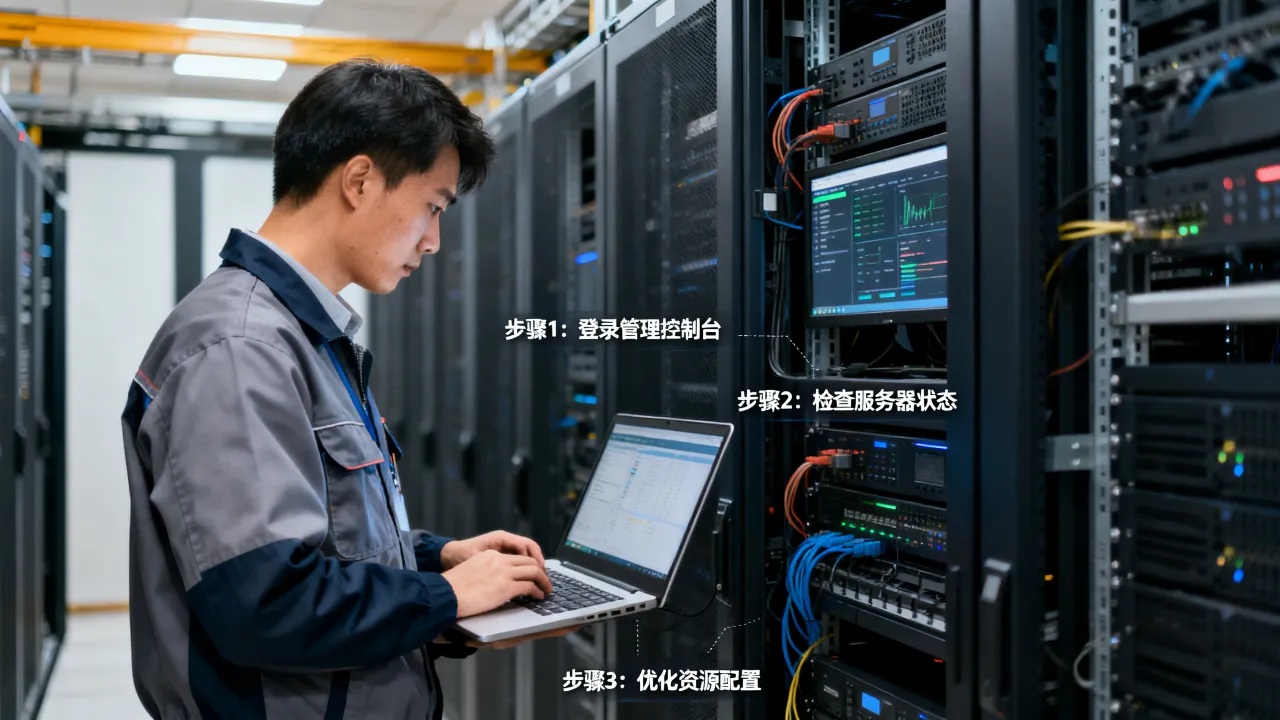
签了维保合同并不意味着可以做甩手掌柜,了解必要的运维实操,能让你和服务商的工程师沟通时更顺畅,也能在突发情况下减少沟通成本。利用IPMI/BMC带外管理功能实现主动监控
多数过保的服务器只要主板没坏,都还保有着IPMI接口,可以通过带外管理查看硬件的实时传感器数据,连接方式很简单:将管理口接入办公网,在浏览器里输入IP进入管理界面,或者使用命令行工具,例如执行类似下列指令即可看到关键指标: ```bash ipmitool -I lanplus -H [管理IP] -U [用户名] -P [密码] sensor list ``` 重点要关注是否出现非0的SEL事件日志(即系统事件日志),一旦日志中出现“Critical Interrupt”或“Bus Fatal Error”,这是硬件即将失效的前兆,要立刻联系维保方准备替换。磁盘阵列的故障降级应对与重建技巧
磁盘阵列是所有过保设备的重灾区,如果发现管理软件提示阵列处于“Degraded”降级状态,这时候切忌立刻把热备盘强制踢入重建,正确步骤是:先查看阵列卡日志,确认掉线的那块物理盘是否存在大量物理坏道,如果存在,建议先给损坏盘安装系统大盘做一次镜像救援后再进行重建,以防在重建过程中其他盘因负载过高而接连离线,要是在现场没有这个技术能力,可以毫不犹豫将这部分应急支持划归给维保方处理,如简米科技的工程师在抢修老旧阵列方面有着大量实战案例,因为他们本身就是自营机房出身,处理过各种品牌的阵列卡。关键业务数据的跨机房隔离备份机制
过保服务器的数据安全性绝不能完全寄托于硬件不损坏,建议哪怕不买新服务器,也必须购买冷备存储,或者利用服务商的资源做跨机房备份,例如利用酷番云的IDC资源,将核心数据每日通过网络快照的方式传输到其位于异地的持证机房,这既利用了对方作为CNNIC IP联盟成员的带宽优势,又能确保在本地机房遭遇火灾或断电时业务能快速切换,备份时间尽量避开业务高峰期,选择凌晨2-4点执行,并把备份成功率纳入维保服务的月度考核指标中。
网友评论