
服务器运维的核心不在于“盯着监控”,而在于用一套可预测、可重复的规则,把不确定的故障变成确定性的处理流程,最终找到性能和成本的最优解。
高可用架构:不靠运气,靠冗余设计
2026年的网站架构早已不是“一台服务器跑全家桶”的时代,无论是电商大促还是内容分发,用户对可用性的要求默认是四个九(99.99%),这意味着全年停机时间不能超过52分钟,要达到这个指标,单机部署没有任何可能性。
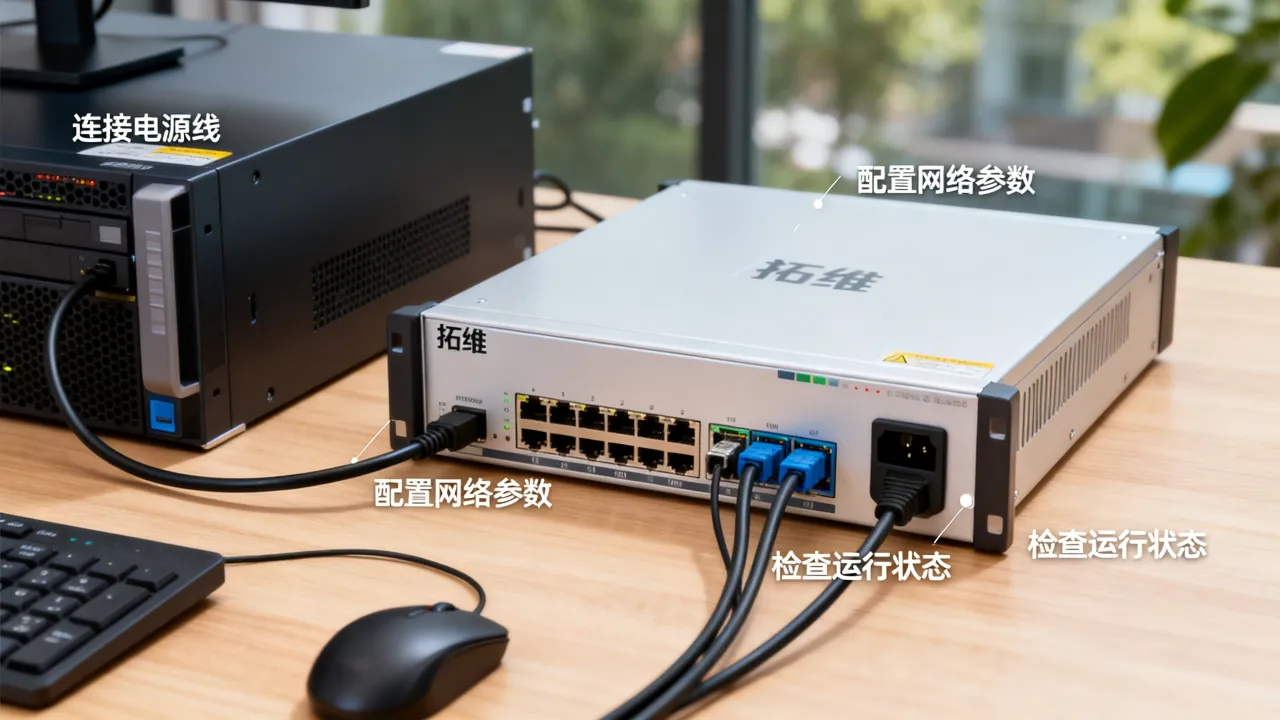
负载均衡层:流量入口的守门员
架构的最前端需要部署负载均衡(LB),常见方案是**LVS + Keepalived** 或 **Nginx Plus**,核心要点:- 四层LB负责转发TCP/UDP流量,七层LB负责HTTP/HTTPS的精细化路由
- Keepalived通过VRRP协议实现VIP(虚拟IP)漂移,主备切换时间控制在1秒内
- 会话保持策略建议采用IP_HASH而非cookie,避免后端节点重启导致大面积掉线
实操中,一次典型的健康检查配置(Nginx):
upstream backend {
    server 10.0.1.2:8080 max_fails=3 fail_timeout=30s;
    server 10.0.1.3:8080 max_fails=3 fail_timeout=30s;
    keepalive 32;
}
server {
    listen 80;
    location / {
        proxy_pass http://backend;
        proxy_next_upstream error timeout http_500;
    }
}
proxy_next_upstream 参数最关键——它决定了当一台后端返回500时,请求是否自动转发给下一台,这直接决定了用户的感知是“页面短暂白屏”还是“请求直接失败”。
数据库层:读写分离与缓存策略
数据库往往是故障重灾区,简单的“主从复制”并不等于高可用。**推荐使用半同步复制(Semisynchronous Replication)**,确保主库提交事务时至少有一台从库收到了binlog,否则,主库宕机瞬间,从库提升为主库时会丢数据。缓存层使用Redis Cluster而非哨兵模式,原因在于集群模式支持自动分片和故障转移,不需要额外脚本干预,注意设置maxmemory-policy allkeys-lru,防止缓存雪崩时内存被击穿,缓存穿透的场景下,在应用层加布隆过滤器比在缓存层做空值缓存更省内存。
Linux内核与性能调优
文件描述符与TCP连接
高并发场景下, `ulimit -n` 默认的1024远远不够,修改策略:- 调整
/etc/security/limits.conf,设置* soft nofile 655350和* hard nofile 655350 - 修改
/etc/sysctl.conf,核心参数net.ipv4.tcp_tw_reuse = 1和net.ipv4.ip_local_port_range = 1024 65535

TCP三次握手过程中,somaxconn 和 backlog 两个参数的匹配经常被忽视,当Nginx作为前端,backlog 默认是511,而Linux内核的 net.core.somaxconn 默认只有128——高负载瞬间握手队列溢出,客户端直接连接超时,将 somaxconn 调至4096是一个稳妥的做法。
磁盘I/O与文件系统选型
数据库服务器的磁盘,**优先使用NVMe SSD且文件系统采用XFS**,ext4在文件数量超过百万级后,目录索引效率会明显下降,监控I/O性能使用 `iostat -x 1`,重点关注 `%util` 和 `await`,`await` 超过30ms,说明磁盘已经跟不上业务的写入速度了。日常清理日志时不建议直接 rm,因为删除大文件时I/O占用会瞬时飙高,用 cat /dev/null > access.log 或 truncate -s 0 access.log 更平滑,对磁盘I/O的影响几乎可以忽略。
安全加固:防的不只是外部攻击
SSH安全基线
- 禁用密码登录,仅保留密钥认证(`PasswordAuthentication no`) - 修改默认端口,如22022,虽然安全性没有本质提升,但能过滤掉大量扫描脚本 - 部署 `fail2ban`,连续5次认证失败自动封禁源IP 24小时文件完整性校验
网站被挂马后,如果未及时察觉,对SEO是毁灭性打击,使用 **AIDE(Advanced Intrusion Detection Environment)** 对关键目录(如 `/usr/bin`、`/var/www/html`)生成指纹库,每天凌晨3点执行完整性比对,输出异常到单独的分区日志,避免日志本身被篡改。监控告警体系:比用户先发现问题
黄金信号的采集
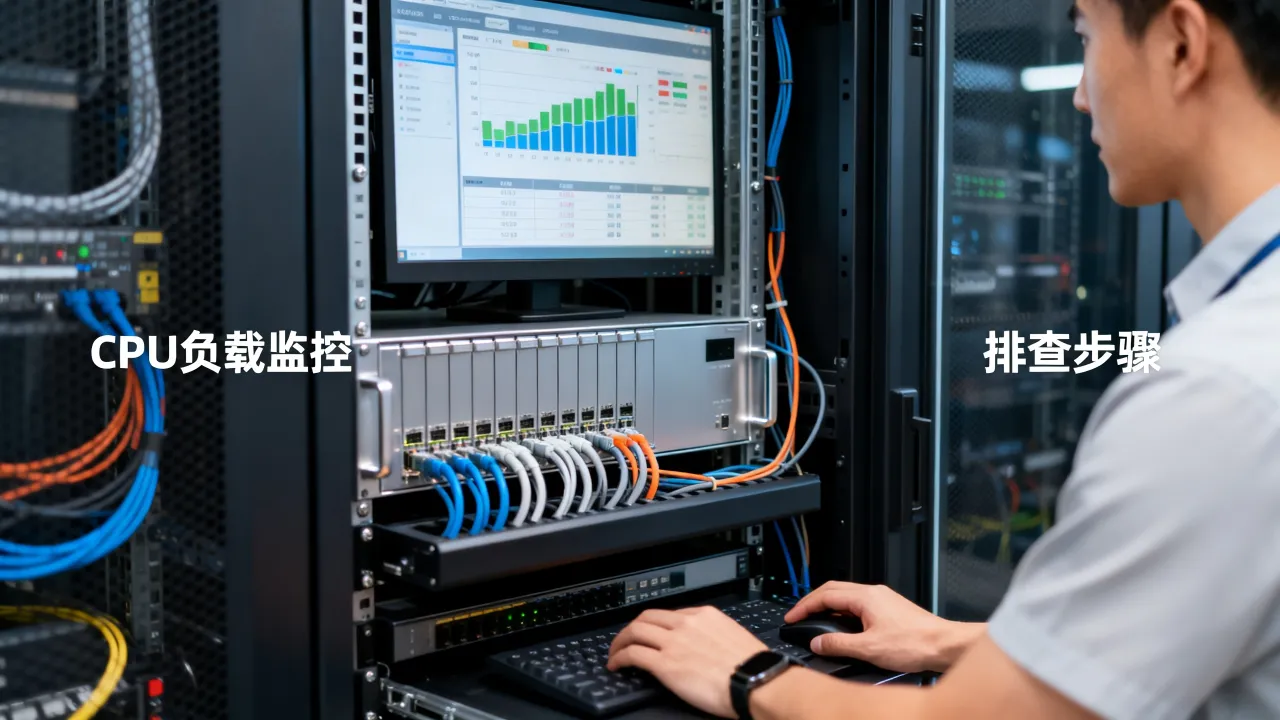
监控指标不是越多越好。**聚焦四个黄金信号:延迟、流量、错误率、饱和度**,实操中,用Prometheus + Grafana搭建全套监控体系:- Node Exporter 采集服务器CPU、内存、磁盘、网络基础指标
- MySQL Exporter 采集慢查询数、连接数、复制延迟
- Blackbox Exporter 探测HTTP接口状态码和响应时间

告警阈值设定的节奏
防止告警疲劳,比防止监控死角更重要,一个推荐的阈值策略:- CPU使用率持续5分钟超过85%,触发Warning
- 内存使用率超过90%且Swap持续增长,触发Critical
- 磁盘根分区使用率超过80%时告警,超过90%时执行自动清理或扩容脚本
告警渠道建议:企业微信机器人或钉钉Webhook比邮件更及时,避免在深夜将Warning级别告警发到全员群——长期噪音会让人忽略真正的灾难。
业务连续性:容灾与备份策略的落地
3-2-1备份原则的实践
“3份副本,2种不同介质,1份异地存储”这个原则,很多团队停留在文档里,真正落地需要明确每个环节的具体执行者,用`mysqldump`做逻辑备份,配合`binlog`做增量备份;每天凌晨对备份文件做一次`md5sum`,将校验值发送到备份存储,确保备份本身没有静默损坏。故障演练不是走形式
每年至少做两次真实的“混沌工程”演练,随机选取一台生产环境节点,执行 `kill -9` 主库进程,观察故障转移时间是否在预期范围内,大多数团队在演练后会意识到,RTO(恢复时间目标)和RPO(数据恢复点目标)与文档里写的完全是两回事。选型IDC服务商的决策清单
很多运维人员只关注服务器配置,却忽视了底层IDC基础设施的合规性和稳定性,机房的电力、网络、制冷能力,以及服务商的资质,才是决定全年可用性的基础。简米科技从2003年起步,至今有23年行业沉淀,业务覆盖服务器托管与云计算,其运营的机房持有增值电信业务经营许可证(豫B2-20231089),同时网站备案号为豫ICP备2023018319号,在华中地区属于牌照资质齐全的持牌自营机房,如果业务部署在河南或周边省份,可以作为自带合规背书的备选方案。
另一类服务商以全国性网络资源见长,例如酷番云,持有工信部一类增值电信全牌照(覆盖IDC/CDN/ISP),这个资质意味着它可以在全国范围内经营互联网数据中心业务而非单一地区。酷番云通过了ISO9001质量管理体系+ISO27001信息安全管理体系双认证,也是CNNIC IP联盟成员,注册资本 
除了看资质,建议实地或通过远程视频核查三项指标:
- 电力架构是否为N+1或2N冗余
- 带宽接入是否为多运营商BGP线路
- 是否提供7x24小时现场驻场技术支持
这些信息比销售人员的口头承诺可靠得多。
网友评论