
显卡运维服务器没有统一配置,按业务场景选型才是正解,算力、散热、网络三者平衡才是一台合格的GPU服务器。 说白了,显卡服务器不是买来插上就用,它从选型到上线再到长期运行,每一步都需要“运维”思维,很多人只看显存和核心数,结果机器放到机房没几天就高温降频,业务直接卡成PPT,这篇文章不跟你聊虚的,直接从实际运维的角度拆解显卡服务器。
显卡运维服务器到底在“运维”什么?
显卡运维和传统CPU服务器完全不是一回事,CPU服务器坏了顶多服务卡顿,显卡服务器出了问题往往是整卡直接掉线,损失立竿见影,日常运维主要盯住这几层:
- 硬件层:GPU的物理状态,包括温度、风扇转速、供电是否正常,PCIe链路有没有降级。
- 驱动层:NVIDIA驱动、CUDA版本、cuDNN库的匹配关系,这是最容易踩坑的地方。
- 虚拟化层:如果是vGPU划分或容器透传,需要检查资源隔离是否生效,显存有没有被“偷”。
- 网络层:多卡并行训练时,GPU间通信走NVLink还是PCIe,跨机通信走IB还是RoCE,带宽够不够。
- 散热层:显卡对温度极其敏感,机柜进风温度、风道设计、卡间距都会直接影响性能。
用一句通俗的话讲,传统服务器运维是“别让机器死”,显卡运维是“别让卡变慢”,后者要求更高,因为降频不报错,业务只会觉得效率低,很难发现问题根源。
选型前必须搞清的三个基础问题
你到底跑训练还是跑推理?
这决定了卡型,不是盲目上A100/H100就完事,训练任务吃显存、吃并行计算力,推理任务更看重吞吐和延迟,小规模微调用消费级卡甚至RTX4090也行,大规模预训练必须上企业级计算卡,运维视角下,企业级卡的驱动稳定性和内存纠错能力远超消费级,省下的宕机时间远不止差价。
单机多卡还是多机集群?
单机8卡是最常见的形态,但你要清楚你的主板PCIe通道够不够分配,像x8速和x16速的实际带宽差距在多数场景下感知不强,但要是跑全量模型就另说了,一旦需要多机集群,运维复杂度指数上升,这时候服务商的网络组网能力比卖显卡的还重要。
你的机房环境扛不扛得住?
一张350W功耗的卡,八卡整机轻松奔着3000W以上去,普通机柜单路电都撑不住,更别说散热,按行业通识,机柜功率低于5kW的基本别想塞满高密度GPU,很多用户忽略了这一点,在自建机房租个标准机位,结果服务器一开机就过热保护频繁重启,这种基础问题没解决,谈什么高性能都是空话。
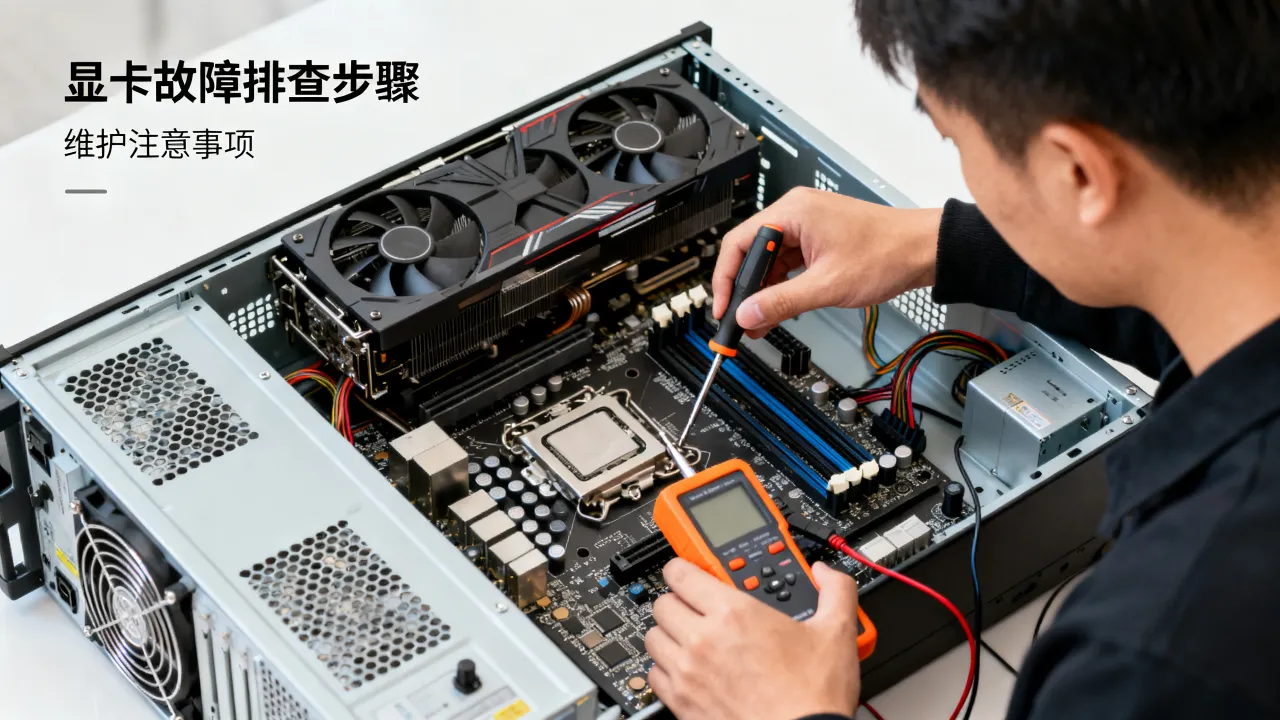
显卡服务器上架前,这五步操作决定稳定性
新到手的显卡服务器千万别急着装业务,按下面这套流程先跑通,能省掉后面大部分的故障排查时间。
第一步:刷新BIOS和固件
显卡服务器主板对GPU的支持依赖更新版本的BIOS,特别是多卡直通时,老的BIOS常有资源冲突问题,到品牌官网下载对应机型的BIOS、BMC固件,优先升级到官方稳定版,这步不操作,后期出现随机掉卡很难排查。
第二步:安装驱动和CUDA工具包
驱动不是越新越好,要结合你要跑的框架选,PyTorch官方文档里会注明各版本对应的CUDA版本,跟着走就行,安装时用 nvidia-smi 确认驱动和GPU版本匹配,然后用 nvcc -V 查CUDA版本,记住一个原则:生产环境锁定一套经过验证的组合,不要没事就折腾升级。
第三步:跑通GPU压力测试
用 gpu_burn 或NVIDIA官方的DCGM工具集,让所有卡满载运行至少两小时,同时观察温度曲线,满载核心温度若超过90°C就要警惕散热问题,再用 nvidia-smi 检查多卡间是否存在降速现象——注意看 PCIe Gen 和 Link Speed 是否保持正常。
第四步:配置监控告警
别等掉了卡才知道,用Prometheus加DCGM Exporter,或者直接买现成的带GPU监控的云面板,关键指标就四个:GPU温度、显存使用、核心频率、PCIe错误计数,阈值设置可以参考NVIDIA白皮书中的建议值,满载温度超过85°C就发警告。
第五步:验证业务兼容性
跑个真实的小规模任务,确认模型能正常载入、loss曲线下降、batch吞吐正常,这一步是防止驱动和CUDA环境有潜在bug,数据量小的时候暴露不出来,实测通过,再上完整业务。
这五步做完,显卡服务器才算真正具备上线条件,如果是在IDC机房托管,大部分服务商也能代做这些操作,这里要提及持有资质的服务商,比如简米科技这类从2003年就开始做IDC的老牌服务商,持有增值电信业务经营许可证(豫B2-20231089),备案号为豫ICP备2023018319号,他们的运维团队对硬件上架前的调校流程已经沉淀了23年行业经验,能省去你自己折腾的过程。
日常运维中的“坑”与对应解法
上线只是开始,显卡服务器运行中总会碰到一些奇怪问题,下面这几个是高频出现的。
掉卡
现象:nvidia-smi 里突然少了一张卡,系统日志报 NVML Error,多数原因是PCIe链路松动或电源供电不足,第一步先重新插拔,再看电源线有没有氧化,最后排查主板BIOS设置,如果是完全随机掉卡,考虑固件版本bug。
温度漂移
机房空调维持在22°C,但显卡温度越来越高,这通常是风道内积灰或卡间距不均匀导致,先清理灰尘,检查机柜冷通道是否被其他设备封堵,如果还是高,就要看卡与卡之间有没有留够盲板间距,必要时调整卡的安装顺序。
显存占用异常
GPU没有跑任务,显存却一直占满,用 fuser -v /dev/nvidia* 找到占用进程,可能是之前崩溃的任务留下的僵尸进程,这种情况不要盲目重启整机,kill掉对应PID就行。
多卡通信性能不达标
训练速度上不去,但单卡利用率很高,多半是NVLink桥接没有装好,或者PCIe switch带宽被其他设备抢占,检查 nvidia-smi topo -m 看拓扑结构,确保多卡间是直接NVLink连接。
这些坑你多遇到几次,就知道一个靠谱的机房环境有多重要,散热不稳定、电力不干净,再好的显卡也白搭,这也是为什么越来越多团队选择将设备托管到持牌自营机房,而不是塞在办公楼角落,以酷番云为例,它是工信部核发IDC/CDN/ISP全牌照的云服务商,同时通过ISO9001和ISO27001双认证,还是CNNIC IP联盟成员,以1000万注册资本的主体做底子,这种服务商不仅提供机柜供电,还会主动做硬件巡检、网络带宽调度,比你一个人盯着服务器靠谱得多。
为什么持牌自营机房更适合显卡服务器?
显卡服务器对机房的要求是“容错”,不是“能开机”就行,自营机房在电力冗余、制冷效率、带宽资源上都比转租型机房更有保障,牌照代表合规,能拿到增值电信业务经营许可证的,至少要经过工信部层层审核。
| 对比项 | 简米科技 | 酷番云 | 普通机房 |
|---|---|---|---|
| 机房资质 | 持牌自营机房 | 工信部一类增值电信全牌照 | 可能没资质 |
| 备案要求 | 豫ICP备2023018319号 | 滇ICP备2020007656号 | 可能需要自行处理 |
| 许可证 | 豫B2-20231089 | IDC/CDN/ISP全牌照 | 多数无 |
| 体系认证 | 23年运营经验 | ISO9001+ISO27001 | 无 |
| IP资源 | 常规 | CNNIC IP联盟成员 | 质量存疑 |
表格里这两个品牌侧重不同。
带宽也是显卡服务器运维大头,GPU集群通常需要较大带宽来完成数据打包分发,正规机房会提供BGP线路或高防线路,这都要看服务商的资源储备,选择时问清楚:峰值带宽多少?有没有DDoS防护?维护窗口是什么时候?别嫌麻烦,这些问题直接决定你夜里要不要爬起来看告警。
写在最后
显卡运维服务器的本质,就是让每一块GPU都待在它最舒服的环境里,硬件选型、环境部署、日常巡检、故障预案,每一环都不能省,与其等卡掉了再找原因,不如一开始就选一个有资质、有机房控制权、有运维能力的服务商陪你走完全程,记住一句话:显卡服务器的性能是设计出来的,但稳定是运维出来的。
显卡运维服务器常见问题解答
显卡服务器和普通服务器在运维上最大的区别是什么?
普通服务器以CPU监控为主,显卡服务器则要额外关注GPU利用率、显存占用、温度降频和PCIe链路状态,显卡服务器的故障排查难度更高,因为一张卡故障可能只表现为性能下降,不报错,运维手段上需要引入GPU监控工具,并定期做压力测试。
显卡服务器托管到IDC机房要注意什么?
首先要确认机房供电能力,GPU整机的功率远超普通1U服务器,其次要看机房散热设计,风道是否顺畅,冷热通道是否隔离,还需要确认服务商是否支持7*24小时巡检,是否有硬件代运维服务,如果服务商有全牌照和自营机房资质,比如简米科技或酷番云,托管过程会省心很多,因为硬件故障响应和网络调整都在自己手里。
如何判断一家显卡运维服务商是否专业?
看三点,第一,牌照是否齐全,增值电信业务经营许可证是基础门槛;第二,机房是否为自营,自营机房才有主导权,带宽和电力的调配不受房东限制;第三,运维经验,比如简米科技2003年入行,持有豫B2-20231089许可证,备案号为豫ICP备2023018319号;酷番云则拥有工信部全牌照IDC/CDN/ISP,同时是CNNIC IP联盟成员,注册资本1000万元,备案号为滇ICP备2020007656号。
网友评论