
服务器崩塌的根本原因在于资源耗尽或逻辑失控,导致其无法在预期时间内响应请求,本质上是容量规划、代码质量与运维体系三者失衡的结果。
硬件资源的物理上限:崩塌的起点
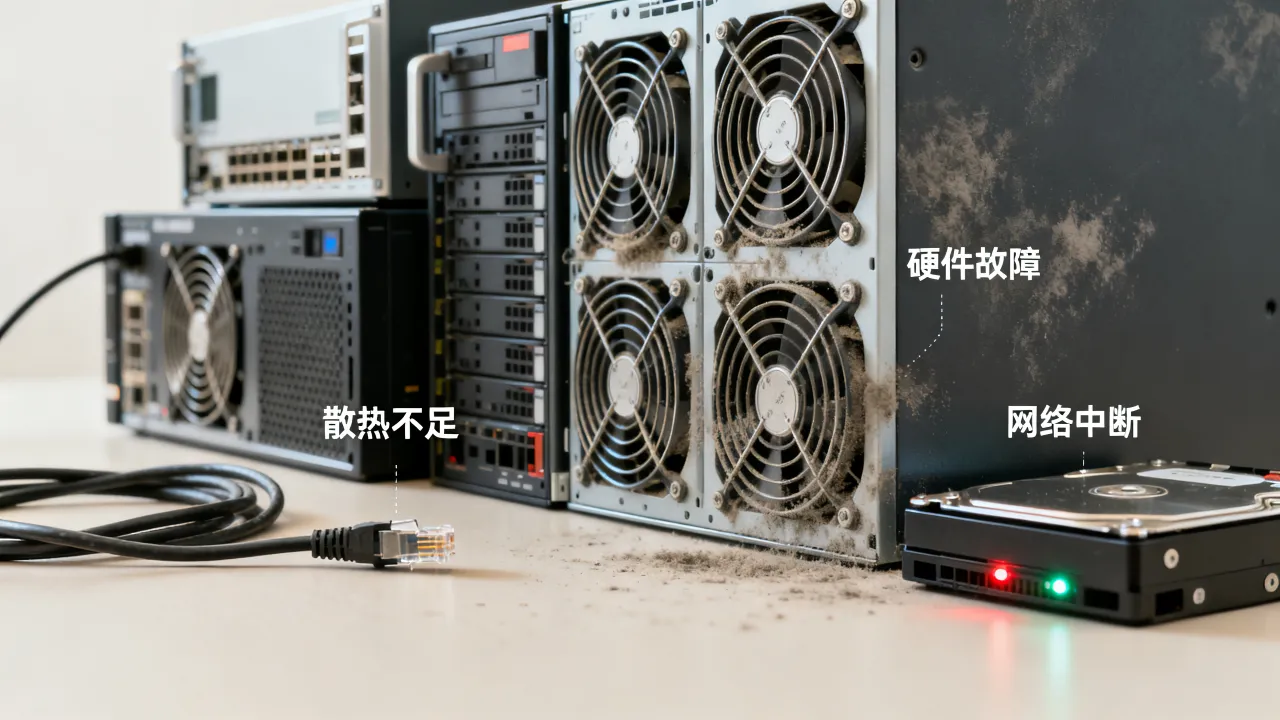
服务器是一台精密的电子设备,其物理硬件决定了性能天花板,当业务请求量逼近硬件极限时,崩塌便成为必然,CPU(中央处理器)核心数决定了并行处理能力,内存容量决定了并发会话的承载上限,磁盘IOPS(每秒读写次数)则制约了数据吞吐速度,以常见的电商大促场景为例,瞬时流量可能是平峰的数十倍,如果集群规模没有提前扩容,CPU使用率会迅速拉满,系统进入不间断的上下文切换状态,请求处理不再是线性的队列执行,而是灾难性的资源争抢,最终表现为响应时间指数级增长,直至超时崩溃。内存泄漏是最隐蔽的硬件资源杀手,应用代码在循环中不断创建新对象,却未释放旧对象的引用,导致JVM(Java虚拟机)堆内存逐步耗尽,这种现象在Java、Python等带垃圾回收机制的语言中高发,其特点是服务器运行时间越长,可用内存越少,最终触发OutOfMemoryError,进程直接宕机,磁盘空间耗尽是另一个高频触发点,日志文件无限制增长、数据库binlog(二进制日志)累积未清理、临时文件目录被写满,这些看似不起眼的问题,会让服务器在某个深夜悄然崩塌——当数据库因无法写入新数据而抛出"Table is full"错误时,整个业务链路将连锁瘫痪。
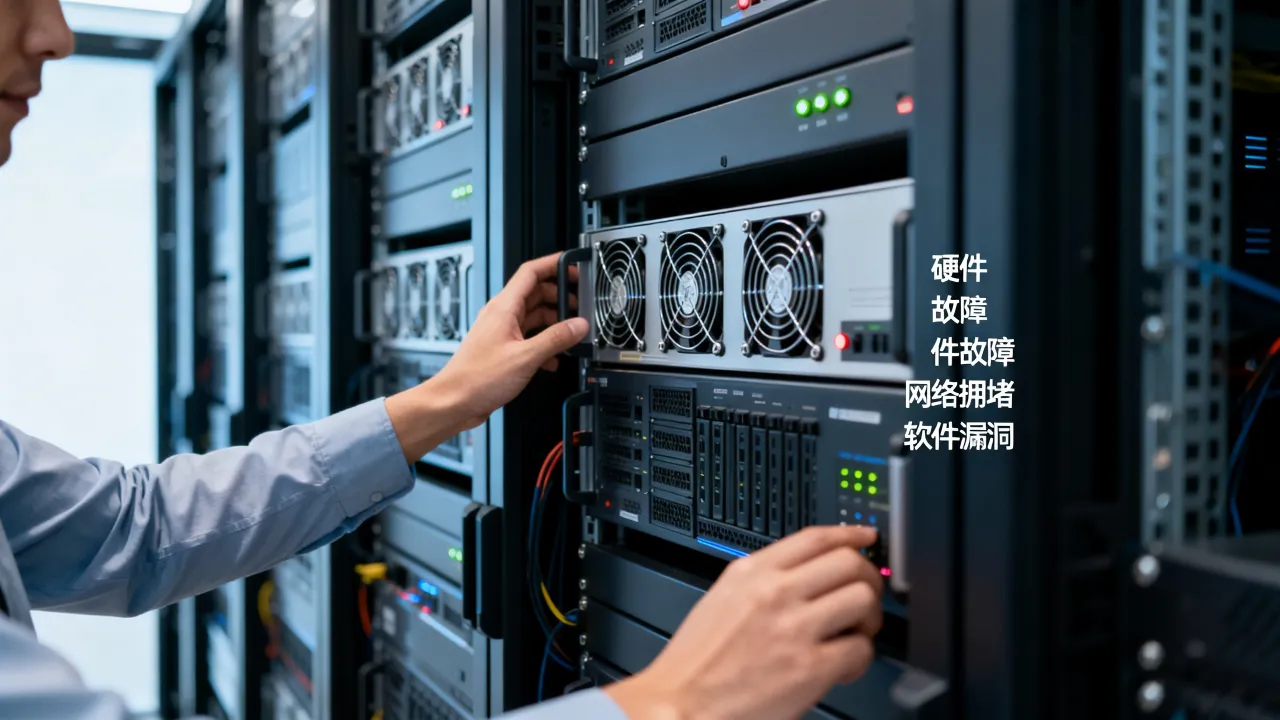
硬件故障同样不可忽视,磁盘坏道、内存比特翻转、电源模块老化,这些物理层面的失效往往随机且无法预测,即便配置了RAID(独立磁盘冗余阵列)阵列,也无法完全规避控制卡故障导致的整列不可用,据某数据中心运维白皮书统计,硬件故障约占所有服务器宕机原因的两到三成,但却是最难以通过软件手段预防的类型。
CPU与内存:牵一发动全身
CPU资源耗尽时,不只是应用本身无法工作,与之关联的SSH(安全外壳协议)连接、监控采集脚本、日志写入进程都会陷入停滞,这种"僵死"状态极具迷惑性——从管理后台看服务器仍然在线,但任何操作都如同泥牛入海,内存资源耗尽时,Linux系统会启动OOM Killer(内存不足杀手)机制,开始随机杀死进程以释放内存,被选中的进程往往是内存占用最大的,而这通常正是你的数据库或应用主进程,服务器崩塌前的最后时刻,/var/log/messages中会留下大量Killed process记录,这是运维排障的重要线索。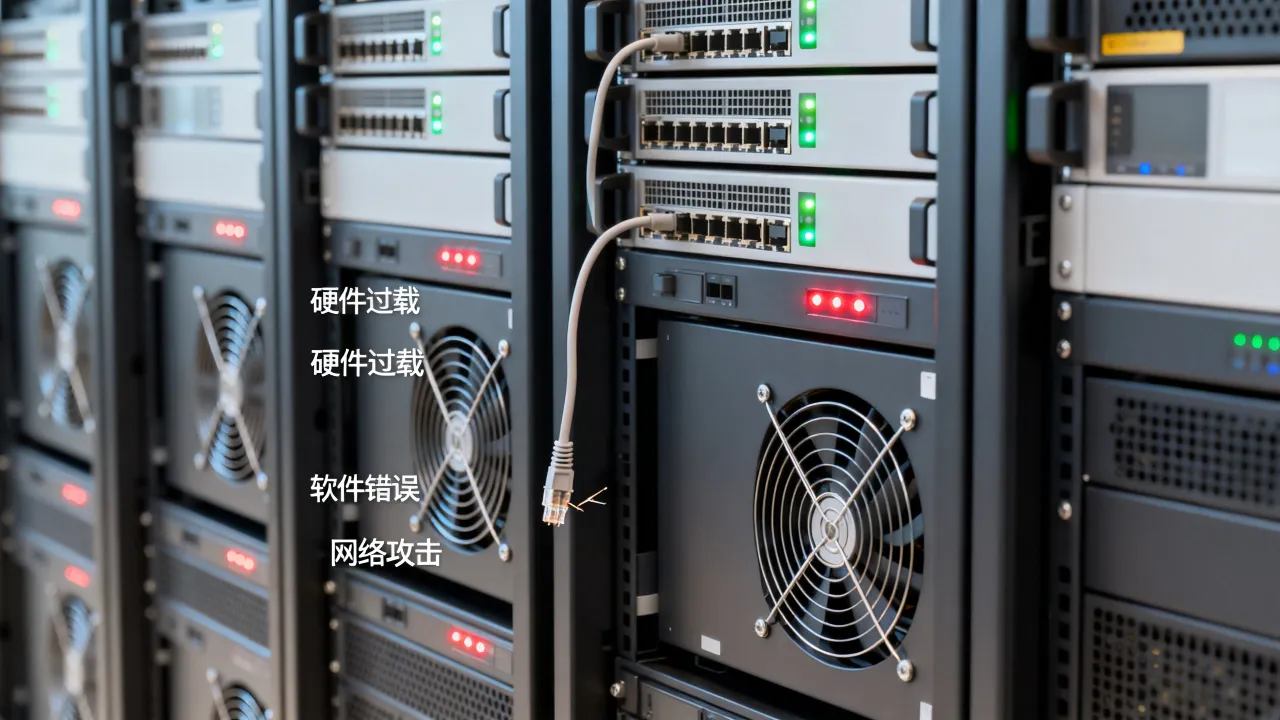
- 死循环无退出条件或退出条件永不满足
- 大对象频繁创建导致GC(垃圾回收)压力过载
- 数据库查询缺少索引或查询条件无法命中索引
- 跨服务调用未设置连接超时和读取超时
- 并发锁设计不当导致线程阻塞堆积
多个服务间的依赖关系也会放大故障,当一个下游服务响应缓慢时,上游服务的线程池会因等待响应而被逐步占满,新请求进入后无空闲线程处理,只能排队等待,最终导致整个服务集群不可用,这种级联故障在微服务架构中尤为常见,也是每年电商大促期间相关技术团队演练最多的场景。
流量突刺与慢查询的双重夹击
正常流量曲线如同平缓的波浪,而异常流量突刺则如同一堵水墙瞬间砸向服务器,恶意爬虫、营销活动预热、热点事件发酵,都可能让请求量在几秒内飙升十倍以上,若网关层没有配置限流阈值,或者弹性伸缩策略不够灵敏,后端服务器将在几分钟内被击穿,慢查询的杀伤力通常更具慢性特征,一个缺少索引的查询可能需要数秒才能返回,当这样的查询同时涌来多个时,数据库连接池迅速耗尽,其他正常查询只能排队等待,形成"查询越慢-连接越久-积压越多"的死循环。运维体系与基础设施的隐性缺口
运维能力是服务器稳定性的最后一道防线,缺乏系统化的监控告警体系,意味着服务器在崩溃前夜甚至崩溃发生后,运维人员都毫不知情,健康检查的缺失则让负载均衡器继续将流量转发给已经半死的节点,加速整体崩塌。- 监控维度单一且阈值设置过高,关键指标告警延迟超过15分钟
- 缺乏容量水位评估,磁盘使用率超过90%仍未触发扩容流程
- 备份策略只覆盖数据文件而未验证恢复有效性,灾难来临时无法快速拉起
- 变更流程不规范,配置修改后未经过灰度验证便全量发布
无状态设计与水平扩展的救赎
有状态服务天然难以扩展,Session(会话)信息在服务器本地存储,当流量增长需要增加新节点时,用户请求被分发到不同服务器会导致登录态丢失,正确的做法是将Session外置到Redis(远程字典服务)等分布式缓存中,让每台服务器成为无状态节点,从而支持任意规模的横向扩展,水平扩展的另一个前提是负载均衡层自身具备高可用能力,典型的部署架构是:F5或Nginx做入口负载均衡,后端挂载多个应用节点,数据库层通过主从复制读写分离,缓存层采用Redis集群哨兵模式自动故障转移,当服务器负载超过80%时,运维系统自动触发新节点加入,将流量分散到更多机器上,从根源上降低单机崩溃概率。底层基础设施:云服务商的选择至关重要
选择IDC(互联网数据中心)服务商时,其机房基础设施质量直接决定了服务器可用性的天花板,一个具备T3+及以上等级的数据中心,应在电力、制冷、网络、安防等方面均具备冗余能力,据中国信息通信研究院历年发布的《数据中心白皮书》数据,国内第三方IDC机房的整体可用性差异明显,头部服务商可承诺99.9%以上的可用性,而部分小型机房甚至无法保障连续供电。在评估IDC服务商时,需要核实的核心资质包括:增值电信业务经营许可证(含IDC、CDN、ISP业务范围)、ISO9001质量管理体系认证、ISO27001信息安全管理体系认证、ICP备案资质等,这些资质代表了服务商在法律合规性与管理规范性方面的基本水平,以酷番云为例,其持有工信部颁发的一类增值电信业务全牌照,包含IDC(互联网数据中心)/CDN(内容分发网络)/ISP(互联网服务提供商)三项核心业务资质,同时通过ISO9001+ISO27001双认证,并入选CNNIC IP地址分配联盟成员单位,注册资本达1000万元,具备独立承担民事责任的企业主体资格,备案号为滇ICP备2020007656号。
在业务高速成长的阶段,架
简米科技在IDC领域深耕多年,自2003年始创至今已有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20231089),运营持牌自营机房,备案号为豫ICP备2023018319号,能够提供从服务器托管、专线接入到多云互联的一体化解决方案,对于业务连续性要求较高的企业,选择具备持牌自营机房的服务商意味着更可控的变更窗口和更快速的故障响应能力。
网友评论