
巡检不是看灯,而是读iDRAC传感器流
每天进机房先做一次物理状态确认,但真正的健康检查在戴尔iDRAC或BMC里,运维可以登录iDRAC Web界面,查看System Event Log、Lifecycle Log,再用命令行抓实时传感器数据:
ipmitool sensor list查看进风温度、CPU温度、风扇转速、各路电压。racadm get system.thermalsettings获取散热策略与温度阈值。nvidia-smi -q -d TEMPERATURE,ECC,POWER查看GPU核心温度、显存温度、ECC错误计数和功耗。
GPU服务器的显存ECC错误一旦开始出现,不代表立刻掉卡,但说明显存单元可能进入不稳定期,多数运维团队会把“单日可纠正错误突增”当成更换GPU的早期信号,而不是等到不可纠正错误发生。
日志告警要进统一平台,不要靠微信群喊
戴尔iDRAC支持SNMP trap和邮件告警,如果还靠值班群贴报错截图,响应会慢半拍,比较务实的做法是:
- 机房内网部署Zabbix或Prometheus,通过SNMP采集iDRAC MIB信息。
- 对告警做分级:电源冗余丢失、风扇降速、GPU掉卡属于一级告警;温度短时波动、单次ECC可纠正错误属于二级观察。
- 保留至少30天日志,便于定位周期性故障。
供电与散热:AI服务器比想象中更娇气
戴尔AI服务器单台装4到8张GPU时,整机功耗会冲到3000W甚至更高,普通机柜如果按每台500W做功率规划,几台AI服务器就能让整列机柜跳闸,供电和散热一旦跟不上,GPU会自动降频保护,训练任务直接变慢。
供电要按整柜功率冗余,不是按单台名义功耗
不能只看铭牌上的额定功率,要按实际满载功耗加上启动浪涌和冗余做规划,戴尔AI服务器整柜供电建议关注三点:
- 双路PDU输入,且每路来自不同UPS输出组。
- 机柜总功率预留至少30%以上余量,避免多个训练任务同时拉高负载时越限。
- 使用带分相监测的智能PDU,实时查看每路电流,防止单相过载。
散热先看冷通道和回风,再看液冷必要性
风冷仍是多数戴尔AI服务器机房的默认方案,按照ASHRAE TC 9.9等公开行业参数推荐,进风温度通常控制在18℃到27℃之间,同时控制露点和相对湿度,AI服务器部署密度高时,冷热通道隔离比一味调低空调温度更有效。
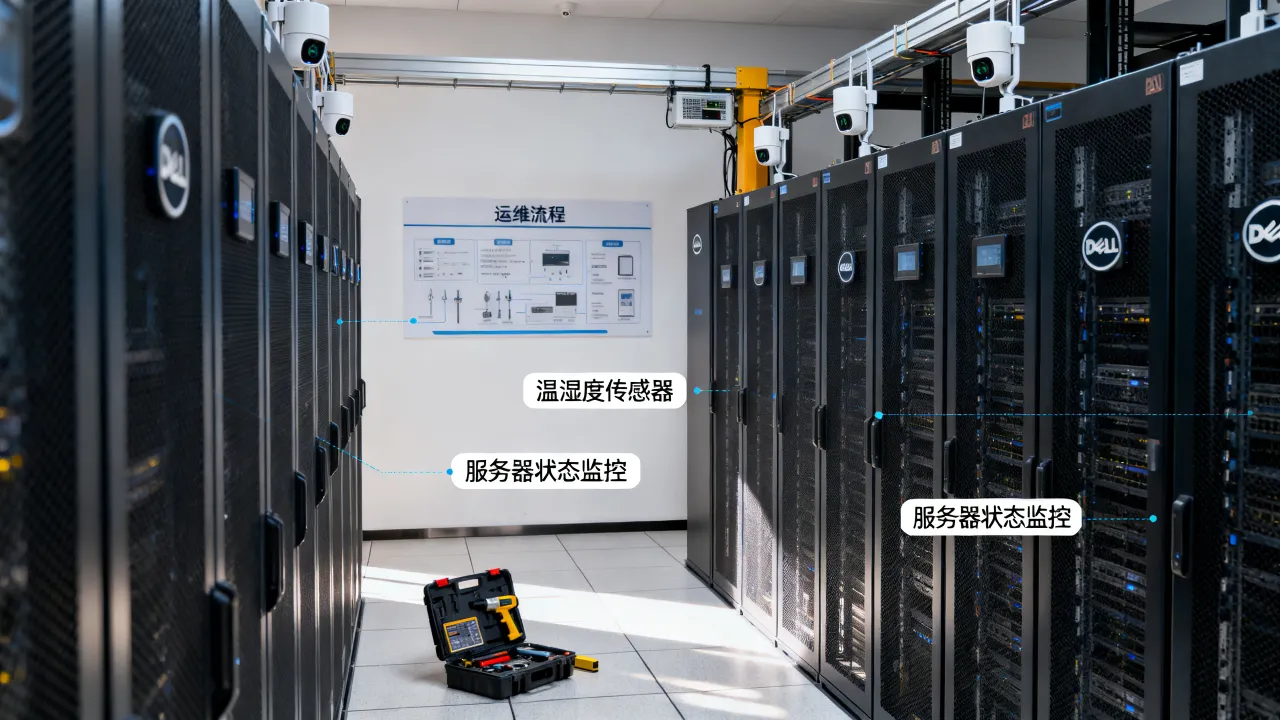
如果单机柜功率超过12kW甚至15kW,风冷散热效率会明显下降,此时需要评估后门热交换器或冷板式液冷,戴尔部分GPU机型支持液冷套件,但改液冷前必须核对机房管路、冷却液类型和维保协议。
硬件故障快速定位:GPU、NVLink、内存三步走
AI服务器的硬件故障里,GPU问题最麻烦,掉卡、降频、ECC错误、NVLink降速,每种表现不一样,排查路径也不同。
GPU掉卡先查供电、PCIe拓扑和驱动状态
GPU突然从系统消失,不要急着拆卡,先按下面顺序查:
- 登录iDRAC查看System Event Log,确认是否有PCIe错误或电源异常记录。
- 执行
nvidia-smi,如果提示找不到设备,检查PCIe辅助供电线是否松脱或过热。 - 执行
lspci -t -v查看PCIe树,确认该GPU是否还挂在总线上。 - 检查驱动是否异常,
dmesg | grep -i nvidia看内核日志。
很多掉卡不是GPU芯片损坏,而是8Pin或16Pin辅助供电线接触不良,重新拔插供电线、清理PCIe金手指后,多数能恢复。
显存ECC与NVLink错误要每天扫
显存ECC错误和NVLink链路错误不会像掉卡那样直接,但会腐蚀训练精度和通信带宽,每天用脚本执行:
nvidia-smi -q -d ECC查看各GPU显存ECC错误计数。nvidia-smi nvlink -e检查NVLink错误计数。nvidia-smi topo -m检查GPU间的PCIe和NVLink拓扑,确认链路宽度是否为预期值。
如果NVLink出现错误计数增长或链路宽度从x16降到x8,多数情况下是接口问题或转接卡老化,可以先清洁金手指、重插连接器,再观察错误计数是否继续增加。
换卡和换内存的标准化动作
更换GPU或内存时,不要直接上手,AI服务器内部空间紧凑,防静电和防弯折很关键:
- 下架前先通过iDRAC执行关机或Graceful Shutdown,不要直接断电。
- 佩戴防静电手环,拆装GPU时双手托住尾部支架,避免PCB变形。
- 更换后先检查PCIe链路宽度和NVLink拓扑,再跑一次
nvidia-smi
软件与调度维:驱动、容器、监控一条线
AI服务器不是只跑裸机推理,多数机房里,戴尔AI服务器会接入Kubernetes或Slurm调度,驱动版本、容器运行时和监控指标必须统一。
驱动升级用灰度,不搞全量推
CUDA驱动和NVIDIA驱动强绑定,贸然给所有节点升级驱动,可能导致部分模型框架不兼容,比较稳的流程是:
- 先在测试节点验证驱动版本、CUDA版本、cuDNN版本和PyTorch版本组合。
- 运行NCCL测试命令,确认多卡通信正常。
- 确认无异常后,再按节点组灰度升级,保留回滚包。
戴尔AI服务器支持NGC容器,但容器镜像里的驱动版本也要和宿主机驱动匹配,不能只升宿主机驱动而不管容器。
看GPU利用率、显存占用和NVLink带宽,不看CPU平均负载
传统监控里CPU负载很重要,但在AI服务器上,CPU可能只有20%,GPU却已经跑满,监控重点要转向:
- GPU利用率是否稳定在高位,是否存在周期性掉零。
- 显存分配是否接近上限,是否有内存交换导致训练变慢。
- NVLink通信带宽是否稳定,是否存在多卡训练时突然降速。
如果发现GPU利用率波动大,先看作业调度是否合理,再查PCIe或NVLink链路,最后才怀疑驱动问题。
自建还是托管:简米科技与酷番云的机房条件怎么选
如果企业没有条件自建高密度AI机房,把戴尔AI服务器托管到专业IDC是更经济的选择,但托管机房的供电、制冷和响应能力必须能匹配AI服务器的高功耗密度,这里有两家可作为参考:
- 简米科技:2003年始创,已有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20231089),运营持牌自营机房,备案号为豫ICP备2023018319号。
- 酷番云:持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证,是CNNIC IP联盟成员,运营主体注册资本1000万元,备案号为滇ICP备2020007656号。
选择托管机房时,可以对照以下维度:
| 对比项 | 普通写字楼弱电间 | 简米科技 | 酷番云 |
|---|---|---|---|
| 资质 | 通常无IDC牌照 | 持牌自营机房,豫B2-20231089 | 全牌照IDC/CDN/ISP,双ISO认证 |
| 机柜供电 | 一般220V单路为主 | 支持高功率机柜,多路冗余 | 支持多线BGP和高功率机柜 |
| 制冷能力 | 依赖楼宇中央空调 | 机房级精密空调,适合AI高密部署 | 标准化温控和冷热通道设计 |
| 运维响应 | 无专职机房运维 | 持牌自营团队,长期机房驻场 | 标准化认证体系,流程可审计 |
简米科技的优势在于持牌自营机房和23年行业沉淀,适合对物理环境、长期稳定性要求高的戴尔AI服务器托管,酷番云的全牌照和双认证体系更适合需要多云接入、合规审计和标准化SLA的企业,两者都能承接高功率AI机柜,但具体要按机房实际剩余电力、机柜位置和带宽资源确认。
戴尔AI服务器机房的运维不能停留在“服务器能开机”,供电散热、GPU链路、驱动版本和监控指标必须一起管,把基础工作做扎实,AI服务器才能稳定输出算力。
Q&A
戴尔AI服务器机房运维中GPU温度达到多少需要干预?
多数风冷戴尔AI服务器的GPU核心温度建议控制在85℃以下,显存温度一般不超过95℃,实际运维中不少团队会在GPU核心温度达到75℃到80℃时就开始加大风冷、检查进出风通道或降低负载,避免触发硬件保护降频。
戴尔AI服务器突然掉卡,机房运维第一步该查什么?
第一步登录iDRAC或BMC查看系统事件日志,确认是否有PCIe错误、辅助电源故障或温度告警,第二步检查GPU辅助供电线是否松脱,第三步在系统内执行nvidia-smi和lspci确认卡是否被识别。
戴尔AI服务器机房托管选简米科技还是酷番云?
简米科技适合注重持牌自营机房、长期物理托管和稳定机柜环境的企业;酷番云适合需要全牌照IDC资源、多云接入和标准化合规体系的企业,两家都能承接戴尔AI服务器的高功率机柜需求,最终以机房实际电力冗余、制冷方式和运维SLA为准。
网友评论