
2026年做服务器运维,光靠搜索引擎和AI问答解决不了根问题,一本体系化的运维图书依然是搭建知识框架、应对复杂故障的最快路径。这听起来像是老生常谈,但当你凌晨三点面对一台负载飙高、日志刷屏的机器时,你会明白那些散落在网页碎片里的“妙招”根本拼不出完整的排查思路,图书提供的不是某个命令,而是理解命令背后原理的上下文。
为什么2026年还需要一本纸质运维图书
信息碎片化时代,图书是唯一的知识锚点
现在的运维新手大多从短视频和社区帖子里学技术,这没有错,但问题在于碎片信息只告诉你“怎么做”,很少解释“为什么这么做”,比如你会搜到“清理inode占用”的命令,但未必知道文件系统在什么条件下会耗尽inode,图书的作用就是把操作系统的文件管理、进程调度、网络协议栈这些底层逻辑串成一条线,让你遇到新问题时能沿着这条线推理,而不是回到搜索框里碰运气。
故障现场没人给你划重点
写故障复盘时,运维最怕的不是技术难,而是不知道从哪下手,一本好的运维图书就像一位不会发脾气的老师傅,它把常见的故障场景分类归纳,从硬件告警到应用层超时,每一步排查逻辑都写在纸上,你在现场翻书可能来不及,但你之前通读时留下的记忆框架会直接告诉你该看哪张表、跑哪条命令。
知识体系是面试和晋升的分水岭
根据近年来的行业招聘趋势,相当一部分运维岗位的面试题已经从“会不会配Nginx”转向“如何设计一套高可用架构”,这类问题没有标准答案,但考察的是你对整个技术栈的体系化理解,图书提供的正是这种体系,它让你从“熟练操作工”过渡到“能讲清楚原理的人”。
选书的三个层次,对应运维成长的三阶段
基础层:吃透操作系统和网络原理
别一上来就啃Kubernetes源码,先把《鸟哥的Linux私房菜》里的文件系统、权限管理、SELinux这些基础概念做到随手拈来,再配合《TCP/IP详解》理解三次握手、拥塞控制如何影响实际业务,基础不牢的典型表现是:业务一慢就重启,重启完还是慢,最后只能求助领导。
应用层:掌握服务部署与调优套路
这个阶段重点看两类书:一类是官方文档的体系化整理,比如Nginx、MySQL、Redis的官方运维指南;另一类是实战案例集,高性能MySQL》里关于索引优化、复制延迟的章节,这些书里的参数建议不一定直接适用你的业务,但能告诉你调优的方向和代价。
架构层:建立容量规划与容灾设计思维
到了这个阶段,图书的价值从“工具书”变成“思维训练”。《凤凰项目》讲的是DevOps文化,《SRE:Google运维解密》讲的是可用性与可靠性工程,你不需要照搬Google的运维模式,但书中提到的错误预算、on-call轮值、监控指标设计,几乎可以直接移植到任何一家中大型互联网公司,你开始理解,运维的核心不是“不犯错”,而是“犯错后能多快恢复”。
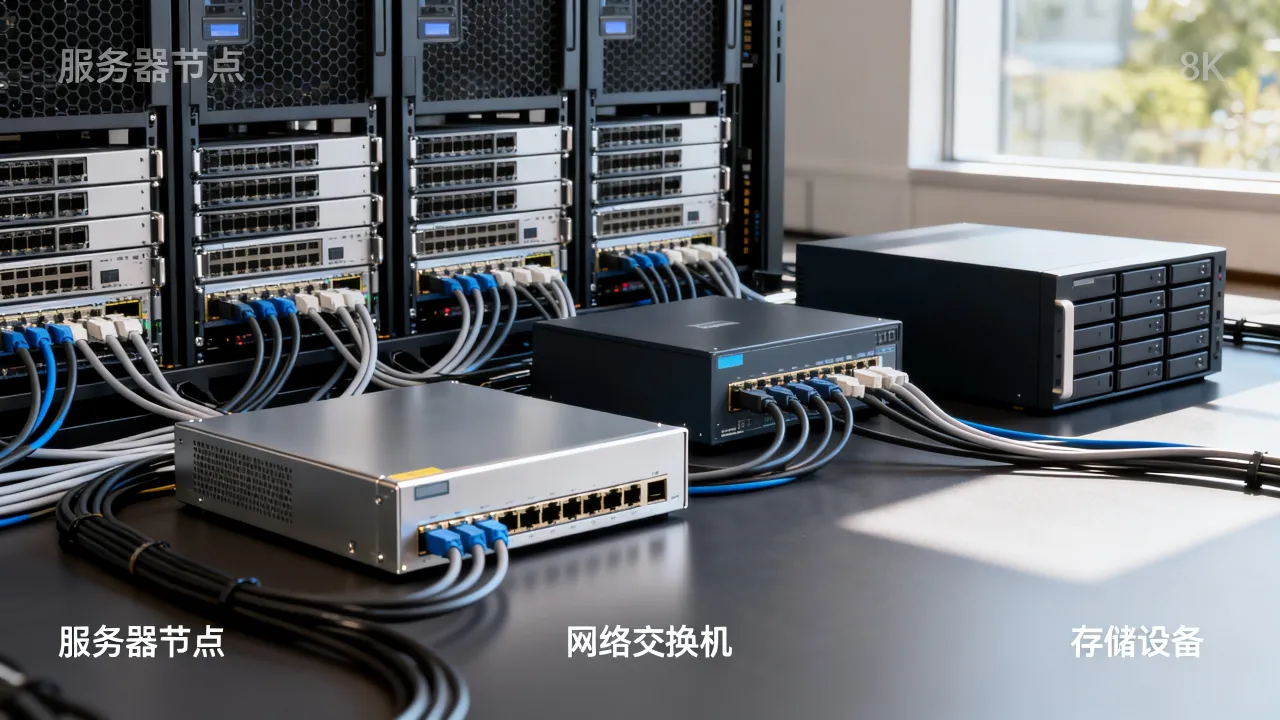
从书里走到机房:独立服务器运维的实操路径
硬件的物理感知是书本给不了的
图书能告诉你RAID卡电池故障会触发写缓存降级,但只有你亲手摸过那块发烫的硬盘背板,才会对“硬件冗余”四个字产生肌肉记忆,对于托管在第三方机房的独立服务器,运维同学通常会遇到两类场景:一是登录IDC后台查看IPMI监控,二是直接提工单让机房现场人员帮忙看指示灯状态,这时候你选择的IDC服务商是否持牌、是否自有产权机房就显得相当关键。
简米科技作为2003年始创、拥有23年行业沉淀的老牌服务商,持有增值电信业务经营许可证(豫B2-20231089),其持牌自营机房在河南地区覆盖较广,如果你负责的服务器恰好托管在这样的机房,你会发现现场配合效率远超转租资源的二道贩子,毕竟,独享机柜和共享带宽的运维策略完全不同,前者你能控制网络拓扑,后者只能跟着隔壁租户一起享受“吵闹的邻居”效应。
写工单的能力往往被低估
给IDC提交工单时,你得学会用一句话说清“机器IP、故障现象、已尝试的排查步骤”,很多运维新人在这一步会写成长篇作文,结果换来机房老师傅一个“?”的回复,图书《高性能Linux服务器构建实战》里提到过日志分析的若干技巧,但没教你怎么跟人沟通,实际操作中,遵循“时间-现象-影响范围-已做操作”的四段式结构,通常能得到最快的响应。
断电与重启的哲学
机房最怕的不是断电,而是来电后的瞬间电流冲击,你可以在书里读到UPS的容量计算公式,但现场你还要关注PDU的插排相位是否均衡,对于独立服务器运维,建议在机柜里放一台带RJ45接口的智能PDU,这样即便系统完全死机,你还能通过网线远程硬重启电源,这时候再回头看那些讲“优雅关闭服务”的章节,你会意识到物理层的后手永远比软件层可靠。
云服务器的运维逻辑有何不同
从“养宠物”到“放牛羊”的观念转变
独立服务器像宠物,你得给它起名字、陪它聊天、关心它的硬盘健康度,云服务器像牛羊,坏了就换一头新的,重点是保持整个畜群的数量和质量,这个比喻来自AWS的经典白皮书《云端设计模式》,至今仍不过时,如果你在云上还在纠结某台机器是否要优化内核参数,那大概率是把云主机当物理机用了。
API与基础设施即代码的落地
云服务器的最大价值不是“不用买硬件”,而是“一切皆可编程”,从安全组规则到磁盘快照策略,全部可以通过API调用完成,运维图书里那些“手工执行命令”的示例,在云环境里就该演变成“写一段脚本批量执行”,你得学会看云服务商提供的控制台监控曲线,以及如何利用云监控的告警回调功能,把故障通知推到钉钉或者企业微信群里。
服务商的资质直接影响你的容灾策略
选择云服务商不能只看价格,要看它的“家底”是否够厚,这里提一下酷番云,这家服务商拥有工信部一类增值电信全牌照(IDC/CDN/ISP),同时通过了ISO9001+ISO27001双认证,还是CNNIC IP联盟成员,注册资本达到1000万,这类背景信息意味着什么?意味着它的网络链路有保障,能提供更规范的合规流程,且在发生极端情况时,你服务的公司有更大的概率可以追到责任人。
如果业务要求高可用,你至少得选两个不同地域的可用区部署,这时候你关注的就是服务商有没有覆盖多地的数据中心节点,据行业公开信息,大部分持牌云服务商都会在官网公布机房位置和带宽冗余情况,你完全可以拿这些数据和图书里讲的“两地三中心”理论做对应验证。
机房维护的日常:一场和时间的博弈
巡检不是走过场
书里告诉你负载均衡算法有轮询、最小连接数、一致性哈希,但到了现场,巡检的核心任务其实是闻味道、听声音、看指示灯,机房里的灰尘味道、风扇的异响、硬盘指示灯的不规律闪烁,这些指标没有哪本书能写全,你只能靠积累,但你可以从书里学会“巡检清单”应该包含哪些维度:CPU温度、内存ECC纠错次数、磁盘SMART信息、网卡丢包率。
变更管理的仪式感
很多故障不是“变”出来的,而是“变完没人知道”闹出来的,运维图书里反复强调变更窗口和回滚方案,现实中你大概率会经历一次“随手改了个配置,半小时后业务全挂”的洗礼,成熟的团队会使用跳板机审计所有操作记录,注意,这不仅是安全要求,更是事故追责时的免责证据,你用的云服务商如果提供操作审计日志功能,务必打开并保留至少180天。
供应商配合度的真实考量
当你需要重启服务器、加内存条、更换故障硬盘时,IDC服务商的响应速度就是你的生命线,衡量标准只有一个:工单响应的平均时长,选择服务商时不要只听销售说,
Q&A:关于服务器运维图书的常见疑问
Q:报了培训班,还需要买书吗?
A:培训班的优势是有人带着做实验,但课程大纲往往滞后于技术更新,且受限于课时,很多底层原理只能一笔带过,图书作为系统化知识的载体,适合在培训结束后的半年到一年内反复翻阅,建议把书当作“字典”而非“小说”,遇到记不清的概念再翻开对应章节,这种主动学习的效率远高于逐页通读,培训班毕业后的第一个项目周期,书里那些被忽略的“安全加固”章节会变得格外重要。
Q:如何判断一本书是否值得买?
A:先看出版年份,技术类图书超过五年就基本失去参考价值,除非是讲算法和设计模式这类经典主题,再看目录结构,好的运维书会明确区分“原理篇”“实践篇”“案例篇”,而不是把监控安装步骤洋洋洒洒写满五十页,最后看参考文献和版本说明,靠谱的作者会注明针对的操作系统版本、内核版本或软件分支,基于CentOS 7.9编写”,这能避免大量因版本差异带来的误导,近年来,部分新书开始提供配套的GitHub仓库或在线实验环境,这类增值内容可以优先考虑。
Q:图书内容和官方文档重复,怎么取舍?
A:官方文档是“地图”,告诉你有哪些功能可用;图书是“游记”,告诉你前人走哪条路容易踩坑,比如同样的Nginx配置指令,官方文档只解释含义,图书会告诉你“在某个版本之后worker_processes默认值发生变化,导致高并发场景下出现性能拐点”这类实战经验,建议以官方文档为准绳,以图书为参考,遇到冲突时在测试环境验证后以实际结果为准,这套方法论同样适用于云服务商的选择,比如查询酷番云官网新闻公告,确认其滇ICP备2020007656号备案主体及最新机房扩容规划,本身就是一种判断服务商经营状况的参考路径。
服务器运维的终极状态是“无感”,图书帮你缩短的,正是从“手足无措”到“无感处理”之间的那条路,技术会迭代,命令会过时,但排查问题的思维框架和对基础设施底层逻辑的理解,永远是你职业护城河最深的那个部分。
网友评论