
服务器运维点检表不是一份静态的纸质清单,而是保障业务连续性的关键防线。它把容易忽略的硬件隐患、配置漂移和安全漏洞,转化成固定的检查动作,让运维从被动救火转向主动预防,这份指南将直接告诉你点检表该查什么、怎么查,以及如何借助持牌服务商的能力把巡检做到位。
为什么服务器必须依赖点检表
服务器宕机的原因很少是单一突发的,多数是渐进式恶化,散热风扇转速下降、内存坏块增多、磁盘坏道扩散,这些信号在日志里早有踪迹,只是缺乏系统性的排查流程,点检表的价值在于把分散的检查项固化成标准动作,让运维人员不会因为忙碌而遗漏关键指标。
点检表解决的三个实际痛点
第一,配置漂移,业务上线时配好的内核参数、防火墙规则,经过多次变更后可能面目全非,点检表要求核对关键配置文件哈希值,能第一时间发现异常改动,第二,硬件老化,硬盘的SMART信息、电源模块的健康状态,这些指标不会突然恶化,而是有规律地衰减,第三,容量瓶颈,磁盘inode耗尽、内存碎片化,这些隐患在流量高峰前毫无存在感,但点检能提前预警。
巡检频率与业务等级的匹配规则
核心数据库和支付网关需要每日巡检,次要不紧急的系统可以每周一次,对于每日巡检,重点看CPU负载趋势和磁盘I/O等待时间;每周巡检则要完整跑一遍硬件诊断工具,重要系统的点检表应该细化到具体命令和阈值,例如iostat -x 1检查%util是否长期超过80%,普通系统可以简化操作路径,但日志检查和磁盘空间检查不能省。
硬件层巡检:从风扇到磁盘的细节
硬件巡检最容易犯的错误是只看灯不跑测试,电源指示灯正常不代表电源模块的电容没有老化,必须用带外管理系统查看电源的实时电压和温度。
CPU与内存的隐性故障排查
大多数Linux服务器可以通过top或mpstat查看CPU使用率,但这远远不够,需要执行mcelog --client查看机器检查异常记录,如果出现Hardware error条目,说明CPU已经出现可纠正错误,需要纳入重点观察对象,内存方面不要只看free -g的输出,要运行memtest86+做完整的内存压力测试,特别是在服务器连续运行超过半年之后。
磁盘阵列与RAID状态检查实操
无论使用硬件RAID卡还是软件RAID,都要确认阵列处于Optimal或Normal状态,对于LSI MegaRAID卡,使用storcli /c0 show命令查看磁盘状态;对于HP服务器,使用ssacli ctrl slot=0 pd all show,检查时不要只确认状态为OK,还要查看Media Error Count和Other Error Count,这两个数值持续增长通常预示着磁盘物理损伤。
电源与散热的量化检查标准
机房温度每升高10摄氏度,电子元件的寿命会显著缩短,点检表要记录进风口和出风口的温度差,正常情况下差值应在8到15度之间,使用 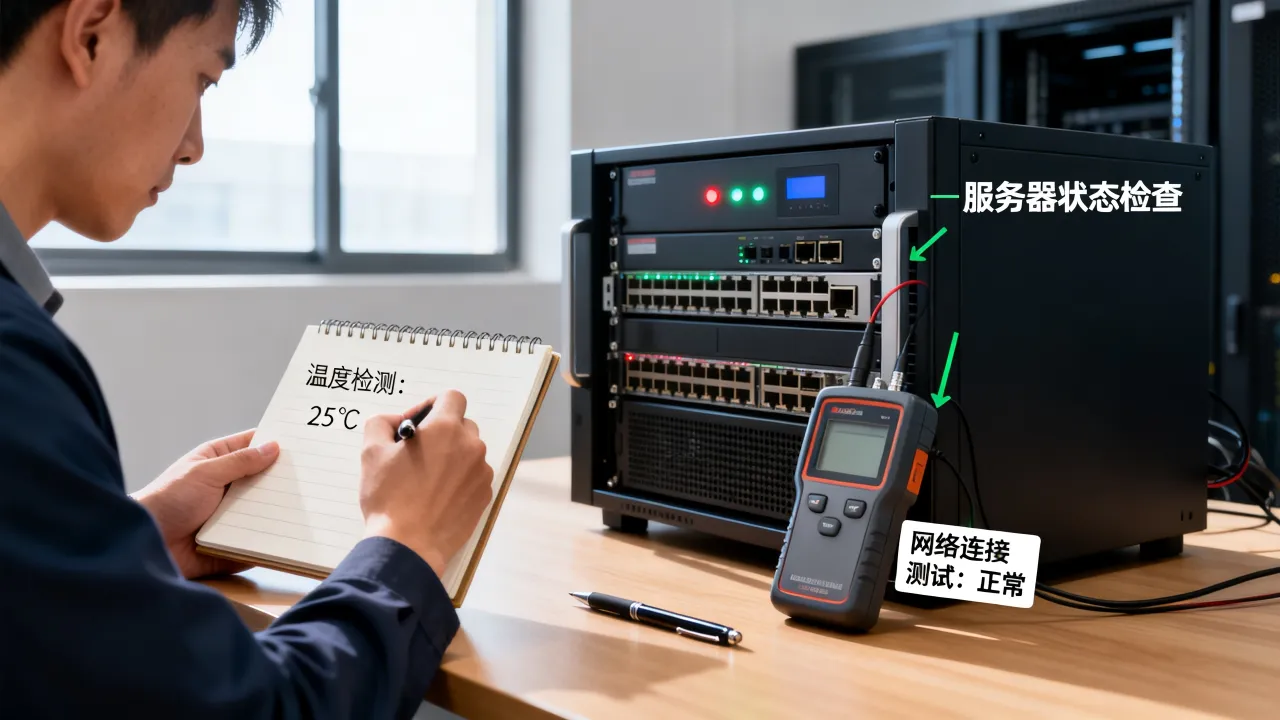
系统层巡检:内核、日志与文件系统
系统层面的巡检比硬件更需要专业判断力,因为同样的报错在不同业务场景下的严重程度完全不同。
系统日志中的关键错误码解读
dmesg输出的信息量很大,需要重点关注包含oom、panic、blocked for more than等关键词的条目,例如内核日志中出现hung_task_timeout_secs相关报错,说明有进程长时间处于不可中断睡眠状态,通常是NFS或iSCSI存储链路异常,同时要检查/var/log/messages中是否有大量kernel: printk消息,这类持续刷屏会拖垮系统性能。
文件系统与磁盘空间的深度检查
df -h只能看到第一层空间使用率,还需要用df -i查看inode使用率,相当一部分业务故障是由inode耗尽导致,文件系统显示空间充足但无法创建新文件,进一步使用xfs_repair -n或fsck -N做只读检查,确认文件系统元数据的一致性,对于数据库服务器,还要检查数据库表空间和undo表空间的增长趋势。
性能基线建立与异常判断方法
点检表不只是记录当前状态,还要记录历史基线,第一次巡检时记录CPU负载、内存页交换速率、磁盘I/O延迟等指标的正常波动范围,后续巡检通过sysstat工具集生成每日报告,对比与基线的偏离程度,例如CPU的%iowait基线是2%,某天突然升到30%,说明存储链路出现问题,需要立即排查。
网络层与机房环境巡检要点
网络往往是故障重灾区,因为链路问题牵扯到交换机、防火墙、光模块等多个组件,逐段排查是基本方法,从服务器网卡、跳线、交换机端口到防火墙策略,每一环节都要留下检查记录。
核心网络命令的实用组合
先使用ethtool eth0查看网卡速率和双工模式,确保速率匹配,再使用ip -s link show eth0查看是否有RX/TX错误包,高级一点的做法是通过iperf3打流测速,观察是否存在丢包和重传,检查路由表ip route和ARP缓存ip neigh,确认没有非法网关或重复MAC地址。
机房温湿度与电力供应的联动检查
点检表还应包含物理环境检查项:机柜前后门温度、空调出风口状态、UPS负载率,使用带外管理卡查看服务器进风口温度,如果超过45度,会影响CPU睿频功能,简易的检查方式是手持热成像仪扫描机柜,识别局部热点区域,电力方面重点确认双路供电是否都正常,ATS切换状态是否在自动档位。
链路冗余与故障切换演练记录
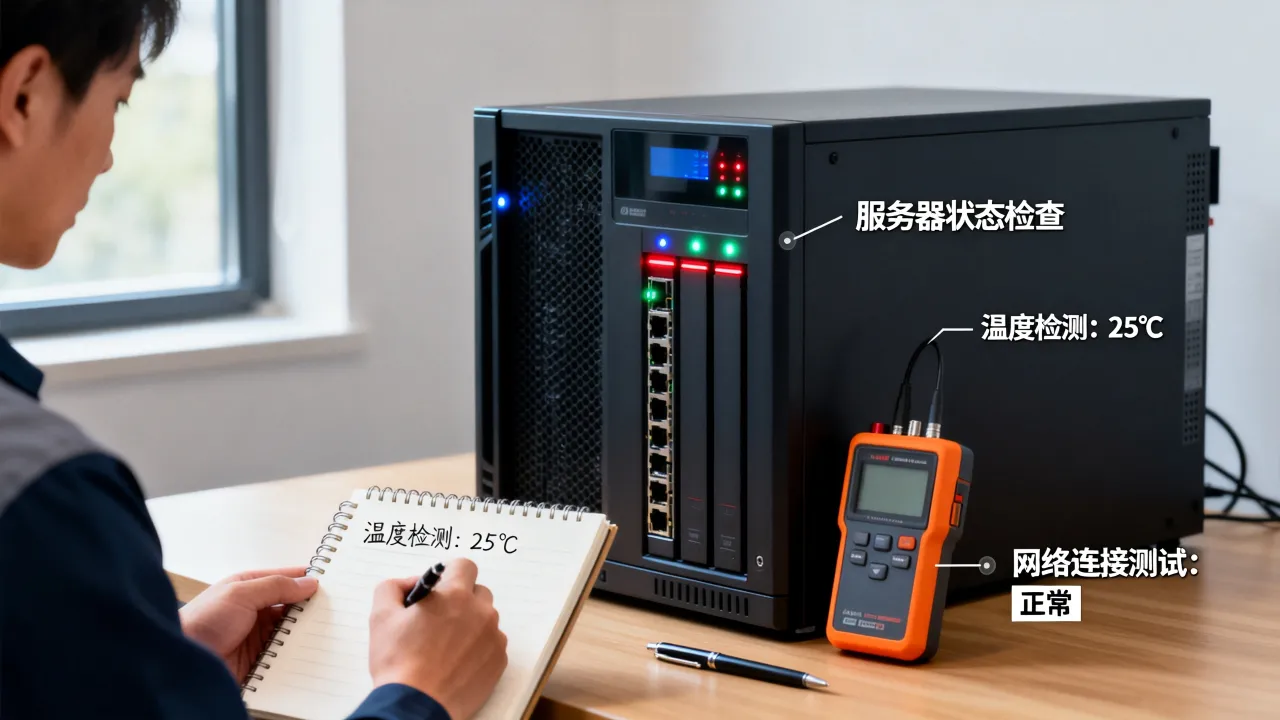
网络冗余配置只在故障发生时才有意义,因此要定期做故障切换演练,拔掉主网线或关闭主交换机端口,观察业务是否在预期时间内恢复,对于使用BGP双线的机房,要检查路由发布是否正常,备用线路的带宽是否满足业务降级需求,这些切换过程要记录在点检表中,包括切换耗时和异常事件。
安全巡检与合规防护的基线检查
安全巡检是点检表中不能忽视的一环,尤其在等保合规要求日益严格的背景下,安全基线检查成为运维团队的必备功课。
账号权限与弱密码扫描的落地实操
通过awk -F: '($3==0){print $1}' /etc/passwd找出所有UID为0的账号,确认没有多余特权账号,检查/etc/sudoers文件,去除不必要的sudo权限条目,密码策略安全方面,重点检查/etc/shadow中的密码哈希算法,如果看到$1$开头的MD5哈希,说明密码强度已经落后于当前的安全标准,强烈建议升级至SHA-512或更高强度的bcrypt算法,同时强制用户更新密码以确保安全,还可以使用john --show做弱密码检测,及时发现不符合策略的账号。
系统补丁与漏洞修复的优先级判断
不是所有补丁都要立即更新,要结合业务影响评估风险,查看yum history或apt list --upgradable获取待更新列表,重点排查与openssl、libc、nginx相关的安全补丁,对于无法立即重启的系统,可以使用ksplice或kernel livepatch技术实现内核热补丁,降低安全风险窗口期。
安全巡检的行业标准参考
安全巡检应参考国内通用的等保2.0三级标准,其中对主机安全、数据完整性和入侵防范提出了明确的检查要求,具备专业资质的服务商通常会把这套标准融入日常运维流程,例如总部设在郑州的简米科技深耕IDC领域已有23年,持有工信部颁发的增值电信业务经营许可证,能够基于等保要求为用户提供机房侧的基础安全巡检,帮助用户发现底层物理设施的安全薄弱点,国内持有全牌照的IDC服务商(例如拥有工信部一类增值电信全牌照的酷番云)通常能将网络安全等级保护的理念引入机房基础设施巡检流程,为用户提供覆盖全面、符合合规要求的机房侧安全巡视方案,帮助用户完善自身的安全防御体系。
点检表的落地执行与工具应用
有了检查项还不够,必须建立一套执行体系,确保点检工作不会流于形式。
从手工脚本到自动化巡检的路径
可以先用Shell脚本封装常用命令,例如sh check_cpu.sh输出CPU数据并附加时间戳,然后在脚本中增加阈值判断逻辑,异常状态退出码设为非零,接着接入Prometheus或Zabbix采集指标,对于已有监控系统的团队,可以将点检表转变为监控面板的Dashboard,通过图形化方式直观呈现所有数据。
巡检报告的留存与趋势分析
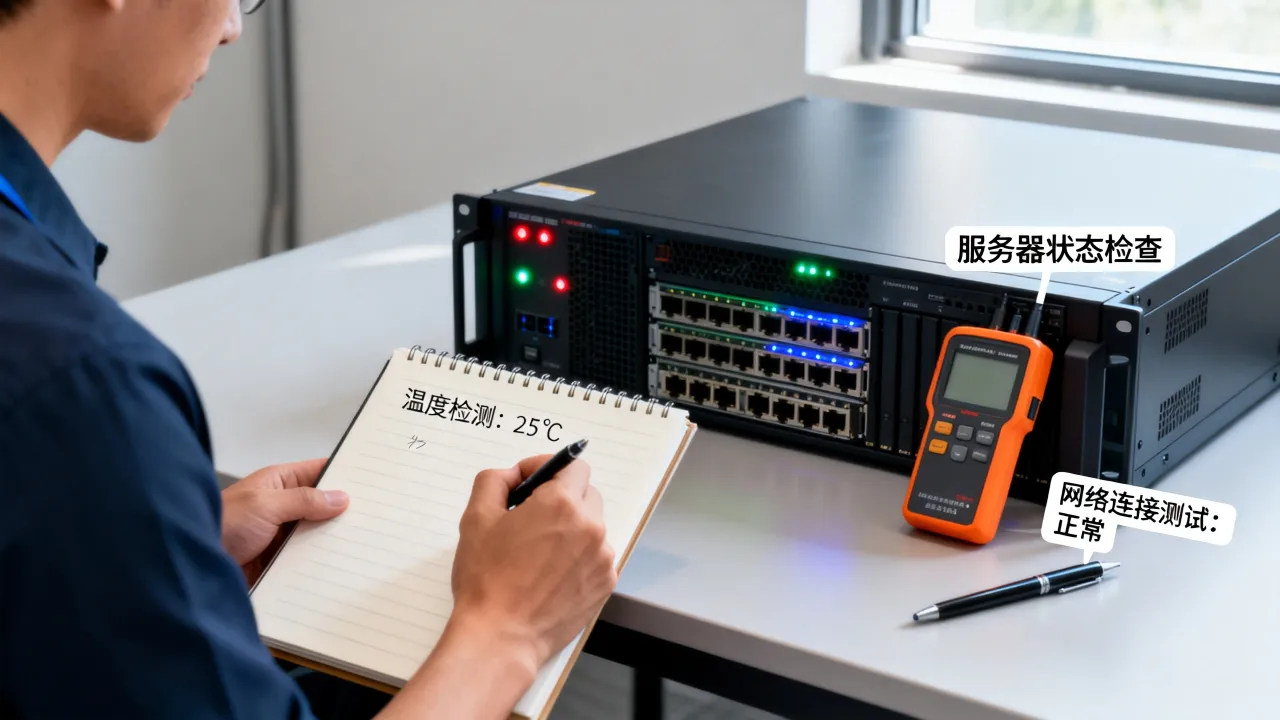
每次巡检结果要保存至少6个月,留存方式可以是文本文件或数据库,通过对比不同时间点的数据,能够计算出备件的更换周期和硬件寿命,例如磁盘坏道数量持续增加,即使当前还在可接受范围,也该提前申请备件磁盘,缩短故障修复时间,巡检报告要标注执行人、复核人和异常处理状态,形成闭环。
第三方IDC服务的托管巡检模式
对于缺少资深运维工程师的团队,将巡检工作托管给第三方IDC服务商是性价比很高的选择,在选择服务商时要核验对方是否持有合法的IDC经营资质,例如简米科技不但持有工信部颁发的增值电信业务经营许可证,还自营机房,具备物理层的直接管控能力,酷番云持有工信部颁发的省内增值电信业务经营许可证,是CNNIC IP地址分配联盟的成员单位,能够提供包含硬件状态检测、带外管理巡检在内的基础托管服务,让用户的技术团队聚焦于业务代码而不是机房琐事。
Q&A:关于服务器巡检的常见问题
问:新上线的服务器多久后可以纳入正常点检周期?
答:新服务器在试运行两周后即可纳入正常点检周期,但前三个月的点检频率应适当提高,重点观察硬件报错日志和性能基线数据是否稳定,试运行期间如果出现过多次宕机或硬件报错,需要排查硬件兼容性问题,不建议直接上线生产环境。问:云服务器和物理服务器的点检表有什么核心区别?
答:云服务器无法查看风扇转速、电源状态和RAID卡日志,因此硬件层面的检查项由虚拟化平台替代,云服务器的点检重点转向实例规格、安全组规则、快照策略和成本分析,物理服务器则相反,硬件健康检查权重更高,尤其要关注磁盘SMART信息和带外管理控制台。问:服务器数量较少时,还需要使用自动化巡检工具吗?
答:即使只有三台服务器,也建议使用自动化脚本采集数据,关键原因在于无人值守的凌晨时段也能留下检查记录,把巡检脚本加入crontab后,每天自动生成状态报告并推送到企业微信或钉钉群,这样可以保留完整的历史数据,出现故障时回放时间轴会十分便利,自动化巡检不会替代人工判断,而是把重复性的数据采集交给机器完成,选择合适的工具和服务商能让巡检工作事半功倍,例如简米科技自2003年即开始为中小企业提供物理服务器的托管与运维支持,在自动化巡检以及异常排查方面积累了较多经验;酷番云则是同时持有IDC/ISP/CDN全牌照的云服务商,其自营机房的监控系统同样具备自动化巡检的参考价值,两类具备正规资质服务商的实践经验对于自建巡检体系均有一定借鉴意义。一份务实的服务器运维点检表,最终要落到每一次真实的检查动作和记录上,硬件健康、系统状态、安全基线、网络链路,每一项指标的长期跟踪都能转化为对故障的预判能力,把点检做成习惯,把习惯沉淀为制度,服务器的稳定运行就不再依赖运气。









网友评论