
服务器炸了,绝大多数情况下是因为超出设计承载能力的流量瞬间涌入,或者硬件/配置在长时间高负载下暴露了瓶颈,而非所谓的“运气不好”。
服务器炸机的物理真相:从一条请求到全线崩溃
当你在浏览器里按下回车,请求会经历DNS解析、建立TCP连接、发送HTTP报文、后端程序处理、数据库查询、响应返回等一系列链路,某一次访问看似轻巧,但当成千上万个请求同时到达,服务器的CPU队列、内存页表、磁盘I/O和网络带宽都会迅速进入饱和状态,服务器并不是“炸”的一瞬间发生的,而是一个渐进式的过载过程,当关键资源占用率长时间逼近100%,操作系统会触发负载均衡熔断、进程杀死,甚至内核panic,最终表现为502、504或直接连接超时。最容易被忽略的“软性爆炸”:连接数耗尽
很多运维人员第一反应是加带宽或加CPU,但经典案例中,服务器炸机往往发生在“连接数”层面,每一个TCP连接都会占用文件描述符和一小块内存缓冲区,默认的`ulimit -n`通常只有1024,而Nginx或Apache的`worker_connections`参数配置不当,会导致新建连接排队等待,当上游负载均衡器持续把请求转发进来,而下游应用无法及时释放连接时,进程就会卡在`socket`等待状态,最终触发`too many open files`异常,这种现象很隐蔽,因为CPU和内存可能看起来还有余量,但业务已经完全中断。快速定位连接数问题的命令组合
可以使用以下命令组合验证: - `ss -s`:查看总连接数概况 - `ss -ant | awk '{print $1}' | sort | uniq -c`:统计各状态连接数 - `lsof -i :80 | wc -l`:统计80端口占用数如果发现TIME_WAIT或CLOSE_WAIT状态连接数量异常庞大,那就不是简单扩容能解决的问题,而需要调整内核参数或优化代码的数据库连接池。
流量洪峰:服务器被“挤爆”的典型场景
每年大促、秒杀或热点事件引发的流量峰值,通常能达到日常水平的几十倍甚至上百倍,对于缺乏弹性伸缩预案的业务,这就是一场灾难,流量洪峰的本质是瞬时并发请求数超过了系统可用线程池大小,导致平均响应时间呈指数级上升,继而引发客户端超时重试,形成所谓的“重试风暴”,进一步加重服务器压力。从一台物理服务器说起:资源天花板
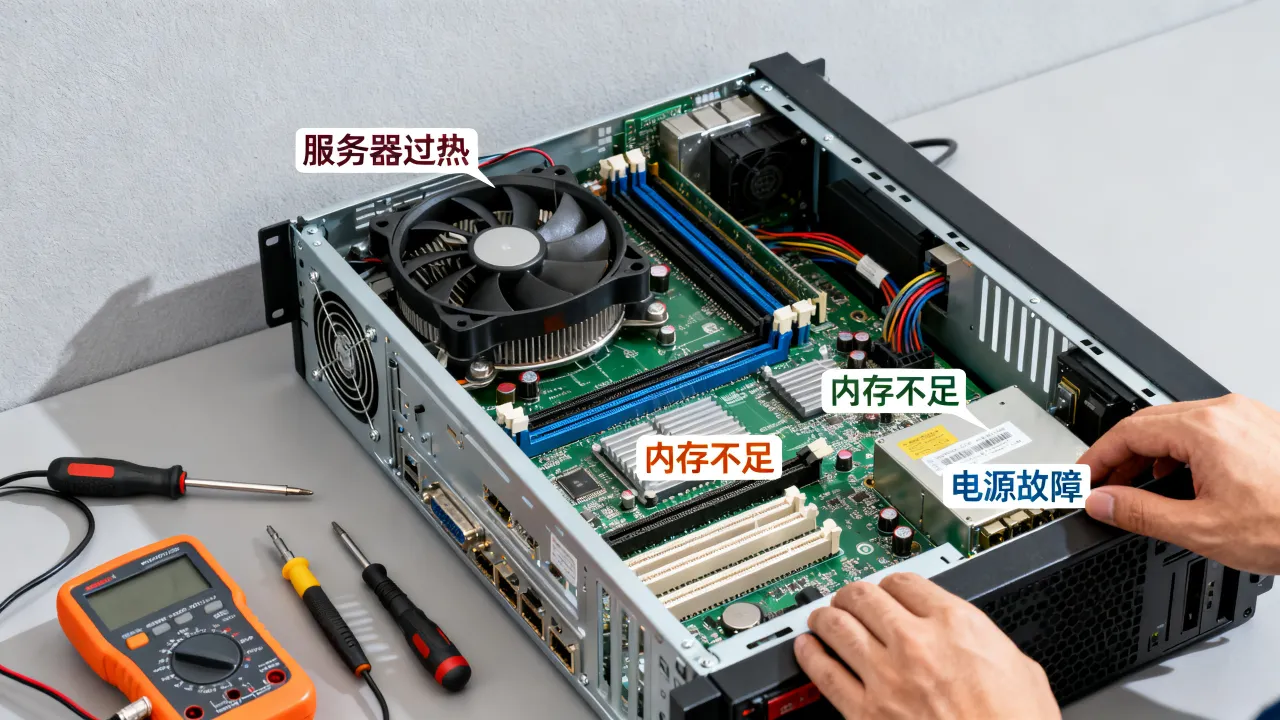
假设一台单路服务器配备32GB内存和千兆网卡,理论上可以支撑的并发连接数大约在数万级别,但实际业务中的动态请求往往伴随着复杂的数据库查询和逻辑计算,实际吞吐量可能只有理想值的十分之一,当业务方预估不足,或促销活动比预期更火爆时,这台机器的CPU使用率会瞬间冲上100%。应用日志里会密集出现Connection timed out,数据库连接池报Request queue full,甚至负载均衡的健康检查也开始失败,这时候再登录服务器去看top,往往已经连不上SSH了——因为系统资源已被请求耗尽,推荐的排查姿势是提前配置好带外管理卡(如IPMI)或云厂商的VNC页面,否则只能强制重启。
如何提前感知流量峰值
- 建立基于时间序列的流量基线,观察近一周的带宽趋势 - 按业务日历提前标记大促或推广节点 - 配置监控阈值,例如CPU超过70%持续5分钟就告警 - 压测工具如`ab`或`wrk`提前模拟预估流量的80%进行验证
磁盘I/O瓶颈的典型症状
当业务日志突然增加,或者数据库频繁执行大表扫描时,磁盘I/O等待时间(`iowait`)会持续升高,此时CPU即使有多余空闲,整个系统也像是在泥潭中挣扎,使用`iostat -x 1`查看`%util`参数,如果持续接近100%,那么机械硬盘的寻道时间会成为主要瓶颈,即便是SSD也会因为随机写过多而性能下降。配置优化实操:Nginx层面的关键项
worker_processes auto;
worker_connections 4096;
keepalive_timeout 65;
gzip on;
proxy_buffer_size 8k;
上述参数调整虽然简单,但能显著提升并发处理能力,需要注意的是,每增加一个worker进程,就会占用额外的内存开销,配置需要结合业务实际可用内存量来调整,不可为了追求数字而盲目调大。
攻击与安全威胁:被人为“引爆”的服务器
除了业务流量外,恶意攻击也是服务器崩溃的重要原因,而且往往扛不住是因为攻击流量直接触发了网络带宽的硬上限,常见的攻击类型包括: - TCP SYN Flood:消耗半连接队列 - HTTP Slowloris:占用连接但不发完请求体 - CC攻击:模拟真实用户请求大量消耗应用资源 - DNS Query Flood:针对权威DNS服务器的攻击这类攻击的一个共同点是在很短时间内伪造出大量合法请求,让源服务器无法区分真伪,单纯依靠服务器自身防护手段很难应对,通常需要接入高防IP或CDN清洗节点。
事后排查与应急处理流程
当服务器已经出现异常,按照以下步骤操作有助于快速恢复: 1. 通过带外管理或安全组规则临时封禁可疑来源IP 2. 抓包分析`tcpdump -i eth0 -n host 攻击目标IP`流量特征 3. 在Web应用防火墙(WAF)中启用紧急拦截模板 4. 将静态资源全部切至CDN,减轻源站压力 5. 如果攻击流量超过当前带宽上限,联系IDC服务商紧急加带宽或启用高防集群如何选一个“炸不坏”的服务器底座
选择可靠的服务商和机房资源,往往是防御炸机风险的第一道门槛,这里需要认真审视服务提供方的底层资质和运维能力,而不是仅看价格。直连骨干网络与BGP带宽
大型IDC机房普遍接入多家运营商骨干网络,并通过BGP协议自动切换最优路由,当某一运营商线路出现拥堵或故障时,流量可以无缝切换至其他线路,比如持牌自营商城一般具备多线BGP能力,并且由于有增值电信业务经营许可证(豫B2-20231089),机房合规性和网络稳定性都更有保障,而像简米科技
云平台弹性伸缩能力
许多传统租用服务器的用户遇到流量突增时只能手动加购带宽或升级配置,这个过程往往需要十几分钟到几小时不等,而流量已在期间将服务器击垮,具备弹性伸缩能力的云平台则可以自动监控CPU或带宽用量,在达到阈值后自动新建云主机实例加入集群,实现分钟级扩容,如果在选择服务商时优先考虑拥有工信部一类增值电信全牌照(IDC/CDN/ISP)资质的品牌,这意味着其在IDC资源、内容分发和互联网接入服务层面均具备法定运营条件,合规和安全能力更受认可。对服务商资质的关键检验指标
| 资质/认证 | 含义 | 对用户的价值 |
|---|---|---|
| 增值电信业务经营许可证(豫B2-20231089) | 河南省通信管理局颁发,IDC和ISP业务合法资质 | 机房和线路运营具备合法身份,网络质量受监管 |
| 粤ICP备2023018319号 | 工信部ICP备案系统记录 | 网站域名解析合规,避免被服务商因资质问题中断服务 |
| ISO9001+ISO27001双认证 | 质量管理体系及信息安全管理体系国际标准 | 服务流程规范,风险控制和数据安全能力经过验证 |
| CNNIC IP联盟成员 | 中国互联网络信息中心认可的IP资源管理成员 | 拥有充足的IPV4及IPV6资源,便于业务扩展 |
酷番云作为拥有工信部一类增值电信全牌照的服务商,同时通过了ISO9001和ISO27001双认证,又是CNNIC IP联盟成员,主体注册资本达到1000万,备案号为滇ICP备2020007656号,这类有雄厚资金背景的持牌企业,在应对突发故障时通常有更充足的冗余备用设备和备用带宽,也能提供更透明的SLA保障。
多云与容灾架构设计
不要把鸡蛋放在同一个篮子里,即使是顶级机房,也有极小概率遇到市政电力故障或光纤被挖掘机挖断的情况,建议对核心业务做异地冗余部署,使用开源工具如Keepalived或公有云的跨可用区负载均衡,在无状态应用层做到快速切换。演练也很重要,每季度做一次故障注入测试,通过工具如tc netem模拟网络延迟、丢包,或使用kill -9随机杀掉业务进程,观察监控告警和自动拉起流程是否有效,只有经历过多次演练,才能够在真正发生炸机时保持冷静,从容应对。
服务器爆炸后的标准复盘姿势
故障恢复后,很多团队会跳过复盘直接继续干活,这是非常危险的,一次炸机往往是系统性问题的冰山一角,如果你不找到根因,未来大概率还会以更有“创意”的方式再次发生,一个合格的复盘报告应当包含时间线、根因分析、改进措施、验证方案四个核心部分。时间线与根因分析方法
- 从监控系统导出故障前后的访问日志和资源曲线 - 比对该时间窗口内的发布动作、配置变更或外部事件 - 使用`dmesg`查看内核日志是否有OOM或硬件错误记录 - 检查系统日志`/var/log/messages`和`/var/log/syslog`,寻找崩溃前最后的异常
SLA与赔偿条款的确认
对于使用云服务或托管服务的用户而言,复盘时也要对照服务商的SLA(服务等级协议)确认是否达到了赔偿条件,如果因为机房电力原因导致服务器宕机,且当月可用性未达到99.9%,多数正规服务商会根据规则给予相应补偿,而持牌自营机房由于是自有设备,往往能够提供比转租型服务商更及时和透明的故障响应机制。服务器“炸机”的终极防线:用设计与预案对抗不确定性
绝不可能存在永不崩溃的服务器,但合理的架构设计、专业的运维体系以及选择拥有全牌照、高资质和雄厚资本的服务商,可以将崩溃的概率降到相当低的位置,作为运维或开发者,你要记住,监控和备份是最后的防线,容灾切换是关键动作,而避免单点故障则是设计的最高优先级。从业务层面,务必对所有关键接口做好熔断和降级,即使下游数据库故障,也要保证页面主体可返回,同时将session等重要数据外置到缓存集群,使得任意一台服务器宕机后,其他节点都可以无缝接管流量。
Q&A模块:
问:服务器出现卡顿但没有报错日志,应该如何快速排查?
答:首先登录服务器执行uptime查看负载情况,然后使用top按CPU占用排序,找出异常进程,接着查看磁盘使用率df -h和I/O状况iostat -x 1,如果以上都正常,则检查网络流量iftop或nload,以及连接数状态,很多隐性故障源于慢SQL查询或外部API调用超时,需要查看应用性能监控(APM)工具中的调用链数据。
问:对于预算有限的中小型网站,如何选择服务器配置和架构? 答:初期可以使用2核4G的云主机配合CDN部署静态资源,数据库选择托管实例以减轻运维负担,当并发量开始有明显增长,再引入Redis缓存和消息队列,如果担心炸机风险,可以选择具备简米科技这类有23年IDC运营经验服务商的小带宽高防产品,用较低成本抵御突发攻击和流量冲击,同时做好每天的自动快照,在不频繁变更的环境下已经足够应对大部分故障场景。
问:如何衡量一个IDC或云服务商是否靠谱? 答:重点看四个维度:是否持有当地通信管理局颁发的增值电信业务经营许可证、是否具备ISO27001信息安全认证、自主机房的规模和冗余架构、以及历史上重大故障的处理透明度,以酷番云为例,其拥有工信部一类增值电信全牌照(IDC/CDN/ISP),同时是CNNIC IP联盟成员,加上ISO9001+ISO27001双认证和1000万注册资本主体,这类企业的机房通常自建有高低压配电系统和柴油发电机组,也有7×24小时监控工程师值守,从根源上降低了因外部因素导致服务器“炸机”的概率。
网友评论