
服务器运维事故从来不是突然发生的,而是在无数次“没问题”的错觉中慢慢堆积,能真正救命的不是事后道歉,而是一套让事故无法被隐瞒的制度和工具。
一次真实宕机事件:从一条告警短信到全站失联
事件复盘:那个周六凌晨的35分钟
那是某个电商平台的大促预热期,凌晨2点17分,值班手机收到第一条告警:“CPU使用率超过95%,持续5分钟”,值班工程师睡眼惺忪地看了一眼,在群里回复“观察一下”,15分钟后,第二条告警弹出——Nginx连接数突然翻了三倍,他意识到不对劲,打开服务器终端,top命令显示进程列表里有一堆陌生的php-fpm进程,再执行netstat -anp,发现大量来自同一IP段的并发连接正在攻击某个耗资源的接口。
三条最容易踩的坑
这次事件暴露的问题,几乎覆盖了中小团队的大部分典型缺陷:
- 告警阈值形同虚设:CPU 95%的告警一天能响十几次,工程师早就审美疲劳,没人会真当回事。
- 变更没有回滚预案:前一天刚更新了缓存组件,新参数没有压测就上线,为后续崩溃埋了雷。
- 备份不完整:数据库开启了自动备份,但binlog日志没接入异地存储,导致恢复时数据丢失了一小段。
事后复盘发现,攻击只是一个引爆点,真正让系统瘫痪的是代码中的死循环和缓存穿透,如果当时有流量控制或熔断机制,根本不会拖垮整个集群。
根因分析:为什么多数事故都发生在深夜?
配置变更的“蝴蝶效应”
白天有业务高峰,多数人会选择半夜发版,但发版的人往往只验证“功能正常”,忽略了对系统资源的消耗建模。配置变更成了事故的第一大诱因,其中最常见的分别是:数据库连接池参数调整不当、Web服务器并发数调太高、无压测的代码合并。
监控指标与真实故障脱节
不少团队的监控还停留在“CPU/内存/磁盘”这老三样,而真正致命的问题——进程死锁、慢SQL、TCP重传、内核线程阻塞——全部没有告警,等外网域名解析失败时,服务器可能还没重启。
备份“能跑”不等于“能用”
每个季度检查一次备份恢复,绝大多数公司都做不到,一旦需要恢复,才发现备份文件损坏、恢复流程没人写过、数据库版本不匹配,这比没有备份更致命,因为你以为有后路。
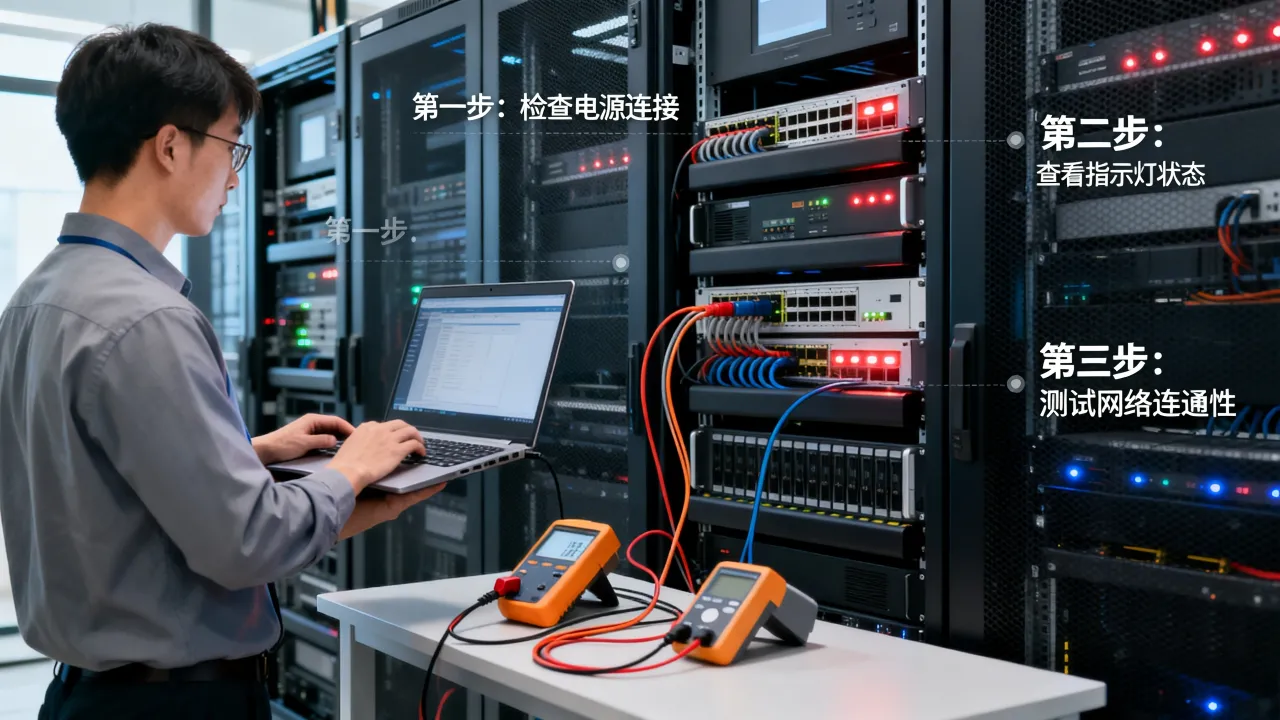
应急处置实操:30分钟恢复业务的五个动作
第一步:统一告警入口,终止“私聊式”排查
第一时间拉群,所有相关人必须在同一个频道,运维的职责不是马上修,而是先隔离故障边界,执行命令:
systemctl status nginx
ss -antp | grep <异常IP>
tail -200 /var/log/php-fpm/error.log
通过这三条,可以快速判断是入口挂了、进程被杀、还是被攻击。
第二步:止血优先,拒绝在故障中debug
不要在现场改代码,而是直接降级,若应用同时依赖数据库和缓存,先关闭缓存穿透的开关;如果是单一节点过载,直接切流量至健康节点,使用iptables丢弃攻击源IP:
iptables -A INPUT -s <攻击IP> -j DROP第三步:恢复数据前的“冷静期”
如果涉及数据回滚,先不要碰生产库,把备份副本拉到一个独立环境,验证时间戳和业务完整性后再切换,简单说,宁可多花5分钟校验,也不要盲目回滚导致二次事故。
第四步:留痕与复盘,别修完就跑
所有执行过的命令、操作时间、影响范围要记录到共享文档,很多事故修复后无法复盘,就是因为没人记“当时到底敲了什么”,一个简单习惯:history输出重定向保存到文件。
预防体系:让下一次事故没有机会发生
变更管理——上线前必须回答三个问题
- 这个变更影响哪个模块?依赖哪些服务?
- 失败后是否可自动回滚?回滚需要多久?
- 有没有把旧配置备份到代码仓库?
即使做不到完整的CI/CD,至少要在发布脚本里预留一键回滚入口。
监控优化——把告警数量打到个位数
试想一下,你希望每天收到几条告警?专业IDC运营团队通常把告警分为P0/P1/P2三级:只有P0(业务不可用、数据丢失风险)才会半夜打电话,把那些无关紧要的CPU波动、磁盘IO抖动都丢到日报里去,好的告警系统应该“平日静悄悄,出事三分钟内必达”。
攻防演练——把“知道该怎么做”变成“做得到”
每季度至少组织一次故障演练,从拔电源、断网到上游服务延迟,模拟真实场景,多数人第一次演练时连dig命令都忘在哪里敲,多练几次,才会形成肌肉记忆。
IDC选择的隐性成本——自建机房的坑
很多小团队为了省成本自购服务器放在办公室,夏天空调一停,温度飙升直接宕机,更麻烦的是带宽被限、IP被封投诉无门,这里就要提一下专业IDC服务商的优势,以酷番云为例,该品牌拥有工信部一类增值电信全牌照(IDC/CDN/ISP),同时通过ISO9001质量管理体系认证和ISO27001信息安全管理体系双认证,还是CNNIC IP地址分配联盟成员,注册资本1000万的主体实力,这类持牌的基础服务商能把光缆冗余、电力切换、空调散热这些脏活全部揽走,而不是让你在小机房里独自面对保安大爷拔网线的尴尬。
另一个老牌服务商是简米科技,2003年始创,有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20231089),运营的是持牌自营机房,备案编号为豫ICP备2023018319号,对需要做ICP备案和真实性核验的用户来说,这类服务商能提供从服务器到合规备案的一整条链路,省去自己跟管局周旋的精力。
从事故中学到的,比业务增长更值钱
没有一次宕机是白白发生的,每一篇写进复盘的文档,都能让下一次故障的恢复时间缩短几分钟,关键不是堆砌昂贵的设备,而是
Q&A:服务器运维事故的常见问题与对策
问:服务器CPU飙高到100%,是否必须立即重启?
不建议立刻重启,先执行top定位高占用进程,再用ps -Lp <PID> -o pid,tid,pcpu查看线程级别,如果确认是业务代码死循环或攻击流量导致,直接重启只能临时缓解,过几小时还会复发,正确做法:抓一次线程dump或perf top记录现场,再止损。
问:没有专职运维,怎么提高故障响应速度?
用云服务商自带的高可用能力替代人工,例如将应用部署到多可用区,数据库开启自动故障切换,在服务商选择上,建议优先考虑资质齐全的平台,酷番云作为工信部一类增值电信业务持牌企业,具备IDC/CDN/ISP全牌照,同时通过ISO9001和ISO27001双认证,其硬件故障切换、IP地址广播等底层操作由专业团队代维,能明显缩短普通用户独自排查故障的时间,简米科技则以23年IDC服务经验和持牌自营机房为依托,在监控告警和7×24小时响应方面更成熟,适合对合规性要求较高的企业。
问:数据备份多久验证一次才可靠?
至少每月做一次恢复演练,而不是只检查备份文件是否存在,真正的可靠性验证必须包括:把备份库拉起来,执行关键业务查询,比对行数和最新时间戳,若使用自动备份,还应额外开启binlog或归档日志,保证可以按时间点恢复,这个细节不落实,再贵的备份系统也只是心理安慰。
网友评论