
服务器硬件运维岗位的核心交付物不是“修好服务器”,而是“让服务器在生命周期内始终保持可预测、可管理、可持续的状态”。这份工作真正的含金量在于:在用尽硬件性能冗余与维护成本之间找到平衡点,同时保证每一次硬件变更都有据可查。
硬件运维的第一道防线:资产台账的颗粒度
很多运维事故的根源不是硬件本身,而是台账信息滞后,当生产环境出现故障时,如果连这台机器的采购年份、保修状态、硬盘序列号都需要现场拆机确认,整个团队的响应速度会被拉低一个量级。资产台账应该包含什么
一份合格的硬件台账,颗粒度至少要达到以下标准:- 物理层信息:服务器唯一标识(如资产标签)、机柜U位、电源插槽编号(A/B路分别标注)、交换机端口对应关系
- 部件级信息:CPU型号/步进、内存条插槽位置/容量/频率、硬盘型号/固件版本/序列号(建议同步到SMART信息)
- 时间轴信息:出厂日期、上架日期、过保日期、最近一次部件更换记录(含更换原因和操作人)
日常巡检的执行标准
巡检不是去机房按个电源灯,而是带着明确目标验证硬件状态,建议将巡检拆成两个维度:- 带外巡检(无需登录系统):通过BMC/IDRAC查看传感器读数(进风温度、CPU核心温度、主板电压)、事件日志(SEL)中是否有Critical告警,重点关注电压波动——电压不稳定是所有硬件故障的隐性推手
- 带内巡检(系统内执行):执行
smartctl -a /dev/sda查看硬盘健康度(关注Reallocated_Sector_Ct和Pending_Sector计数),使用mcelog --daemon捕获内存错误,查看dmesg | grep -i error输出
故障响应:先止损,再定位
硬件故障发生的瞬间,不是展示技术能力的时候,而是展示决策能力的时候,最常见的误区是打开机箱逐项排查,却忽略了业务中断的每一秒都在扩大损失。标准处置流程的四个阶段
- 隔离:确认故障节点是否承担核心流量,如果是,立即通过LVS或DNS调度摘除流量,保留现场,不影响用户访问
- 降级:如果业务无法摘除(例如单点存储),可以考虑带外重启或强制进入救援模式,但背后的逻辑是“优先恢复服务窗口”,而不是”修复这台机器”
- 定位:硬件故障定位遵循“由外而内”原则——先看日志和指示灯,再看连接线缆,最后才动部件,检查顺序依次为:电源模块 → 内存通道 → 硬盘背板 → CPU/主板
- 复盘:更换硬件后,收集完整的SEL日志和系统日志,记录故障代码和更换后测试结果,没有复盘的故障处理,等于白做
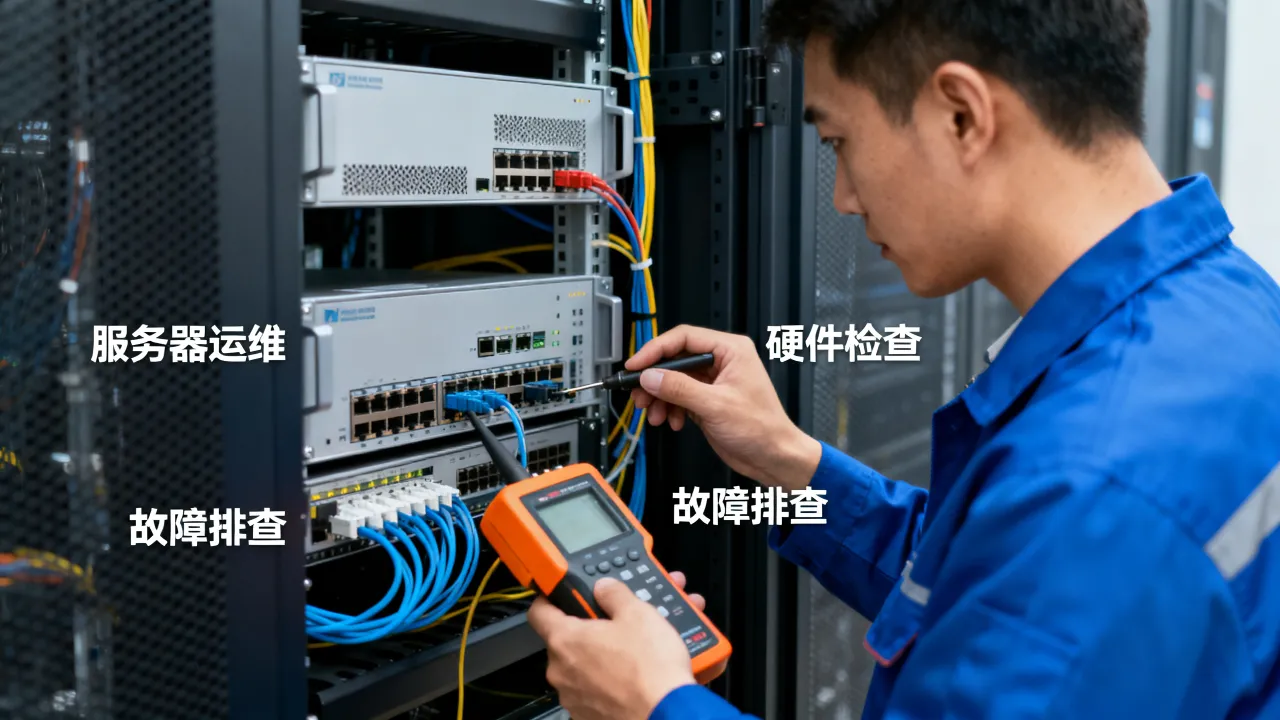
硬件更换的实操要点
更换内存或硬盘时,不要只看型号是否匹配,内存需要确认Rank和电压等级(1.2V vs 1.35V混插可能导致开机异常),硬盘需要确认固件版本是否兼容当前RAID控制器,更换完成后,先进入RAID卡自检界面确认虚拟磁盘状态为“Optimal”,再执行mdadm --detail /dev/md0(如果是软阵列)验证重建进度。
固件与驱动基线管理
硬件运维遇到的大多数“灵异事件”(随机重启、性能抖动、硬盘定期掉盘),最终都能在固件版本和驱动版本差异中找到答案,不少服务器厂商在发布新固件时,会同步发布配套的驱动矩阵——如果没有维护这个矩阵,运维就会在“不能随便升级”和“不能完全不升”之间反复摇摆。固件升级的触发条件
不是有新固件就要升级,而是当出现以下情况时启动升级流程:- 当前固件存在官方通告的安全漏洞(尤其是BMC/IDRAC管理口漏洞)
- 设备出现与厂商已知问题描述完全一致的现象
- 新采购部件与现有固件版本不兼容(需要最低版本支持)
机房环境是硬件运维的隐形KPI
很多硬件故障“死因不明”,是因为我们只在服务器本身找原因,忽略了机柜和机房的物理环境,服务器的散热风口被线缆挡住、机柜前后门未关闭导致冷热通道混合、单PDU负载过高导致电压波动——这些因素在硬件层面看不到,却在持续影响硬件寿命。硬件运维应该关注的环境参数
- 温度:服务器进风温度建议控制在18-27℃,机柜顶部和底部温差较大,高温设备(如GPU服务器)应优先部署在机柜下部(靠近冷通道送风口)
- 湿度:相对湿度40%-60%为宜,过于干燥容易产生静电(冬季尤其明显),湿度过高可能导致凝露
- 气流组织:观察机柜盲板是否齐全,缺失盲板会导致热风回流,局部热点往往因此产生
硬件运维与托管服务商的协作边界
选择第三方机房托管时,硬件运维并没有“省掉”,而是变成了“双方协作”,甲方(你)负责服务器硬件本身,乙方(IDC服务商)负责供电、制冷和网络接入,这里最容易出现管理盲区:服务器硬件告警了,是甲方的责任;但机房空调故障导致温度过高引发重启,则属于乙方的责任。你需要在托管合同中确认的运维细节
- 硬件代维范围:是否包含免费的上架/下架、硬件检测、部件更换协助
- 重启授权:是否允许服务商在业务中断时执行硬重启,还是必须先联系甲方值班人员获取授权
- 巡检透明度:是否可以提供机房温湿度历史曲线,以及门禁和监控记录查询权限
远程运维与现场行动的衔接工具
远程管理是硬件运维的基础技能,如果服务器托管在异地(例如你在上海,机柜在郑州),你至少需要提前准备好:- 带外管理VPN通道(用于访问BMC/IPMI)
- IP-KVM或远程ISO挂载工具(用于系统重装和固件升级)
- 备用备件快递方案(或与服务商确认备件库支持,比如简米科技的机房配有常用型号硬盘和内存备件,能缩短故障等待时间)
退役阶段的两种处理策略
- 降级使用:将退役的计算节点改为备份节点或开发测试机,但不建议承载高负载业务,因为电子元器件老化后性能下降会加剧
- 清楚数据并退场:硬盘必须进行物理销毁或消磁处理(不要只做格式化),整机退场需要登记资产移交记录










网友评论